Cache-to-Cache: Direct Semantic Communication Between Large Language Models
Status: ICLR 2026
Paper: https://arxiv.org/abs/2510.03215
OpenReview: https://openreview.net/forum?id=LeatkxrBCi
GitHub: https://github.com/thu-nics/C2C
Authors: Tianyu Fu, Zihan Min, Hanling Zhang, Jichao Yan, Guohao Dai, Wanli Ouyang, Yu Wang
一句话总结: Cache-to-Cache(C2C)把多 LLM 协作中的“先让一个模型生成解释文本,再让另一个模型读文本”改成“直接将 Sharer 的 KV Cache 映射并残差融合到 Receiver 的 KV Cache”,从而同时减少中间文本造成的信息压缩和逐 token 解码延迟。
版本说明: 本地最初保存的是 2025 年 10 月的预印本。本文按 2026 年 3 月 2 日的 arXiv v2 / ICLR 2026 录用版重新核对。录用版摘要中的总体结果为:相对单模型平均准确率提高 6.4%–14.2%,相对 Text-to-Text 提高 3.1%–5.4%,平均延迟加速 2.5 倍。旧版摘要中的 8.5%–10.5%、3.0%–5.0% 和 2.0 倍不再作为本文的最终总括数字。
Abstract
多模型系统希望把不同 LLM 的能力组合起来:代码模型理解程序结构,数学模型提供推导能力,通用模型负责遵循指令和组织答案。常规做法是让前一个模型把自己的理解写成文本,再交给后一个模型。这个接口通用、可读,却有两个结构性问题:
- 高维内部表示必须先压缩成一串离散 token,部分语义、位置关系和不确定性会丢失;
- 中间消息必须自回归地逐 token 生成,通信延迟会随消息长度增长。
C2C 把 Transformer 推理时已经产生的 KV Cache 当作通信载体。Sharer 和 Receiver 分别对同一输入进行 prefill,轻量的 Cache Fuser 对齐两边的 token 和层,将 Sharer Cache 投影到 Receiver 的表示空间,经过输入相关的 head 权重和逐层二值门控后,残差加入 Receiver Cache。两个 LLM 本体保持冻结,只训练 Fuser。
论文先用两个 oracle 实验回答“Cache 是否值得传”和“跨模型 Cache 是否能转换”,再在不同模型家族、规模、专业领域和训练阶段上验证 C2C。结果说明:
- 同样长度的 Cache 仅因编码语义更丰富,就能把准确率从 58.42% 提高到 62.34%;
- 不同模型的 Cache 分布差异很大,但一个小型 MLP 可以把源 Cache 映射进目标表示空间;
- C2C 在主要实验中同时优于 Receiver、Sharer、Query Routing 和 T2T;
- T2T 的主要额外成本来自 Sharer 串行生成通信文本,而 C2C 用并行 Cache 融合替代这段解码;
- C2C 不是无条件增益:弱 Sharer 的错误表示也可能污染强 Receiver,而且每个模型对都需要适配器,规模化训练仍是开放问题。

1. Background: LLM 之间为什么需要通信?
1.1 单模型、路由与协作不是同一件事
设系统中有一个数学模型、一个代码模型和一个通用对话模型,面对“分析一段数值程序并解释算法复杂度”的请求时,有三种典型方案:
- 单模型: 只调用一个模型,系统简单,但能力上限受该模型限制;
- 路由: 先判断请求更像数学还是代码,再选择其中一个模型;它减少成本,却没有把多个模型的知识合在同一次回答里;
- 协作: 让多个模型读取问题并交换理解,最终由某个模型输出答案。
C2C 研究的是第三种。它并不是“挑一个更合适的模型”,而是让 Receiver 在生成答案时实际使用 Sharer 对同一上下文形成的内部表示。
1.2 Text-to-Text 通信如何工作?
传统 T2T 流程可以写成:
输入 X
 ├─→ Sharer 读取 X
 │      ↓ 自回归生成
 │   中间分析文本 M
 │
 └─→ Receiver 读取 [X; M]
        ↓
      最终答案 Y
概率分解为:
$$ p(M,Y\mid X) {}={} p(M\mid X)\, p(Y\mid X,M). $$这个接口的优势很明显:不要求两个模型结构相同,也便于人类审计中间消息。但中间文本 \(M\) 同时也是通信瓶颈:
- Sharer 知道的内容不一定能用短句完整表达;
- 错误、歧义或格式偏差会被 Receiver 当成新上下文;
- 生成 \(M\) 必须执行多次串行 decode;
- Receiver 还要重新 prefill 更长的 \([X;M]\)。
1.3 Prefill、Decode 与 KV Cache
自回归 Transformer 推理分为两个阶段。
Prefill 一次并行读取完整输入,计算各层注意力中的 Key 和 Value。设输入为
$$ X_{0:n}=[x_0,x_1,\ldots,x_{n-1}], $$论文将每个 token 在所有层上的 K/V 表示展平记为 \(c_i\),于是:
$$ \mathcal C(X_{0:n}) {}={} [c_0,c_1,\ldots,c_{n-1}] \in\mathbb R^{n\times d}. $$实际实现中 Cache 仍按“层、K/V、head、序列位置、head dimension”保存;上式只是为了简化记号。
Decode 每次只生成一个新 token,并把这个 token 的 K/V 追加到缓存。论文写成:
$$ y_{i+1} {}={} \mathcal P\!\left( y_i\mid \mathcal C(X)\oplus\mathcal C(Y_{0:i}) \right), $$其中 \(\oplus\) 表示沿序列维拼接。KV Cache 避免了每一步重新计算旧 token 的 K/V,却不能消除新 token 之间的因果依赖。
1.4 为什么 Cache 可能比文本更适合通信?
可以把文本看成模型最终决定“说出来”的离散摘要,而 Cache 保留了模型处理每个输入位置时形成的连续表示。它可能包含:
- token 的上下文含义;
- 代码括号、标签或引用对应的精确位置;
- 不同注意力 head 关注的关系;
- 尚未被压缩成一句结论的多种证据。
但 Cache 也不是一种天然通用的“模型语言”。不同模型的 tokenizer、层数、head 数量、head dimension 和表示分布都可能不同。因此,“把 A 的 Cache 直接塞给 B”通常不会工作,C2C 的核心任务正是学习这层翻译。
2. Motivation: 文本丢掉了什么?

论文用一个 Coder–Writer 例子解释信息瓶颈。用户给出一段 HTML,并要求把自我介绍插入正确位置。Coder 的内部表示同时知道:
- p 是段落开始标签;
- 内容应插在 p 开始标签后、结束标签前;
- 该位置处于 section 内。
如果 Coder 只生成一句 “Write content inside the section wrapper”,Writer 可能只理解“写在 section 中”,却不知道 p 标签的结构语义和精确插入点。T2T 中丢失的不是某个关键词,而是词义与输入位置之间的绑定关系。

C2C 希望直接传递 Coder 对原始 HTML 每个位置形成的 Cache 表示。Writer 不必猜测自然语言中的 “inside” 到底指哪个位置,而能从被映射的表示中恢复更细粒度的结构理解。
论文将 T2T 的问题归纳为三点:
- 低带宽: 高维连续表示被压成线性 token 序列;
- 歧义: 自然语言无法保证对位置、结构和隐含关系的唯一表达;
- 高延迟: 每一条中间消息都要逐 token 解码。
不过,这仍只是动机。Cache 是否真的携带“额外有用语义”,以及不同模型的 Cache 能否相互转换,需要由实验验证。
3. Two Oracles: 先验证“值得传”和“能够传”
3.1 Cache Enrichment Oracle:固定长度,只改变表示质量
few-shot prompting 同时改变了两件事:
- 模型看到额外示例;
- KV Cache 变长。
如果准确率提高,无法判断是示例让问题 token 的表示更好,还是 decode 时直接注意到了更多示例 token。作者设计三种设置隔离这两个因素。令 \(E\) 为 few-shot 示例,\(X\) 为待回答问题:
| Setting | Prefill 输入 | Decode 使用的 Cache | Cache 长度 | Accuracy |
|---|---|---|---|---|
| Direct | \(X\) | \(\mathcal C(X)\) | ( | X |
| Few-shot | \(E\oplus X\) | \(\mathcal C(E\oplus X)\) | ( | E |
| Oracle | \(E\oplus X\) | 只保留对应 \(X\) 的切片 | ( | X |
Oracle Cache 定义为:
$$ \mathcal C^{*}(X) {}={} \mathcal C_{[|E|:|E|+|X|]}(E\oplus X). $$关键操作发生在 prefill 之后:模型先让示例 \(E\) 影响问题 \(X\) 的隐藏表示,再删除示例自身对应的 Cache,只保留与问题等长的部分。
Direct 与 Oracle 的 Cache 长度完全相同,但准确率从 58.42% 提高到 62.34%。因此,增益不能只解释为“多看了几个 token”;示例已经改变了模型如何编码问题本身。
3.2 不是每一层都适合被增强
论文在 Qwen3-0.6B 的 28 层中逐层替换 Cache。未增强基线是 58.42%,只有第 4 层和第 16 层略有提升,分别达到 58.52% 和 58.45%;其他单层替换大多下降。
进一步把单层实验中表现最好的层按顺序累积:
- 选择 Top-K 层时,增加若干优质层会继续改善;
- 选择 Last-K,即从最差的层开始增强,准确率明显下降;
- 全部层都替换并不优于精选层。
这直接导出 C2C 的逐层 gate:通信不能理解为“注入越多越好”,模型必须决定哪些层值得接收外部表示。
3.3 Cache Transformation Oracle:跨模型表示是否可转换?
作者用一个三层 MLP,将 Qwen3-4B 最后一层 Cache 映射到 Qwen3-0.6B 最后一层 Cache。训练目标不是回答损失,而是映射后 Cache 与目标 Cache 的均方误差:
$$ \mathcal L_{\text{MSE}} {}={} \left\| f_K(K^{S})-K^{R} \right\|_2^2 {}+{} \left\| f_V(V^{S})-V^{R} \right\|_2^2. $$实验在 MMLU-Redux 上训练,随机选择 300 个样本做 t-SNE,可视化使用 perplexity 50、最多 1000 次迭代。

原始 Source KV 与 Target KV 相距很远;映射后的 Cache 落进 Target 分布内部,说明跨模型转换具有可行性。但它只覆盖 Target 空间的一个子集。这一点很重要:
- 大模型的 Cache 不是小模型 Cache 的超集;
- 参数量更大不代表表示方式完全包含另一个模型;
- 不同模型即使总体准确率相近,正确题集合也可能只有有限重叠。
所以合理目标不是用 Sharer 覆盖 Receiver,而是保留 Receiver 自身表示,再选择性地注入互补信息。
4. Method: Cache-to-Cache 如何工作?
4.1 Sharer、Receiver 与整体流程
- Sharer: 提供对输入的上下文理解或知识;
- Receiver: 使用融合后的表示并生成最终回答;
- Fuser: 在两者之间完成 Cache 映射、融合和选择。
一次推理可以分成五步:
同一输入 X
 ├─→ Sharer prefill  → Sharer KV Cache
 └─→ Receiver prefill → Receiver KV Cache
                 │
       token alignment + layer alignment
                 │
             Cache Fuser
                 │
         Receiver fused KV Cache
                 │
       Receiver 自回归生成最终回答
注意:C2C 消除的是 Sharer 生成中间文本 的过程,不是 Receiver 的最终答案 decode。Sharer 仍需对输入执行一次 prefill,Receiver 也仍需生成最终答案。
4.2 残差式 Cache 融合
设 Receiver 有 \(N\) 个参与融合的层,\(\mathcal G(n)\) 表示 Receiver 第 \(n\) 层对应的 Sharer 层。录用版将融合 Cache 明确写成残差形式:
$$ \mathcal C^{F} {}={} \left\{ \mathcal C_n(X) {}+{} \mathcal F_n\!\left( \mathcal C_n(X), \mathcal C^{S}_{\mathcal G(n)}(X) \right) \right\}_{n=1}^{N}. $$Receiver 自己的 \(\mathcal C_n(X)\) 是主干,Fuser 只预测应当加入的增量。之后 Receiver 用融合后的输入 Cache 与已经生成的回答 Cache 继续解码:
$$ y_{i+1} {}={} \mathcal P\!\left( y_i\mid \mathcal C^{F}(X)\oplus \mathcal C(Y_{0:i}) \right). $$残差连接解决了一个关键风险:如果直接用投影后的 Sharer Cache 覆盖 Receiver Cache,映射误差会破坏 Receiver 原有能力。实验中这种纯 Project 方案的平均准确率只有 20.70%,远低于保留 Receiver Cache 的 +Fuse 方案 44.88%。
4.3 Fuser 的三个组件

4.3.1 Projection
每层先拼接 Sharer 与 Receiver 的 Cache 特征,再通过投影层和 feature-fusion 层,学习跨表示空间的转换。
这里不能把 Projection 简化理解为“让维度相同”。即使两个模型的 head dimension 一样,坐标系和语义分布仍然不同;投影必须同时学习维度兼容和语义转换。
4.3.2 Dynamic Weighting
映射后的特征经过输入相关的 attention-head modulation。它针对当前 query 调节不同 head 的注入强度。
可以把它理解为连续控制:
- 某个输入可能需要 Sharer 的代码结构 head;
- 另一个输入可能几乎不需要该 head;
- 即使某层 gate 打开,也不代表注入强度固定。
论文没有给出一个可独立复现全部实现细节的简化标量公式,因此这里不额外虚构形式;核心是 per-query、head-wise 的连续重加权。
4.3.3 Learnable Gate
每一层有一个可训练 gate,决定是否将该层的融合增量加入 Receiver。训练时用 Gumbel-Sigmoid 保持可微,并将温度从 1.0 线性退火到 0.001;推理时 gate 变为二值选择。
Dynamic Weighting 与 Gate 的分工不同:
- Gate 回答“这一层是否接收外部信息”;
- Dynamic Weighting 回答“打开以后,各 head 接收多少”。
4.4 Token Alignment:不同 tokenizer 怎么对齐?
同一句话在两个 tokenizer 下可能得到不同 token。例如 “Cache-to-Cache” 可能被一个模型分成 3 个 token,另一个模型分成 5 个。若位置没有对齐,Receiver 第 \(i\) 个 token 可能错误融合 Sharer 第 \(i\) 个完全不同的片段。
论文先把 chat input 分成两类区域。
Template sections 是角色分隔符、格式控制符等结构 token。它们不承载主要语义,但不同 tokenizer 的模板长度可能不同。作者用 pad token 补齐较短一侧,使两边位置长度一致。
Message sections 是用户或助手的真实文本。对每个 Receiver token:
- 解码为字符串;
- 用 Sharer tokenizer 重新编码;
- 若得到一个 token,直接一一映射;
- 若得到多个候选 token,选择解码后字符串覆盖最长的一个。
附录还比较了“选择第一个候选”的策略。两种方法在超过 80% 的序列上产生相同对齐;作者选择 maximal coverage,以降低 one-to-many 情况下丢失表面信息的风险。
这仍是启发式对齐,不是严格语义等价。一个 Receiver token 对应多个 Sharer token 时只保留一个,细粒度信息仍可能损失。
4.5 Layer Alignment:不同层数怎么对应?
作者比较了两种方案。
Terminal alignment 从输出侧向前配对:
Receiver 最后一层 ↔ Sharer 最后一层
Receiver 倒数第二层 ↔ Sharer 倒数第二层
...
直到较浅模型的第一层
Depth-normalized alignment 将层编号归一化到 \([0,1]\)。若较浅模型有 \(L_{\min}\) 层,较深模型有 \(L_{\max}\) 层,则 anchor 层 \(i\) 对应:
$$ j^{*} {}={} \arg\min_j \left| \frac{i}{L_{\min}-1} {}-{} \frac{j}{L_{\max}-1} \right|. $$C2C 最终采用 terminal alignment,因为它更简单,而且实验中略好。直觉上,越靠近输出的深层越接近最终语义决策,优先对齐这些层比均匀覆盖深度更重要。
4.6 Training Objective
Sharer 和 Receiver 的参数全部冻结,只训练 Fuser。给定目标回答 \(Y=(y_1,\ldots,y_T)\),训练损失是标准 next-token cross entropy:
$$ \mathcal L_{\text{C2C}} {}={} {}-{} \sum_{t=1}^{T} \log p_\theta \left( y_t \mid \mathcal C^{F}(X), y_{1:t-1} \right), $$其中 \(\theta\) 只属于 C2C 模块。训练过程为:
- 两个冻结模型分别 prefill 输入并产生 Cache;
- Fuser 对齐并融合 Cache;
- Receiver 在 fused Cache 条件下 prefill 目标回答;
- 梯度穿过 Receiver 的计算图回传到 Fuser,但不更新 Receiver 权重。
4.7 训练数据与超参数
不同实验使用不同数据,不应混在一起:
| Experiment | Training data | Max length | Samples | Macro batch | Steps |
|---|---|---|---|---|---|
| 主性能实验 | OpenHermes-2.5 | 2,048 | 500,000 | 256 | 1,929 |
| 长序列缩放 | LongBench-E | 12,000 | 1,896 | 16 | 118 |
| 模型规模/异构组合 | MMLU auxiliary_train | 1,024 | 15,000 | 128 | 116 |
统一设置包括:
- one epoch;
- learning rate \(1\times10^{-4}\),linear scheduler;
- warmup 10%,weight decay 0.01;
- gradient norm 上限 1;
- Gumbel temperature 从 1.0 退火到 0.001;
- random seed 42;
- 数据按 99%/1% 切为训练与监控用验证集。
5. Evaluation Setup
5.1 Models
论文覆盖 Qwen2.5、Qwen3、Llama 3.2 和 Gemma 3,组合差异包括:
- 不同代际:Qwen2.5 与 Qwen3;
- 不同家族:Qwen、Llama、Gemma;
- 不同规模:0.6B 到 14B;
- 不同专长:通用、数学、代码;
- 不同训练阶段:base 与 instruction-tuned。
主结果固定 Receiver 为 Qwen3-0.6B,分别搭配 Qwen2.5-0.5B-Instruct、Llama3.2-1B-Instruct 和 Qwen3-4B-Base。
5.2 Benchmarks
- MMLU-Redux: 广泛领域知识,去除了原 MMLU 中一批有问题的样本;
- OpenBookQA: 基于科学事实的问答与推理;
- ARC-Challenge: 较难的科学和逻辑推理;
- C-Eval: 中文多领域知识;
- LongBench-E: 13 个长上下文子数据集。
多选题使用 zero-shot、greedy decoding、temperature 0,Receiver 最大生成 64 token。T2T 的中间通信最多 256 token。LongBench 最大输出 2,048 token。时间在单张 NVIDIA A100、batch size 1 上测量。
5.3 Baselines
- Receiver-only / Sharer-only: 单模型下界;
- Query-level Routing: 估计问题难度,上半难题交给强模型、下半交给弱模型;
- Text-to-Text: Sharer 先生成一句解题所需的关键背景,Receiver 再读取原问题与该消息;
- C2C: 不生成中间文本,直接融合 Cache。
Routing 的目标偏向性能–成本折中,它一次仍只使用一个模型,因此无法获得“两个模型共同理解同一问题”的协作增益。
6. Main Results
6.1 Accuracy

在三种 Sharer 设置上,C2C 相对固定 Receiver 的四任务平均准确率分别提高:
- Qwen2.5-0.5B Sharer:11.00 个百分点;
- Llama3.2-1B Sharer:9.64 个百分点;
- Qwen3-4B-Base Sharer:11.88 个百分点。
相对 T2T,平均分别再提高 5.36、4.15、3.06 个百分点。
以 Qwen2.5-0.5B → Qwen3-0.6B 为例:
| Benchmark | Receiver | Sharer | Routing | T2T | C2C |
|---|---|---|---|---|---|
| MMLU-Redux | 35.53 | 38.42 | 35.58 | 41.03 | 42.92 |
| OpenBook | 39.20 | 45.60 | 40.80 | 44.00 | 52.60 |
| ARC-C | 41.04 | 42.09 | 40.70 | 49.48 | 54.52 |
| C-Eval | 32.04 | 40.21 | 34.61 | 35.88 | 41.77 |
这里最值得注意的不是 C2C 简单追上更强模型,而是它经常超过两个单模型。例如 OpenBook 上 Receiver 为 39.20、Sharer 为 45.60,融合后达到 52.60,说明结果不是纯粹选择或复制一方答案。
Qwen3-4B-Base 的 standalone 准确率异常低,因为 base model 不稳定遵循多选题输出格式;T2T 也会被冗长、跑题的中间文本拖慢。C2C 不要求 base model 输出可读指令,却能利用其 prefill 表示。这展示了 latent communication 的独特用法:Sharer 可以“不会好好说”,但仍然“知道一些东西”。
6.2 Latency: 加速到底来自哪里?
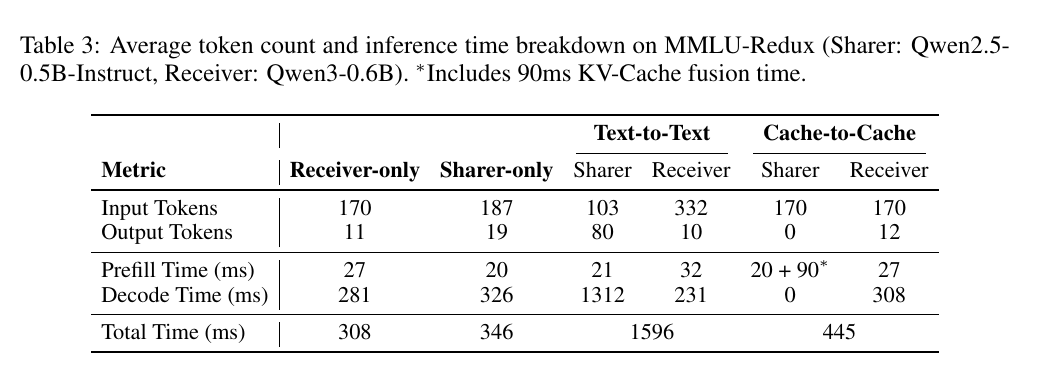
Qwen2.5-0.5B → Qwen3-0.6B 在 MMLU-Redux 上:
| Method | Sharer output tokens | Sharer decode | Fusion | Total |
|---|---|---|---|---|
| T2T | 80 | 1,312 ms | — | 1,596 ms |
| C2C | 0 | 0 ms | 90 ms | 445 ms |
T2T 的 Receiver 因为要读取原问题和中间消息,input token 从 Receiver-only 的 170 增加到 332;C2C 两边都只处理原始 170 token。C2C 的主要收益是用约 90 ms 的并行 Cache fusion 替代 1,312 ms 的 Sharer 串行解码。
三种主设置相对 T2T 的加速分别为 3.46×、1.51×、14.41×。极端差异与模型输出行为有关:
- Llama3.2 经常只输出一个选项字母,T2T 本来就很快,因此 C2C 相对加速较小;
- Qwen3-4B-Base 容易忽略格式并输出长文本,T2T 极慢,C2C 加速非常大。
所以“平均 2.5×”不是固定硬件常数。真实收益依赖 Sharer 的解码长度、模型实现、Fuser 成本和最终任务输出长度。
6.3 Long Context
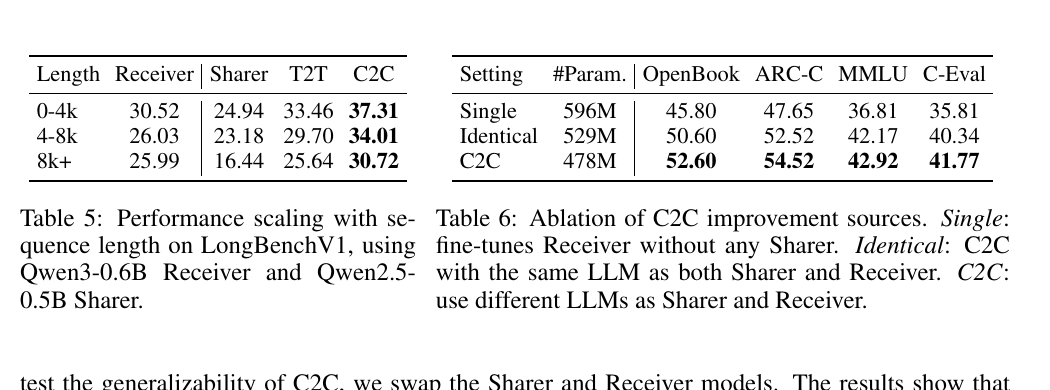
Qwen2.5-0.5B Sharer 与 Qwen3-0.6B Receiver 在 LongBenchV1 上:
| Input length | Receiver | Sharer | T2T | C2C |
|---|---|---|---|---|
| 0–4k | 30.52 | 24.94 | 33.46 | 37.31 |
| 4–8k | 26.03 | 23.18 | 29.70 | 34.01 |
| 8k+ | 25.99 | 16.44 | 25.64 | 30.72 |
C2C 在三个长度区间都优于 T2T。它没有让长上下文计算消失:两个模型仍需 prefill 长输入,Fuser 也要处理相应 Cache;结果只说明在这些区间内,直接表示融合的质量优势仍存在。
6.4 Model Size Scaling
随着 Sharer 从 Qwen2.5-0.5B 增大到 14B,C2C 给不同 Qwen3 Receiver 带来的准确率增益总体增长得比 T2T 快。较小 Receiver 获益最大;Receiver 本身越强,和 Sharer 的知识重叠越多,相对增益越小。
这符合互补性的解释:通信的上限不仅取决于 Sharer 有多强,还取决于 Sharer 拥有多少 Receiver 尚未掌握、且 Fuser 能转换的表示。
6.5 Heterogeneous and Swap Settings
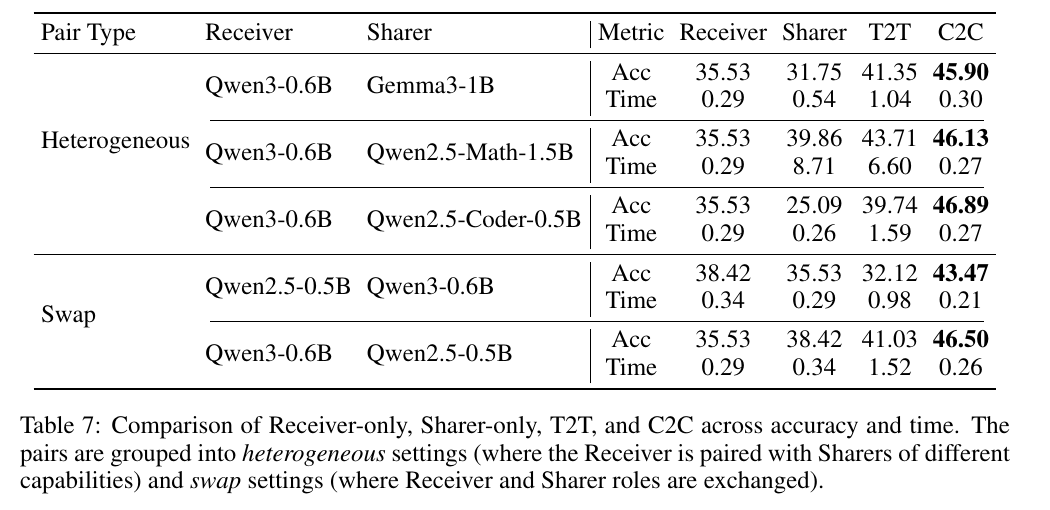
论文测试 Gemma、Math、Coder 作为 Sharer,并交换 Qwen2.5-0.5B 与 Qwen3-0.6B 的角色。五个组合上,C2C 在 MMLU-Redux 平均比 T2T 高 8.59 个百分点。
一个反直觉结果是:Qwen2.5-Coder-0.5B standalone 只有 25.09,但作为 Sharer 后 C2C 达到 46.89。这再次说明:
- Sharer standalone 低分可能来自输出格式、指令跟随或任务不匹配;
- prefill Cache 仍可能提供 Receiver 可用的局部表示;
- 协作价值不能只由 Sharer 的最终答案准确率判断。
角色互换后,C2C 仍带来 5.05 个百分点提升,而 T2T 反而下降 6.30 个百分点,表明 C2C 对“谁说、谁听”的角色选择更稳健。但这并不代表任何模型对都能直接互换;每个方向使用的 Receiver 空间和 Fuser 参数不同。
7. Ablations and Behavior Analysis
7.1 增益不是只来自多了参数
论文比较三种训练:
- Single: 直接 fine-tune Receiver,不使用 Sharer;
- Identical: 同一个 Qwen3-0.6B 同时作为 Sharer 和 Receiver;
- C2C: Qwen2.5-0.5B 与 Qwen3-0.6B 异构通信。
可训练参数分别为 596M、529M、478M。C2C 参数更少,却在四个任务上最好。Identical 又优于 Single,说明让同一模型重复编码并进行 Cache 级“自通信”也有帮助;但异构 C2C 最好,支持互补表示是主要增益来源之一。
7.2 Fuser Component Ablation
| Method | MMLU | ARC-C | OpenBook | C-Eval | Average |
|---|---|---|---|---|---|
| Project | 20.01 | 19.57 | 21.80 | 21.41 | 20.70 |
| +Fuse | 43.36 | 51.65 | 47.60 | 36.91 | 44.88 |
| +Gate = C2C | 42.92 | 54.52 | 52.60 | 41.77 | 47.95 |
结论很明确:
- 只投影 Sharer 并覆盖 Receiver 会严重破坏原表示;
- 残差保留 Receiver Cache,使平均准确率提高 24.18 个百分点;
- 再加入逐层 gate,平均提高 3.07 个百分点。
MMLU 上 +Gate 略低于 +Fuse,说明 gate 不是每项都单调提升;它改善的是跨任务平均稳健性。
7.3 更复杂的 C2C-C
默认 C2C 直接拼接两边 Cache。C2C-C 先用三层 MLP 将 Sharer Cache 映射到 Receiver 维度,再执行 feature fusion 和 dynamic weighting。
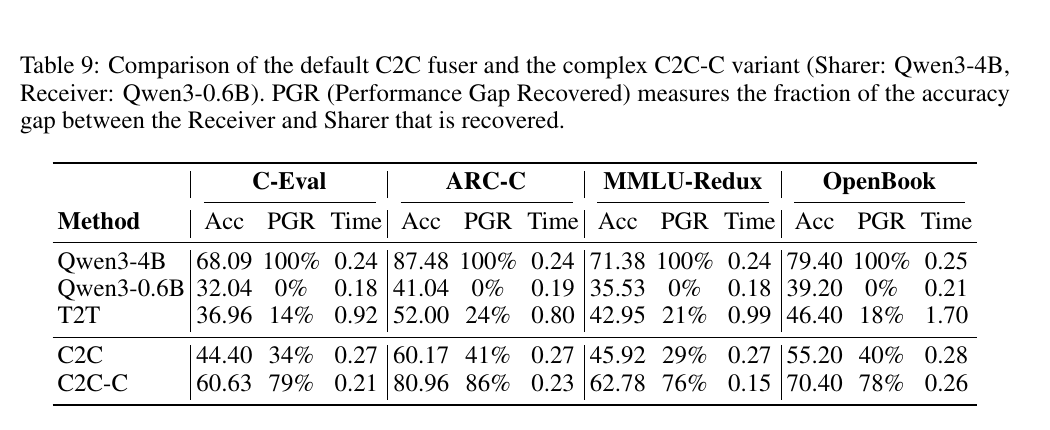
定义 Receiver 准确率为 \(A_R\),强 Sharer 为 \(A_S\),方法结果为 \(A_M\),Performance Gap Recovered 为:
$$ \operatorname{PGR} {}={} \frac{A_M-A_R}{A_S-A_R} \times100\%. $$Qwen3-4B → Qwen3-0.6B 时,默认 C2C 在四个任务恢复 29%–41% 的性能差距;C2C-C 恢复 76%–86%,明显更强。作者仍把默认简单 Fuser 作为主方法,意图先证明 C2C 范式,而不是穷尽最佳适配器结构。
这也说明主结果不是 C2C 的架构上限:Cache communication 的效果高度依赖 projector/fuser 的容量和训练方式。
7.4 Strong-to-Weak Communication
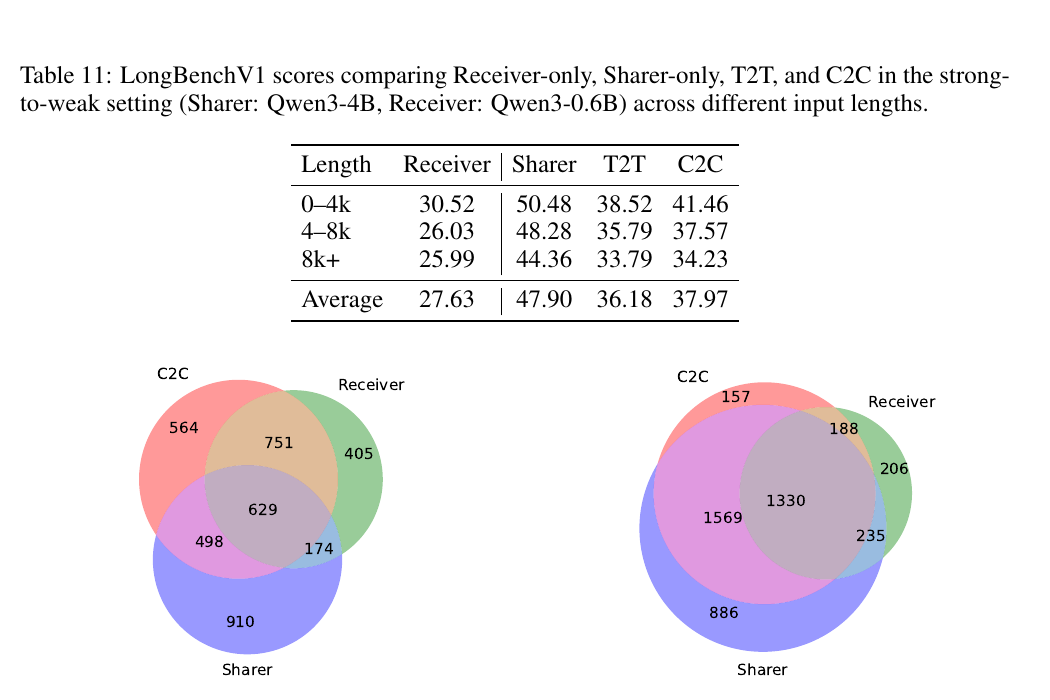
在 Qwen3-4B → Qwen3-0.6B 的 LongBench 强到弱设置中:
| Length | Receiver | Sharer | T2T | C2C |
|---|---|---|---|---|
| 0–4k | 30.52 | 50.48 | 38.52 | 41.46 |
| 4–8k | 26.03 | 48.28 | 35.79 | 37.57 |
| 8k+ | 25.99 | 44.36 | 33.79 | 34.23 |
| Average | 27.63 | 47.90 | 36.18 | 37.97 |
平均 PGR 为:
$$ \frac{37.97-27.63}{47.90-27.63} \approx 51.01\%. $$C2C 恢复了约一半的强弱模型差距,但没有取代强模型。8k+ 区间只比 T2T 高 0.44,说明输入越长并不保证融合优势越大。
7.5 Effective Rank
论文用有效秩衡量表示的有效维度。若矩阵 \(W\) 的奇异值为 \(\sigma_i\),先归一化:
$$ p_i {}={} \frac{\sigma_i}{\|\boldsymbol\sigma\|_1}, $$再计算:
$$ \operatorname{erank}(W) {}={} \exp\!\left( {}-{} \sum_i p_i\log p_i \right). $$Receiver 的 K/V Cache 平均有效秩分别为 388/532,C2C 后变为 395/560,介于 Receiver 与 Sharer 的 539/689 之间。作者据此认为表示空间变得更丰富。
有效秩提高只是相关性证据,不等于“语义质量”被直接测量。更高秩也可能包含噪声;它需要与准确率、消融和失败案例共同解释。
7.6 Gate 在通用训练与任务训练中的行为
- OpenHermes 通用训练下,K/V gate 平均激活率超过 98.21%,几乎全开;实际控制主要来自 dynamic weights,部分层平均 key weight 低于 0.1。
- MMLU 任务训练下,gate 激活率降到 52.67%;被选中层的权重更大,多数超过 0.4。
因此 gate 学到的不是固定“最佳层集合”:
- 通用数据覆盖任务多,模型保留广泛层通路,再由 query-dependent weight 微调;
- 单一任务规律稳定,可以只选择少量持续有效的层。
7.7 Progressive Replacement
作者逐渐提高输入 Cache 中被 C2C 融合结果替换的 token 比例。准确率先下降、后上升;比例超过 50% 后继续增加会改善。替换靠近回答末端的 latter tokens 影响通常更大,因为这些位置与即将生成的答案更接近。
前期下降可能来自训练–测试不一致:训练时使用完整融合 Cache,测试时却只融合局部。这个结果提醒我们,C2C 不是可以任意截断的独立前缀模块,token 范围也是训练分布的一部分。
7.8 Training Cost
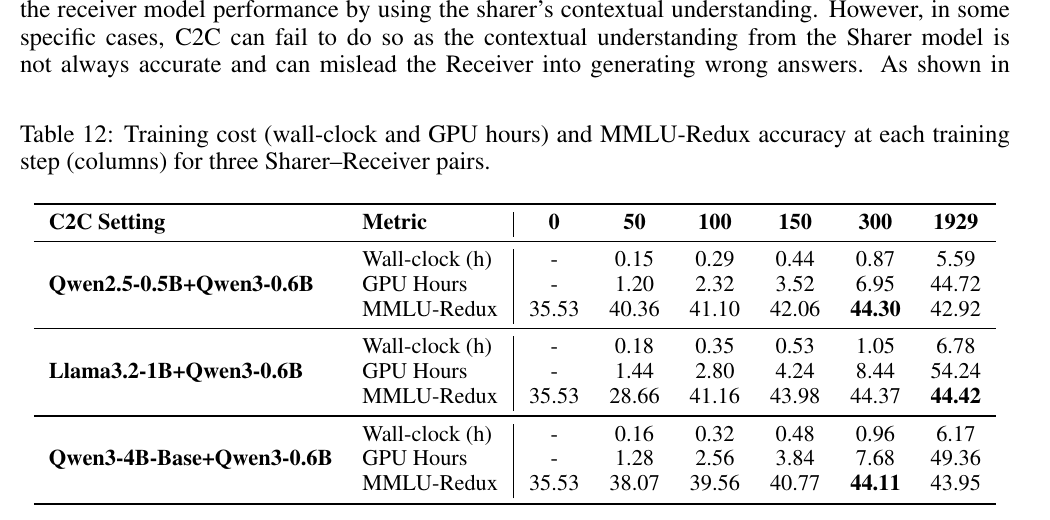
三个主模型对使用 8 张 GPU。完整 1,929 steps 需要约 44.72–54.24 GPU hours,但前 300 steps、少于 9 GPU hours 时就达到与最终 checkpoint 相近甚至更高的 MMLU-Redux 准确率。
例如 Qwen2.5-0.5B → Qwen3-0.6B:
- step 0:35.53;
- step 150:42.06;
- step 300:44.30;
- step 1,929:42.92。
这说明 Fuser 很快学会基本映射,也说明最终 checkpoint 并不总是该 benchmark 的最佳 checkpoint。训练集是通用 OpenHermes,MMLU-Redux 只用于评价,因此后期对通用目标的优化不必然单调提高单一 benchmark。
8. Examples: C2C 什么时候成功,什么时候失败?
8.1 两个单模型都错,融合后答对
论文给出一个环境伦理问题:“Hill 不再问破坏环境这一行为为何不道德,而想问什么?”
- Receiver 把问题理解成换一种说法,选 A;
- Sharer 也选 A,并给出冗长但偏离题型的解释;
- T2T 的中间背景改变了问题焦点,Receiver 最终选 C;
- C2C 识别到问题从“行为是否不道德”转向“实施行为的人是否是坏人”,选出正确的 B。
这个例子支持作者的核心主张:融合不是答案投票。即使双方最终答案都错,二者 Cache 中仍可能存在可组合的局部线索。
不过,单个案例不能证明普遍因果机制。它只说明 learned fuser 有可能从未显式说出的表示中恢复互补信息。
8.2 弱 Sharer 也会把 Receiver 带错
附录还给出反例。一个会计题中 Receiver 原本选择正确的 A;Qwen2.5-0.5B Sharer 错误计算并选择 B。T2T 和 C2C 都受到错误信息影响,最终都选 B。
这揭示了 latent communication 的另一面:文本消息至少可以被人或额外 verifier 检查,Cache 表示更难解释。若 Sharer 系统性偏弱或领域不可靠,Fuser 未必能分辨有用信息与错误信息。
因此实际系统需要:
- 按任务选择 Sharer,而不是一律融合;
- 训练更强的 query-level gate 或拒绝机制;
- 对最终答案保留验证与回退路径;
- 在关键领域单独评估负迁移。
9. Multi-Model and Agentic Extensions
9.1 One Receiver, Multiple Sharers
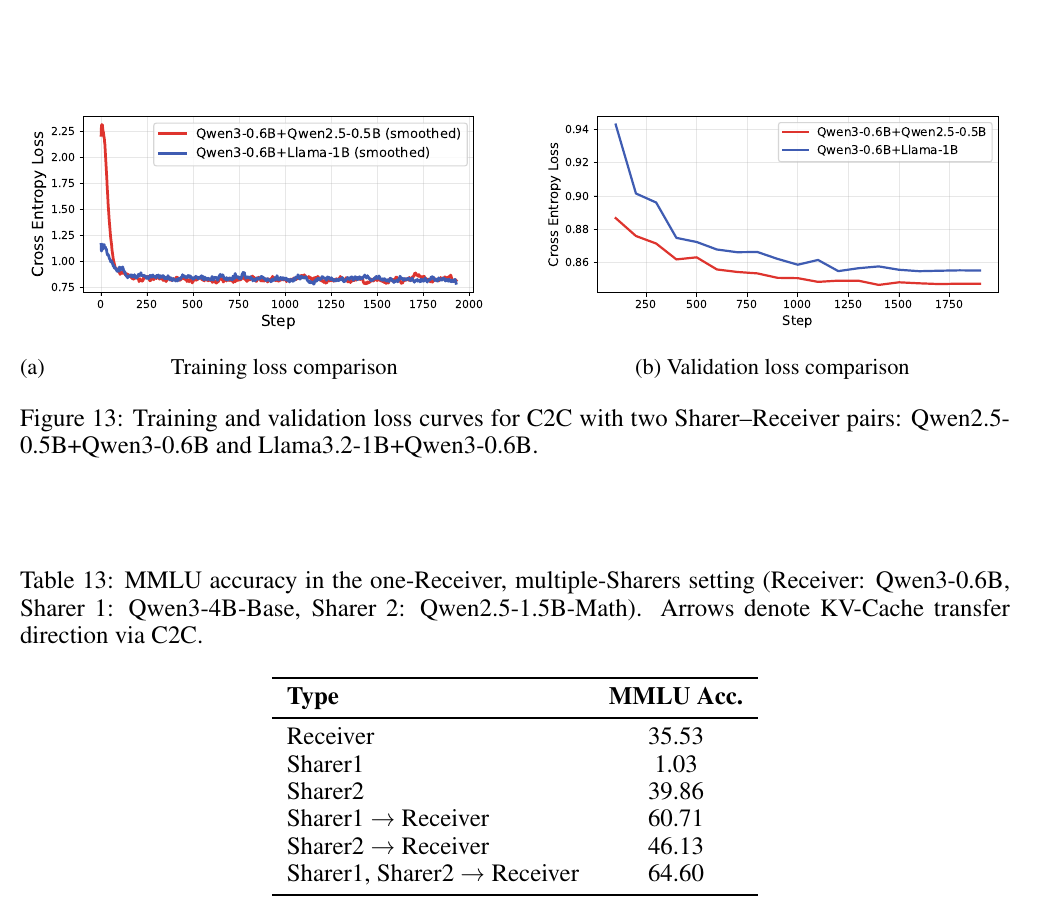
Qwen3-0.6B Receiver 同时接收 Qwen3-4B-Base 与 Qwen2.5-Math-1.5B:
| Setting | MMLU Accuracy |
|---|---|
| Receiver | 35.53 |
| 4B-Base → Receiver | 60.71 |
| Math-1.5B → Receiver | 46.13 |
| 两个 Sharer → Receiver | 64.60 |
两个 pairwise Fuser 分别训练,推理时无需额外联合训练就能同时融合。结果表明多 Sharer 具有可行性,但两个 Fuser 的增量如何冲突、门控如何联合校准,论文没有系统解决。
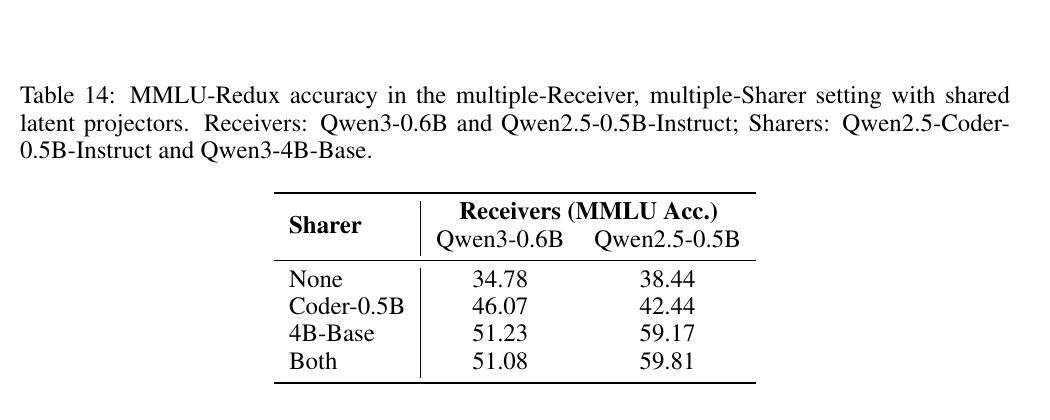
9.2 Multiple Receivers, Multiple Sharers
朴素做法为每个有向模型对训练一个 Fuser,需要 \(O(N^2)\) 个适配器。论文探索共享 latent space:
$$ \mathcal C_{s_i} \xrightarrow{\mathcal P_{s_i}} U_{s_i}, \qquad i=0,\ldots,M-1, $$每个 Sharer 只训练一个 projector 进入公共空间;每个 Receiver 再用自己的 Fuser 读取所有 \(U_{s_i}\):
$$ \left(U_{s_i},\mathcal C_{r_j}\right) \xrightarrow{\mathcal F_{r_j}} \mathcal C'_{r_j}, \qquad j=0,\ldots,N-1. $$这样适配器数量从 pairwise 的二次增长降为 \(M+N\),即模型数同阶。初步结果表明不同 Receiver 能从 Coder 与 4B-Base Sharer 获益,但这仍是 appendix prototype,还没有验证大规模模型群、持续对话或动态成员加入。
9.3 Agentic Flow
论文将数学 agent workflow 分成 problem interpreter 与 problem solver。在 GSM8K 上:
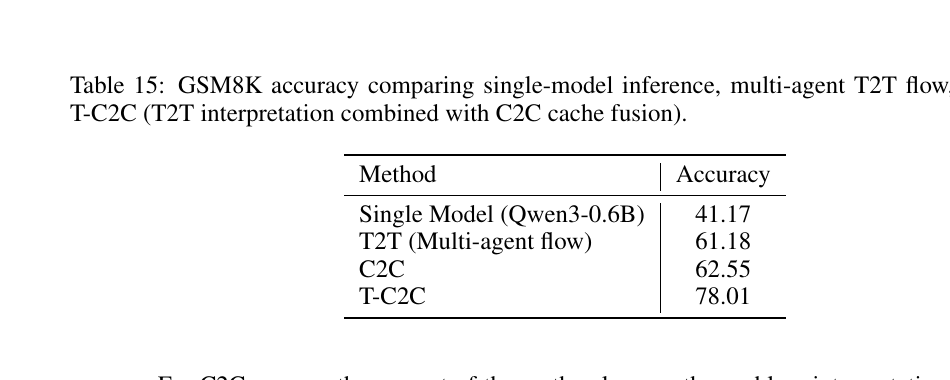
| Method | Accuracy |
|---|---|
| Single Qwen3-0.6B | 41.17 |
| T2T multi-agent flow | 61.18 |
| C2C | 62.55 |
| T-C2C | 78.01 |
T-C2C 同时保留解释文本,并在问题与解释上进行 Cache 融合。它远高于纯 T2T 或纯 C2C,说明文本与 latent representation 并非只能二选一:
- 文本提供显式、可检查的中间结构;
- Cache 传递难以完整说出的内部表示;
- 混合通信可能比完全隐藏或完全显式都更强。
这只是单一 GSM8K workflow 的初步结果,不能直接推广到开放式软件 agent 或长时间多轮协作。
10. Limitations and Practical Boundaries
10.1 每个模型对仍需要训练
默认 C2C 针对特定的 Sharer → Receiver 方向训练 Fuser。更换模型、方向、tokenizer 或层结构通常要重新训练。论文的共享 latent projector 将成本从 \(O(N^2)\) 向 \(O(N)\) 推进,但只是初步实验。
10.2 不是 API 级黑盒协作
C2C 需要访问两个模型的逐层 KV Cache,并修改 Receiver 的推理路径。闭源模型 API 通常只返回文本或 logits,无法直接部署这套方法。它更适合可控制权重和推理框架的本地/服务端模型。
10.3 计算没有被免费消除
相对 T2T,C2C 省掉了 Sharer decode 和 Receiver 对中间消息的额外 prefill,但仍需要:
- 两个模型都对原输入 prefill;
- 保存两份 Cache;
- 执行逐层 Fuser;
- Receiver 生成最终输出。
如果原本只运行 Receiver,C2C 可能增加总 FLOPs 和显存。论文主要证明它比“两个模型通过长文本协作”更快,而不是比单模型绝对更省资源。
10.4 Cache 不是天然隐私保护
论文把不输出原始文本视为 privacy-aware collaboration 的潜在方向,但没有证明 KV Cache 不可逆或不泄漏输入。已有表示反演研究说明中间激活可能包含大量原始信息。C2C 减少了显式内容暴露,不等于得到密码学隐私保证。
10.5 评价仍以多选题为主
四个主 benchmark 都是多选题,输出短、答案提取明确。LongBench 和 GSM8K 扩展了任务范围,但论文尚未充分覆盖:
- 长篇开放式生成质量;
- 真实代码仓库协作;
- 多轮对话中的 Cache 累积误差;
- 工具调用与外部状态;
- 大规模并发服务下的吞吐、显存和网络传输成本。
10.6 对齐启发式仍有损失
maximal-coverage token alignment 在 one-to-many 时只选择一个 source token;terminal layer alignment 也假设深层语义可直接倒序配对。这些设计简单有效,但不是严格的跨模型语义对应。
11. Takeaways
- 论文真正的新意是通信介质,而不只是一个新 projector。 它把多 LLM 协作从离散文本接口推进到连续内部状态接口。
- 两个 oracle 很关键。 固定 Cache 长度仍能因表示变丰富而提升,且跨模型 Cache 可学习转换,为 C2C 的设计提供了直接证据。
- 残差保留 Receiver 是成败分界。 只投影并覆盖会崩溃;Fuse 带来 24.18 个百分点平均提升,Gate 再带来 3.07 个百分点。
- 加速来自消除 Sharer 的中间 decode。 典型实验把 1,312 ms 的通信文本解码换成约 90 ms Cache fusion,但两个模型的 prefill 仍然存在。
- 互补性比 Sharer 单独分数更重要。 一个不擅长按格式回答的 base/coder 模型,其 Cache 仍可能显著帮助 Receiver。
- C2C 不是无损知识注入。 强到弱 LongBench 只恢复约 51% 的差距,弱 Sharer 也可能造成负迁移。
- 最有前景的方向可能是混合通信。 GSM8K 的 T-C2C 同时保留显式解释与 Cache 融合,表现明显高于单独使用任一通信方式。
C2C 证明了一件比具体数字更重要的事:LLM 协作不必永远被限制在“一个模型说一句话、另一个模型再读一句话”的接口上。KV Cache 可以成为更高带宽、低解码延迟的模型间通信层;而如何让它可扩展、可验证、可拒绝错误信息,才是从论文原型走向可靠系统的下一步。