Deep Think with Confidence
Conference: ICLR 2026 Poster
Paper: OpenReview · arXiv
Project: https://jiaweizzhao.github.io/deepconf/
Github: https://github.com/facebookresearch/deepconf
Authors: Yichao Fu, Xuewei Wang, Hao Zhang, Yuandong Tian, Jiawei Zhao
Abstract
推理模型的 test-time scaling 通常沿两个方向展开:一是让单条 Chain-of-Thought 更长,二是并行采样更多推理轨迹,再通过 majority voting 或 verifier 聚合答案。第二种方法也称 parallel thinking 或 self-consistency。它简单且有效,但成本随轨迹数量近似线性增加,而且普通多数投票默认每条轨迹同样可靠,低质量推理同样拥有一票。
Deep Think with Confidence(DeepConf)提出一个无需训练、无需外部奖励模型的改进:直接读取生成模型内部的 top-k token 概率,用局部低置信度片段判断整条推理是否可靠。它包含两个工作模式:
- Offline DeepConf:所有推理轨迹生成完成后,按置信度过滤低质量轨迹,再执行置信度加权投票,主要目标是提高准确率;
- Online DeepConf:生成过程中维护滑动窗口置信度,当一条轨迹跌破由 warmup 样本确定的阈值时立即停止,并根据当前答案共识度决定是否继续采样,主要目标是节省推理 token。
论文在 AIME 2024/2025、BRUMO 2025、HMMT 2025 与 GPQA-Diamond 上评测 DeepSeek-8B、Qwen3-8B/32B、GPT-OSS-20B/120B。离线模式中,GPT-OSS-120B 在 AIME 2025 上由 pass@1 的 91.8% 和 cons@512 的 97.0% 提升到 99.9%;在线模式在同一模型和数据集上将 token 数从 \(3.23\times10^8\) 降到 \(0.49\times10^8\),节省 84.7%,准确率为 97.9%。
这里必须区分:99.9% 是离线 Tail Confidence 过滤结果,84.7% 是在线 DeepConf-low 的 token 节省,它们并非同一配置下同时取得。
1. Motivation
1.1 The Cost of Parallel Thinking
设一个问题采样 \(K\) 条独立推理轨迹,每条平均生成 \(L\) 个 token,那么生成成本近似为:
$$ \operatorname{Cost}_{\mathrm{parallel}}=\mathcal{O}(KL). $$论文给出的直观例子是:使用 Qwen3-8B 在 AIME 2025 上将 pass@1 从约 68% 提升到 cons@512 的约 82%,需要额外生成 511 条轨迹,每道题的总额外开销累积到约一亿 token。
更大的 \(K\) 也不保证一直变好。多数投票只有在“正确答案比任一错误答案更容易形成多数”时才有效。当模型反复犯同一种系统性错误,增加采样数会让错误答案获得更稳定的多数;当大量低质量轨迹分散到不同错误答案时,也会稀释高质量少数轨迹的贡献。因此 self-consistency 经常出现收益递减、饱和,甚至准确率下降。
1.2 Why Equal Voting Is Wasteful
普通多数投票只使用每条轨迹的最终答案:
$$ V(a)=\sum_{t\in\mathcal{T}}\mathbb{I}\!\left[\operatorname{answer}(t)=a\right]. $$最终选择:
$$ \hat{a}=\arg\max_a V(a). $$这个规则会丢掉轨迹内部的大量信息:模型在哪一步开始犹豫、是否反复出现 “wait” 或 “think again”、最后结论是否低置信度,都不影响投票权重。DeepConf 的基本假设是:生成模型自己的 token 分布已经包含推理质量信号,不应只保留最终答案字符串。
1.3 Limitations of Global Confidence
已有方法常把整条轨迹的 token 置信度求平均。全局平均能区分一部分正确和错误轨迹,却有两个缺陷:
- 一段关键推理发生低置信度崩溃,可能被大量简单、高置信度的连接词和常规计算步骤掩盖;
- 必须等整条轨迹生成结束后才能得到完整平均值,无法在生成过程中提前停止。
DeepConf 因此把注意力从“整条轨迹平均有多自信”转向“这条轨迹最不自信的局部片段有多糟糕”。
2. Confidence as a Reasoning Quality Signal
2.1 Token Entropy
模型在位置 \(i\) 给出的词表概率分布为 \(P_i\),token entropy 定义为:
$$ H_i=-\sum_jP_i(j)\log P_i(j). $$如果概率集中在少数候选上,熵较低,说明下一 token 选择更确定;如果概率分布平坦,熵较高,说明模型对接下来如何继续存在不确定性。
2.2 Token Confidence
DeepConf 没有直接使用完整词表熵,而是读取 top-k 候选 token 的 log probability,定义:
$$ C_i=-\frac{1}{k}\sum_{j=1}^{k}\log P_i(j). $$其中 \(P_i(j)\) 是位置 \(i\) 的第 \(j\) 个 top-k 候选概率。这个值反映 top-k 分布的集中程度。论文实验及 vLLM 实现使用 top_logprobs=20。
附录给出的最小 vLLM 修改在代码层面会跳过 logprobs[0] 中已经采样的 token,对其余候选 logprob 求负均值:
new_conf = -sum(logprobs[1:]) / len(logprobs[1:])
因此实际部署必须保证推理后端能够返回多个候选 logprob。若 API 只返回采样 token 本身的概率,无法原样实现论文的在线置信度。
2.3 Average Trace Confidence
对于长度为 \(N\) 的完整推理轨迹 \(t\),全局平均置信度为:
$$ C_{\mathrm{avg}}(t)=\frac{1}{N}\sum_{i=1}^{N}C_i. $$它是论文的基础对照。该指标平滑、稳定,但会把所有位置等权平均,因此不敏感于短暂却致命的推理错误。
2.4 Group Confidence
DeepConf 使用长度为 \(n\) 的重叠滑动窗口 \(G_i\) 聚合 token 置信度:
$$ C_{G_i}=\frac{1}{\lvert G_i\rvert}\sum_{r\in G_i}C_r. $$窗口在每个生成位置更新,因此相邻 group 高度重叠。论文主要使用 \(n=2048\),也在附录比较 512、1024 和 2048。group confidence 有两个作用:
- 比单 token 分数更平滑,不会因为一个罕见符号或数字的偶然低概率就错误停止;
- 比全轨迹平均更局部,能够定位中间步骤持续数百或数千 token 的不确定区间。
2.5 Bottom-10% Group Confidence
设一条轨迹的全部 group 集合为 \(\mathcal{G}\),其中置信度最低的 10% group 构成 \(\mathcal{G}_b\),则:
$$ C_{\mathrm{bottom\text{-}10}}(t)=\frac{1}{\lvert\mathcal{G}_b\rvert}\sum_{G_j\in\mathcal{G}_b}C_{G_j}. $$该指标不会只看一个极端最小值,而是评估整条轨迹最差的那一小部分。它适合离线排序,因为完整轨迹生成后才能知道哪些 group 位于最低 10%。
2.6 Lowest Group Confidence
最激进的局部指标只取整条轨迹中最低的 group confidence:
$$ C_{\mathrm{least}}(t)=\min_{G_j\in\mathcal{G}}C_{G_j}. $$它可以边生成边维护。一旦当前窗口置信度低于停止阈值,最终的 minimum 不可能再回升,因此可以立即判定该轨迹不会进入高置信度候选集。这是 Online DeepConf 能够提前停止的关键。
2.7 Tail Confidence
设 \(\mathcal{T}_{\mathrm{tail}}\) 为轨迹最后固定数量的 token,论文默认取最后 2048 个,则:
$$ C_{\mathrm{tail}}(t)=\frac{1}{\lvert\mathcal{T}_{\mathrm{tail}}\rvert}\sum_{i\in\mathcal{T}_{\mathrm{tail}}}C_i. $$Tail Confidence 的动机是:数学推理的最终化简、答案选择和结论包装直接决定正确性。一条轨迹前半段思路正确,但结尾计算或结论低置信度,仍然应该降低权重。论文的 99.9% AIME 2025 结果正是使用最后 2048 token 的 Tail Confidence、保留 top 10% 轨迹得到的。
2.8 Why Local Measurements Work
论文在 HMMT 2025 的 30 道题上为每题采样 4096 条轨迹,比较正确与错误轨迹的置信度分布。结果表明:
- Average Trace Confidence 已能提供一定区分;
- Bottom-10% 与 Tail Confidence 的正确/错误分布分离更明显;
- 轨迹中最低置信度局部通常对应重新思考、否定前一步或推理方向不稳定的位置。
这并不意味着低置信度必然错误,而是它提供一个无需标注、无需 verifier 的排序信号。
3. Offline DeepConf
3.1 Confidence-weighted Majority Voting
对于轨迹 \(t\) 的置信度 \(C_t\),加权投票写成:
$$ V_C(a)=\sum_{t\in\mathcal{T}}C_t\cdot\mathbb{I}\!\left[\operatorname{answer}(t)=a\right]. $$最终答案仍取 \(\arg\max_aV_C(a)\),但高置信度轨迹拥有更大权重。与 reward model 或外部 verifier 不同,\(C_t\) 完全来自正在生成答案的模型本身。
3.2 Confidence Filtering
仅加权仍允许大量低置信度轨迹参与投票。DeepConf 先按 \(C_t\) 排序,只保留 top-\(\eta\%\),然后在保留集合上执行加权多数投票。论文固定比较:
- top 10%:激进过滤,只保留最自信的十分之一;
- top 90%:保守过滤,只删除最差的十分之一。
top 10% 往往带来更高峰值准确率,但如果模型对某个错误模式高度自信,会把投票集中到错误答案;top 90% 保留更多多样性,通常更稳定。
3.3 Offline Algorithm
Input: prompt P, trace count K, retention ratio η, confidence metric C(t)

1. Independently generate K complete reasoning traces.
2. Extract each trace's final answer and compute C(t).
3. Rank traces by confidence and retain the top η%.
4. Accumulate confidence-weighted votes for every candidate answer.
5. Return the answer with the largest weighted vote.
需要强调:在固定 \(K\) 下,Offline DeepConf 已经生成了全部完整轨迹,所以过滤本身不会返还生成成本。它的直接收益是更准确的聚合;只有当它以更小 \(K\) 达到普通多数投票在更大 \(K\) 下的准确率时,才能间接节省 token。
4. Online DeepConf
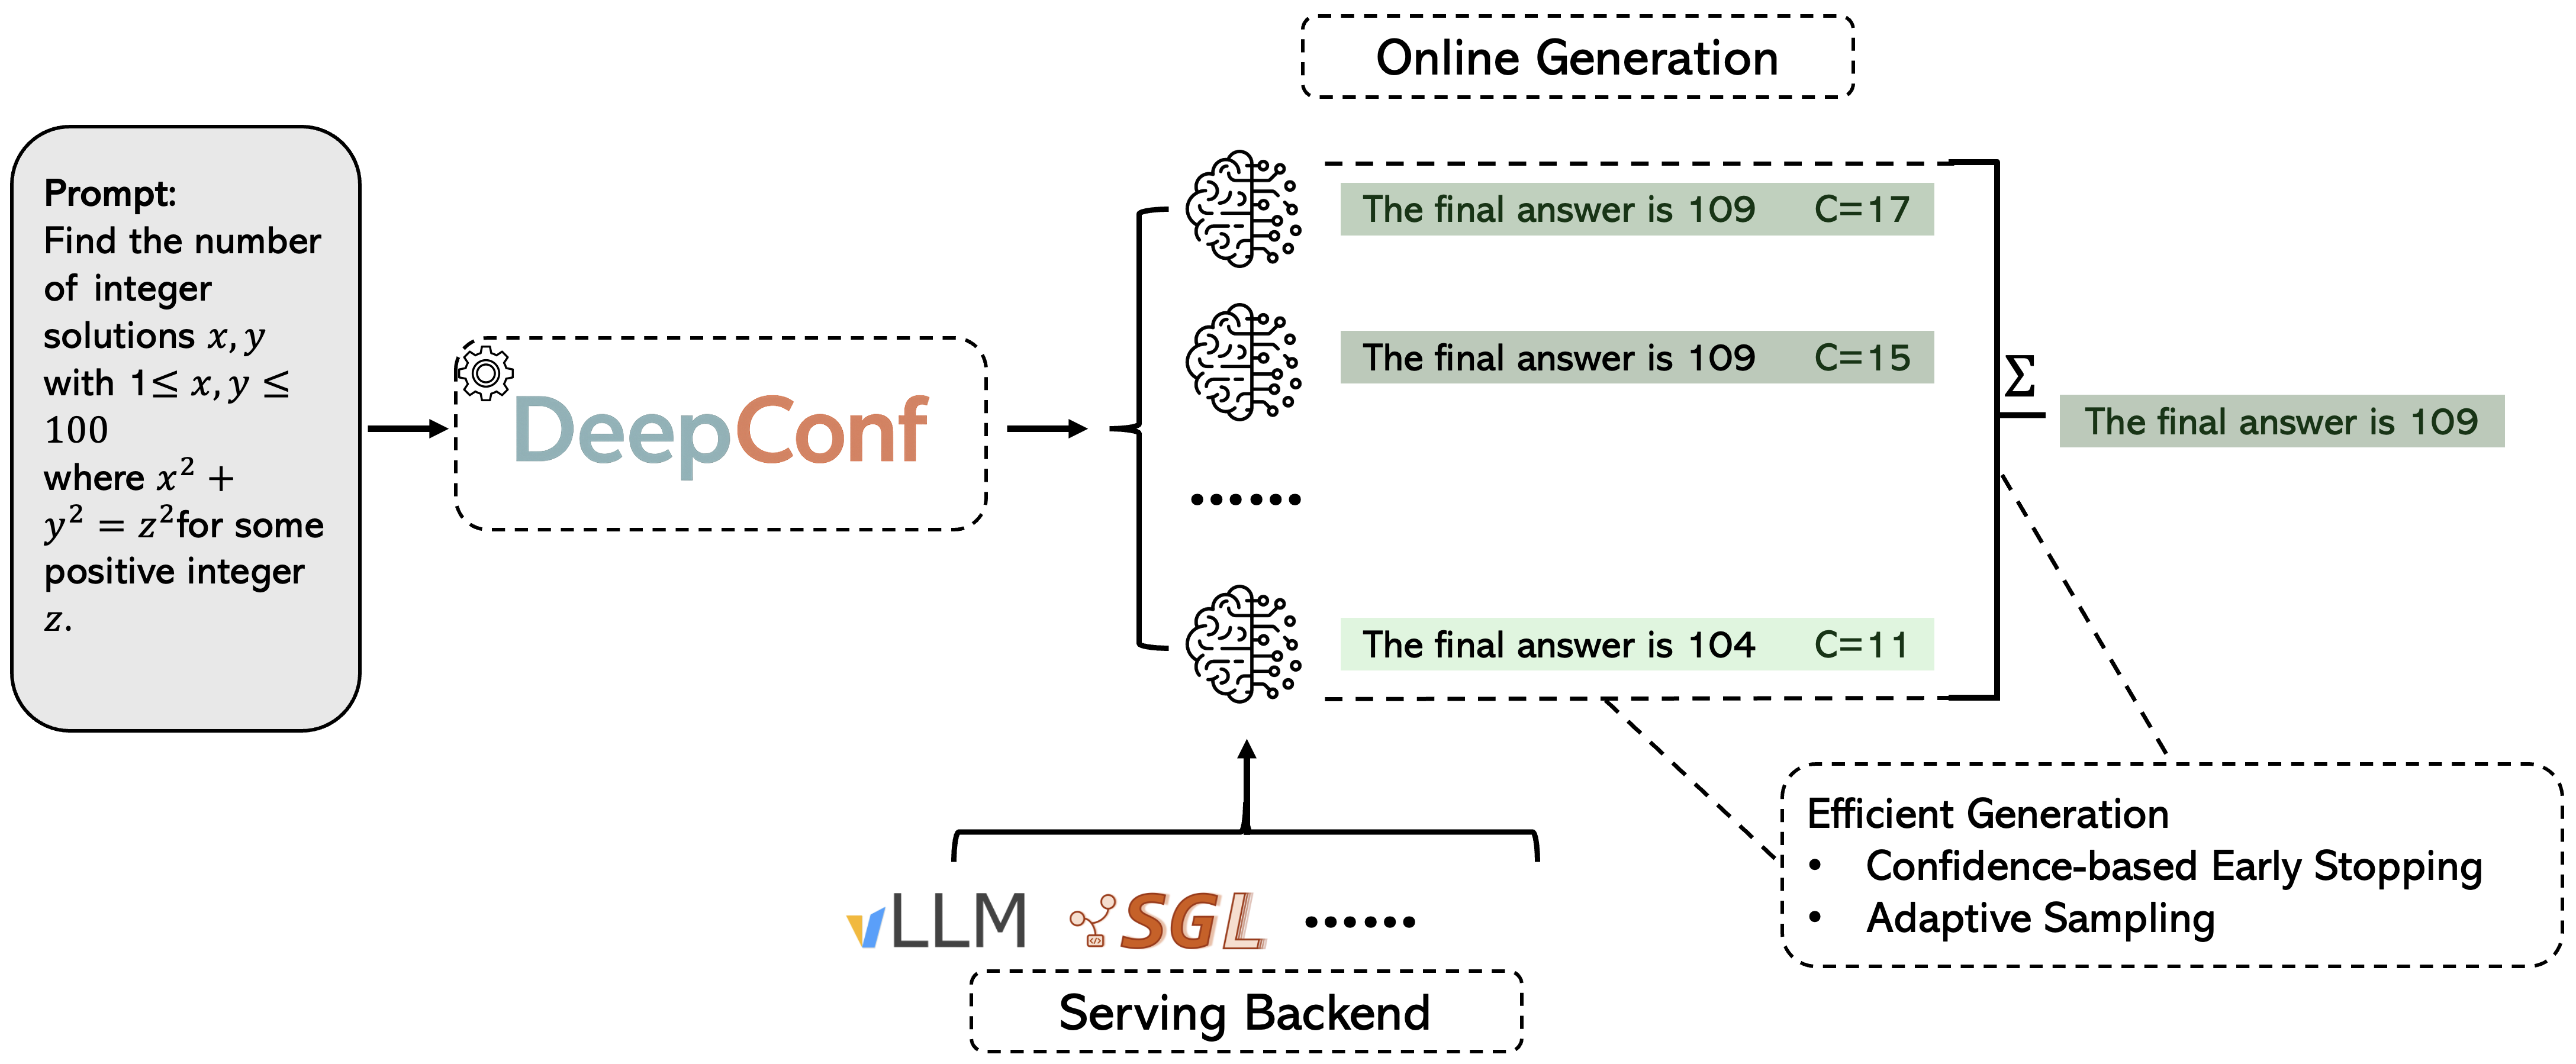
在线模式将置信度计算放入 decode loop,包含 offline warmup、confidence early stopping、confidence filtering、adaptive sampling 四个环节。
4.1 Per-prompt Offline Warmup
对每个新问题先完整生成 \(N_{\mathrm{init}}\) 条轨迹,论文默认 \(N_{\mathrm{init}}=16\)。计算这些轨迹的 Lowest Group Confidence,再建立当前问题专属阈值:
$$ s=\operatorname{Percentile}_{100-\eta}\!\left(\{C_t:t\in\mathcal{T}_{\mathrm{warmup}}\}\right). $$- DeepConf-low 设置 \(\eta=10\%\),因此 \(s\) 是 warmup 置信度的第 90 百分位,只允许最高置信度区域继续生成;
- DeepConf-high 设置 \(\eta=90\%\),因此 \(s\) 是第 10 百分位,仅提前停止明显较差的轨迹。
这里的 low/high 不是置信度数值高低,而是两种过滤强度的名字:low 更激进、更省 token;high 更保守、更稳健。
4.2 Confidence-based Early Stopping
warmup 后,每条新轨迹生成一个 token 就更新长度为 2048 的滑动窗口。当前 group confidence 满足:
$$ C_{G_i}\lt s $$时立刻终止这条轨迹。直觉是:既然该轨迹的局部 minimum 已低于保留阈值,即使继续生成,它也会在最终离线过滤中被删除,因此没有必要支付剩余 token 成本。
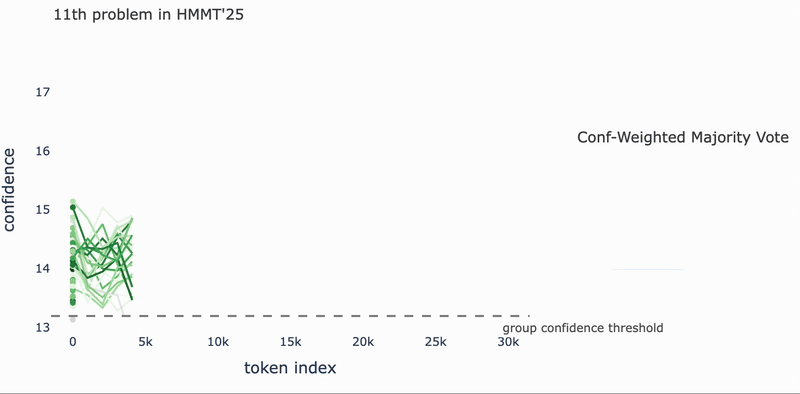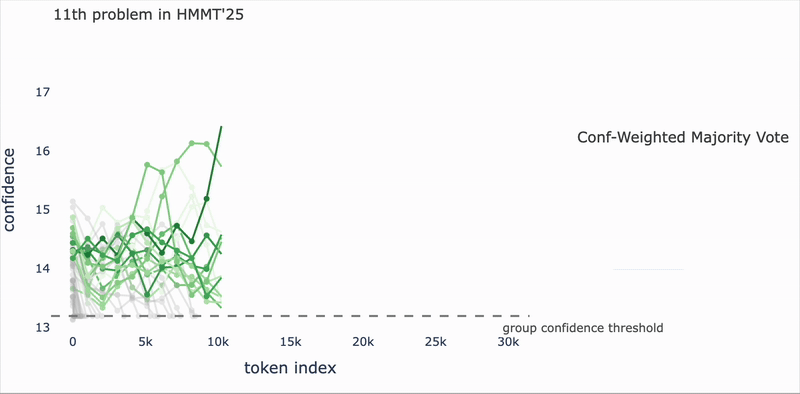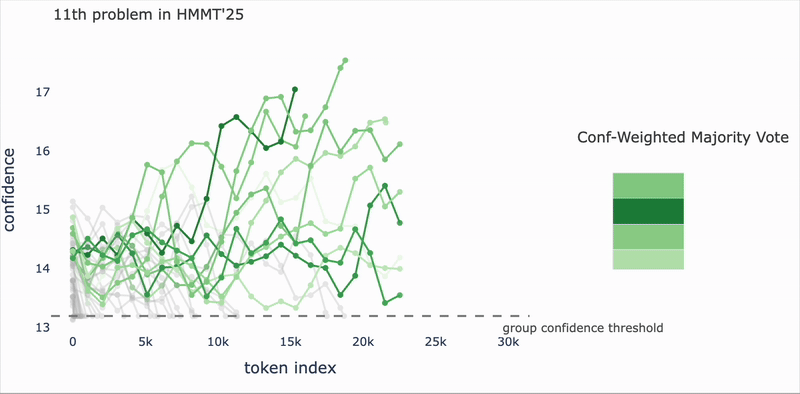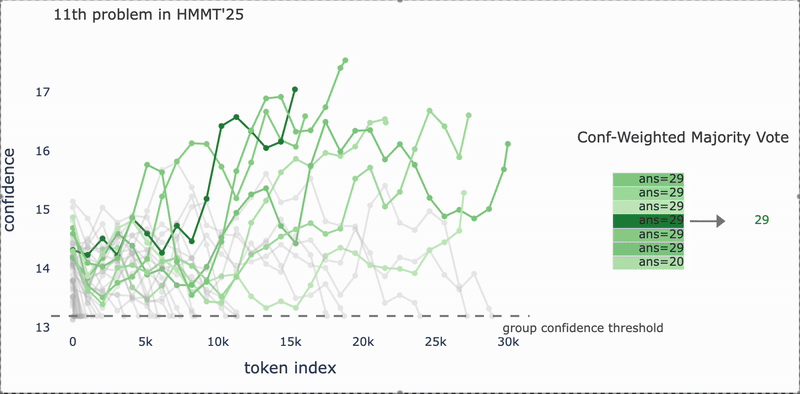
官方动画直观展示了多条轨迹的置信度随 token 位置变化,跌破虚线阈值的轨迹会被提前停止:
4.3 Adaptive Sampling by Answer Consensus
仅停止单条低质量轨迹仍可能继续启动很多新样本。DeepConf 还根据当前答案的一致程度决定整个问题是否已经“想够了”。设当前加权多数答案为 \(\hat{a}\),定义共识度:
$$ \beta=\frac{V_C(\hat{a})}{\sum_aV_C(a)}. $$若 \(\beta\ge\tau\),说明当前答案已经占据足够高的投票权重,可以停止继续采样;若 \(\beta\lt\tau\),则继续生成,直到达到最大轨迹预算 \(B\)。论文默认 \(\tau=0.95\),并使用:
$$ B\in\{32,64,128,256,512\}. $$这让不同难度问题消耗不同算力:简单问题在少量轨迹后形成高共识,困难问题则继续使用剩余预算。
4.4 Online Algorithm
Input: prompt P, total budget B, warmup size N_init,
       retention ratio η, consensus threshold τ

Warmup:
1. Generate N_init complete traces.
2. Compute each trace's lowest group confidence.
3. Set threshold s from the corresponding confidence percentile.
4. Filter and confidence-weight the warmup answers.

Online generation:
5. While weighted consensus β < τ and trace count < B:
   a. start a new reasoning trace;
   b. update 2048-token group confidence after every token;
   c. terminate this trace immediately if group confidence < s;
   d. otherwise extract its answer and update weighted votes.
6. Return the highest-weight answer.
随着 \(N_{\mathrm{init}}\) 增大,warmup 对置信度分布的估计更稳定,在线阈值会逐渐逼近离线 top-\(\eta\%\) 过滤策略。但 warmup 本身必须完整生成,因此 \(N_{\mathrm{init}}\) 过大会侵蚀节省。
5. Experimental Setup
5.1 Models
| Model | Parameters | Family | Max Generation Length |
|---|---|---|---|
| DeepSeek-8B | 8B | DeepSeek-R1-0528 distilled to Qwen3-8B | 64K |
| Qwen3-8B | 8B | Qwen3 | 32K |
| Qwen3-32B | 32B | Qwen3 | 32K |
| GPT-OSS-20B | 20B | GPT-OSS | 130K |
| GPT-OSS-120B | 120B | GPT-OSS | 130K |
其中论文所称 DeepSeek-8B,具体是 DeepSeek-R1-0528-Qwen3-8B。
5.2 Benchmarks
| Benchmark | Domain | Main Characteristic |
|---|---|---|
| AIME 2024 | Competition Math | 高难度整数答案题 |
| AIME 2025 | Competition Math | 新近、难度较高的 AIME 题目 |
| BRUMO 2025 | Competition Math | Brown University Math Olympiad |
| HMMT 2025 | Competition Math | Harvard–MIT 数学竞赛题 |
| GPQA-Diamond | Graduate STEM | 研究生级科学推理与知识问答 |
前四个基准以数学推理为主,GPQA-Diamond 用于验证方法是否只对数学答案投票有效。
5.3 Sampling and Evaluation Protocol
论文先为每个问题预生成 4096 条完整轨迹,建立共同采样池。每次实验从池中重新采样工作集:
- Offline:从池中采样 \(K\) 条完整轨迹,比较普通投票、置信度加权和过滤;
- Online:使用相同池模拟逐条生成与提前停止,提前终止轨迹只计实际产生的 token;
- 每个配置独立重采样并重复 64 次,最终报告平均准确率与 token 数;
- 主要结果使用 \(K=512\),扩展实验扫描 32、64、128、256、512。
这种 protocol 保证各方法看到一致的候选分布,降低单次随机采样造成的方差。但在线实验基于预生成池回放,主要测量 token 数和答案质量,并不是包含调度、batch fragmentation 与硬件利用率的真实端到端吞吐测试。
5.4 Generation Hyperparameters
| Model | Temperature | Top-p | Top-k |
|---|---|---|---|
| DeepSeek-8B | 0.6 | 0.95 | — |
| Qwen3-8B / 32B | 0.6 | 0.95 | 20 |
| GPT-OSS-20B / 120B | 1.0 | 1.0 | 40 |
Qwen3 与 GPT-OSS 使用相同的 step-by-step 指令,并要求最终答案放进 \boxed{};GPT-OSS 保留官方 system prompt,设置 reasoning effort 为 high。DeepSeek-8B 使用其官方 system prompt。
6. Offline Results
6.1 Confidence Filtering at 512 Traces
下面选取 Table 1 中最有代表性的配置。Bottom-10@10 表示按 Bottom-10% Group Confidence 只保留 top 10%,Tail@10 表示按最后 2048 token 的 Tail Confidence 只保留 top 10%。
| Model / Dataset | Pass@1 | Cons@512 | Mean Conf | Bottom-10@10 | Tail@10 |
|---|---|---|---|---|---|
| DeepSeek-8B / AIME24 | 83.0 | 86.7 | 86.7 | 93.3 | 93.3 |
| DeepSeek-8B / AIME25 | 76.9 | 82.3 | 82.3 | 87.5 | 87.4 |
| DeepSeek-8B / HMMT25 | 58.1 | 69.6 | 69.9 | 79.5 | 83.9 |
| Qwen3-32B / AIME24 | 80.6 | 85.3 | 85.7 | 90.8 | 89.4 |
| GPT-OSS-120B / AIME25 | 91.8 | 97.0 | 97.1 | 98.1 | 99.9 |
| GPT-OSS-120B / BRUMO25 | 75.6 | 86.7 | 86.8 | 82.9 | 89.4 |
| GPT-OSS-120B / HMMT25 | 78.9 | 92.9 | 92.9 | 90.5 | 88.9 |
结果说明:
- 单纯 Mean Confidence 加权通常只比普通多数投票高一点;
- 局部置信度加上过滤能够带来更大增益,例如 DeepSeek-8B/HMMT25 从 69.6 提升到 83.9;
- 没有一个激进指标对所有模型和数据集都最优。GPT-OSS-120B/HMMT25 中,top 10% 过滤反而从 92.9 降到 88.9;
- top 90% 过滤更接近普通多数投票,适合不愿承担准确率回退的场景。
6.2 Lowest Group Confidence
在 DeepSeek-8B 的 AIME24、AIME25、BRUMO25、HMMT25 上,使用 2048-token Lowest Group Confidence:
- top 10% 相比每个数据集的最佳多数投票提高 0.26–9.38 个百分点,平均提高 5.27;
- top 90% 在四个数据集上匹配或略超多数投票,平均提高 0.29;
- 相比单轨迹推理,top 10% 平均提高 14.30 个百分点。
扩展到 5 个模型、4 个数学数据集的 20 个配置后,top 90% 相比多数投票平均提高 0.17 个百分点,范围为 -0.21 到 +0.73;top 10% 在 12/20 个配置中提高 0.26–9.38,在另外 8 个配置中下降 0.31–4.69,整体平均提高 1.22。
因此 top 10% 是“高收益、高方差”的选择,top 90% 则是接近保守替换多数投票的选择。
7. Online Results
7.1 Matched Budget at 512 Traces
表中的 token 单位为 \(10^8\)。DeepConf-high 保留 top 90%,DeepConf-low 保留 top 10%。
| Model / Dataset | Majority Tokens / Acc. | High Tokens / Acc. | Low Tokens / Acc. |
|---|---|---|---|
| DeepSeek-8B / AIME24 | 3.55 / 86.7 | 1.45 (-59.0%) / 86.7 | 0.78 (-77.9%) / 92.5 |
| DeepSeek-8B / AIME25 | 4.01 / 82.3 | 2.37 (-40.9%) / 81.4 | 1.24 (-69.0%) / 86.4 |
| DeepSeek-8B / HMMT25 | 4.49 / 69.8 | 3.43 (-23.5%) / 70.0 | 1.60 (-64.4%) / 77.6 |
| Qwen3-8B / AIME25 | 2.77 / 82.5 | 1.99 (-28.1%) / 82.8 | 1.31 (-52.7%) / 78.1 |
| Qwen3-32B / AIME24 | 2.00 / 84.8 | 0.88 (-56.0%) / 86.4 | 0.66 (-66.8%) / 89.5 |
| GPT-OSS-20B / AIME25 | 6.26 / 95.4 | 3.18 (-49.2%) / 95.3 | 1.21 (-80.7%) / 96.1 |
| GPT-OSS-120B / AIME25 | 3.23 / 97.1 | 1.42 (-56.0%) / 97.0 | 0.49 (-84.7%) / 97.9 |
| GPT-OSS-120B / HMMT25 | 4.09 / 92.8 | 2.78 (-32.0%) / 93.0 | 0.97 (-76.2%) / 92.0 |
整体规律为:
- DeepConf-low 通常减少约 43%–84% token,并在多数配置中保持或提高准确率;
- DeepConf-high 通常减少约 16%–59% token,准确率变化更小;
- 激进策略并非无损,例如 Qwen3-8B/AIME25 节省 52.7%,但准确率下降 4.4 个百分点;
- 最大节省 84.7% 来自 GPT-OSS-120B/AIME25,在线准确率为 97.9%,而不是离线结果中的 99.9%。
7.2 Accuracy–Token Pareto Frontier
论文扫描不同预算后发现,在能够匹配多数投票准确率的配置中:
- adaptive DeepConf-low 可减少约 19%–96% token;
- adaptive DeepConf-high 可减少约 13%–84% token;
- 相同轨迹上限下,加入答案共识停止的 adaptive 版本通常优于固定运行到预算上限的 budget-only DeepConf。
但论文也列出未能同时匹配多数投票准确率并减少 token 的例外,包括 Qwen3-8B/AIME25、若干 GPT-OSS 的 BRUMO/HMMT 配置等。因此更准确的结论是:DeepConf 显著改善多数设置的 Pareto frontier,而不是对每个模型—任务组合都严格无损。
7.3 GPQA-Diamond
GPQA-Diamond 上的总体结论与数学任务一致:
- Qwen3-8B 和 Qwen3-32B 的离线 top 10% 能超过多数投票峰值;
- DeepSeek-8B 上 top 90% 更安全,top 10% 略低;
- 两种离线方法相对单轨迹平均提高约 6%;
- 在线 adaptive 策略在相同预算下进一步减少 token,但激进策略在 DeepSeek-8B 上可能退化。
8. Ablation Study
8.1 Consensus Threshold \(\tau\)
论文在 Qwen3-32B/AIME24 上比较 \(\tau\in\{1.0,0.95,0.90,0.85\}\)。相对于没有答案共识停止的 budget-only 版本:
| Variant | \(\tau\) | B=512 Accuracy Change | B=512 Token Saving |
|---|---|---|---|
| DeepConf-high | 1.00 | 0.00 pp | 33.4% |
| DeepConf-high | 0.95 | 0.00 pp | 54.7% |
| DeepConf-high | 0.85 | 0.00 pp | 69.0% |
| DeepConf-low | 1.00 | 0.00 pp | 36.3% |
| DeepConf-low | 0.95 | 0.00 pp | 52.8% |
| DeepConf-low | 0.90 | -0.05 pp | 63.4% |
| DeepConf-low | 0.85 | -0.31 pp | 69.6% |
\(\tau=0.95\) 在该实验中兼顾准确率和节省,因此被选为默认值。阈值越低,越容易在答案尚未完全稳定时停止;DeepConf-high 因为保留候选更多,对 \(\tau\) 更稳健。
8.2 Warmup Size
论文比较 \(N_{\mathrm{init}}\in\{8,16,32\}\):
- 更大 warmup 一般能更准确地估计阈值,使在线准确率接近离线版本;
- 这种关系不保证单调,不同模型和任务的置信度分布不同;
- 更大 warmup 会增加固定完整生成成本,但有时也能建立更严格阈值,从而提高后续提前停止率;
- 多数配置下不同 warmup size 的准确率变化通常不超过约 1 个百分点。
论文最终选择 16,是阈值稳定性和固定开销之间的折中。值得注意的是,当总预算只有 32 时,16 条 warmup 已占一半预算,因此自适应节省远小于预算 512 时。
8.3 Retention Ratio
从 top 90% 扫描到 top 10% 时,更激进过滤在多数配置中能提高峰值准确率,但最佳 \(\eta\) 依赖数据集。有些组合在 top 25% 或 top 50% 达到最好结果,说明固定 top 10% 不是普适最优超参数。
作者仍将 top 10% 和 top 90% 作为两个统一配置,是为了分别代表激进和保守端点,而不是声称它们对每个任务都经过调优。
8.4 Confidence Metric and Window Size
附录系统比较了 Mean、Head、Tail、Bottom-q% 与 Lowest Group Confidence:
- 只看轨迹开头的 Head Confidence 与最终正确性相关性较弱,过滤后平均表现可能下降;
- Tail Confidence 更接近最终结论,在 GPT-OSS-120B/AIME25 上获得最佳 99.9%;
- Bottom 与 Lowest Group Confidence 能捕获中间局部崩溃,并且 Lowest 可以在线增量维护;
- 对 Lowest Group Confidence,512/1024/2048 三种窗口没有在所有配置上一致最优,但 2048 整体较稳,因此作为默认值;
- 极小窗口容易被单个异常 token 干扰,极大窗口则逐渐退化成全局平均。
9. System Implementation
9.1 Official Package
官方实现提供 DeepThinkLLM,封装在 vLLM 之上:
from deepconf import DeepThinkLLM

deep_llm = DeepThinkLLM(
    model="deepseek-ai/DeepSeek-R1-0528-Qwen3-8B"
)

# Offline: generate all traces, then compare voting strategies.
offline_result = deep_llm.deepthink(
    prompt=prompt,
    mode="offline",
    budget=64,
    compute_multiple_voting=True,
)

# Online: warm up, then perform confidence-based early stopping.
online_result = deep_llm.deepthink(
    prompt=prompt,
    mode="online",
    warmup_traces=16,
    total_budget=256,
)
返回的 DeepThinkOutput 包含最终答案、不同投票策略结果、warmup/final traces、置信度阈值、token 统计和耗时信息。
9.2 Minimal vLLM Changes
论文附录基于 vLLM commit 31f09c6、Python 3.12、CUDA 12.8,只修改两个位置:
- 扩展
LogprobsProcessor,维护定长deque、窗口置信度和停止阈值; - 在
output_processor.py构造RequestOutput前调用check_conf_stop()。
OpenAI-compatible API 请求需要打开候选 logprob:
responses = client.chat.completions.create(
    model=model_path,
    messages=messages,
    max_tokens=max_tokens,
    temperature=0.6,
    top_p=0.95,
    logprobs=True,
    top_logprobs=20,
    n=real_gen,
    extra_body={
        "top_k": 0,
        "vllm_xargs": {
            "enable_conf": True,
            "window_size": 2048,
            "threshold": conf_threshold,
        },
    },
)
若窗口未填满则不停止;窗口均值低于 threshold 时,将 FinishReason 设为 STOP,并在 stop_reason 中记录置信度阈值,便于追踪提前终止原因。
10. Practical Interpretation
10.1 When to Use DeepConf-high
适合准确率回退代价很高、模型校准情况未知的服务:
- 只删除最低置信度 10% 左右的轨迹;
- 保留更多答案多样性;
- token 节省较小,但结果通常接近普通多数投票。
10.2 When to Use DeepConf-low
适合推理预算昂贵、能够容忍小概率回退,或已经在目标数据上确认置信度有效的服务:
- 只保留最高置信度 10% 左右的轨迹;
- 更早停止大量低质量生成;
- 通常提供最大 token 节省和更高峰值准确率;
- 需要重点监控 confidently-wrong 错误。
10.3 Deployment Checklist
- 先在目标模型和真实任务上画出 accuracy–token curve,而不是直接采用 top 10%;
- 确认服务后端能返回至少两个候选 logprob,论文使用 20;
- 把 warmup token 纳入总成本,不要只统计 warmup 之后的节省;
- 分别记录置信度提前停止与答案共识停止带来的收益;
- 检查提前停止轨迹是否产生不完整
\boxed{}、JSON 或工具调用,避免错误进入投票; - 对不同题型、语言和 prompt 模板重新校准阈值分布;
- 高风险任务可将置信度与独立 verifier、可执行检查或规则约束组合。
11. Limitations
11.1 Confidently Wrong
DeepConf 的核心信号来自模型自身,因此无法解决系统性过度自信。当模型对同一个错误推理模式高度确定时,激进过滤会删除持不同意见的低置信度轨迹,反而放大错误多数。这是 top 10% 在部分 GPT-OSS、Qwen3 配置中退化的主要原因。
11.2 Warmup Is Not Free
每个问题都要先完整生成 16 条轨迹,DeepConf 更适合原本就计划进行大规模并行采样的场景。如果总预算很小,warmup 会占据大部分成本;单次普通问答也不一定值得为阈值估计额外采样。
11.3 Backend Requirements
在线方法必须访问 top-k logprob 并修改 decode loop。许多闭源 API 不提供足够的候选概率,或者无法在服务端按滑动置信度终止生成。在这种情况下只能做离线后处理,无法获得论文中的在线 token 节省。
11.4 Benchmark Scope
主要结果集中在竞赛数学,GPQA-Diamond 提供了一定 STEM 泛化证据,但论文没有系统评测长文本生成、代码 Agent、多轮工具使用或开放式答案。官方仓库声称框架支持 math、science 和 coding,不等于论文已经在所有这些任务上证明同等收益。
11.5 Token Savings Are Not Throughput Measurements
实验通过预生成的 4096-trace pool 模拟在线停止,能公平比较 token 数,却没有完整覆盖真实 serving 中的 continuous batching、提前退出导致的 batch 空洞、logprob 返回带宽和调度开销。减少 84.7% token 不应直接解释为端到端延迟或吞吐提高 84.7%。
11.6 Confidence Is Model- and Prompt-dependent
temperature、top-p、top-k、system prompt、reasoning effort 和答案格式都会改变概率分布。论文的 \(s\) 是 per-prompt warmup 阈值,说明一个全局固定 threshold 很难跨模型直接复用。更换解码配置后应重新校准,而不能照搬数值。
12. Conclusion
DeepConf 的核心观点是:并行推理不应该把每条 Chain-of-Thought 当成等价样本。模型生成时暴露的局部概率分布能够识别一部分推理崩溃,因此既可以在离线阶段改善答案聚合,也可以在在线阶段停止原本会被过滤的低质量轨迹。
方法可以概括为:
$$ \text{Top-k Logprobs} \rightarrow \text{Local Group Confidence} \rightarrow \text{Trace Filtering / Early Stopping} \rightarrow \text{Confidence-weighted Voting}. $$Offline DeepConf 展示了局部置信度对轨迹质量排序的价值,最高将 GPT-OSS-120B 在 AIME 2025 上的 cons@512 从 97.0% 提升到 99.9%;Online DeepConf 则把这个排序信号转化为推理期间的控制策略,在大量配置中减少 43%–84% token,同时保持或提高准确率。
它的优势是无需训练、无需外部 verifier、只需很小的 serving 修改;它的边界也同样清楚:模型可能 confident but wrong,warmup 有固定成本,top-k logprob 并非所有服务都能提供,token 节省也不等价于真实系统加速。作为 test-time scaling 的控制器,DeepConf 更适合与自适应采样、可验证奖励和真实 serving 调度共同使用,而不是被理解为对所有并行推理都无条件无损的剪枝器。