FlashDrive: Flash Vision-Language-Action Inference for Autonomous Driving
Status: arXiv v1, 2026-08-13
Paper: https://arxiv.org/abs/2608.12932
Project: https://z-lab.ai/projects/flashdrive/
GitHub: https://github.com/z-lab/flashdrive
Authors: Zekai Li, Yihao Liang, Hongfei Zhang, Jian Chen, Yesheng Liang, Zhijian Liu
一句话总结: FlashDrive 不把 VLA 推理当成一个笼统的“大模型太慢”问题,而是把它拆成 Encode、Prefill、Decode、Action 四段,为每段找到不同的结构性冗余,再用流式 KV Cache、DFlash 推测式推理、自适应 Flow Matching、W4A8 量化与 CUDA Graph 共同加速完整链路。
Abstract
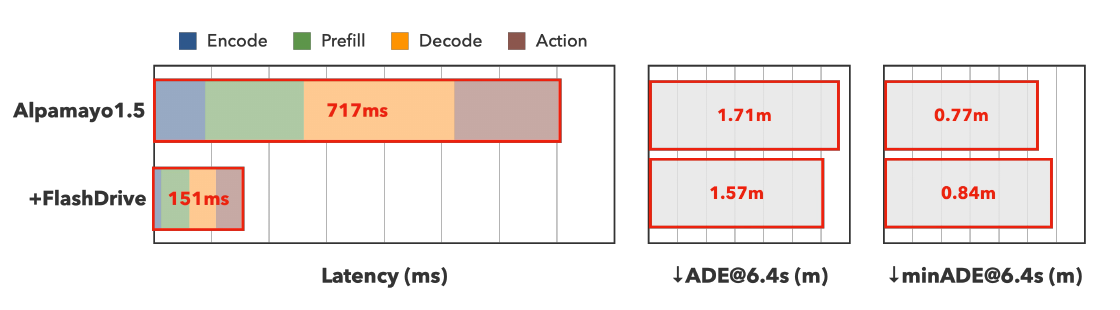
推理型自动驾驶 VLA 不只要“看见道路”,还要根据多相机视频理解场景、生成语言形式的因果推理,再预测未来连续轨迹。以 10B 参数的 Alpamayo 1.5 为例,一次完整推理在 RTX PRO 6000 上需要 716.9 ms,相当于每秒只能重规划约 1.4 次。更麻烦的是,这 716.9 ms 并不存在一个可以单独解决的唯一瓶颈:
- 视觉编码器重复处理相邻时刻中相同的历史画面;
- Prefill 重复为这些画面建立几乎相同的 KV Cache;
- 约 16 个结构化驾驶推理 token 仍被逐 token 串行生成;
- 8 步 Flow Matching 在速度场几乎不变的中间区间反复运行 Action Expert。
FlashDrive 的做法是为每种冗余设计不同捷径:
- Streaming Inference: 只编码四个相机各自最新的一帧,复用前三帧的 KV Cache;
- DFlash Speculative Reasoning: 用两层扩散式草稿模型并行提出 8-token 候选块,再由原 VLA 一次验证;
- Adaptive-Step Flow Matching: 保留去噪轨迹首尾的重要网络计算,在中间四步复用已经得到的速度;
- W4A8 Quantization: 语言骨干使用 4-bit 权重和 8-bit 激活,同时加速 memory-bound Decode 与 compute-bound Prefill;
- System Optimizations: 用 CUDA Graph、静态 KV Cache 与算子融合减少 CPU 调度和显存读写开销。
最终,Alpamayo 1.5-10B 的单轨迹端到端延迟从 716.9 ms 降到 151.4 ms,加速 4.7 倍,规划频率从 1.4 Hz 提升到 6.6 Hz。单样本轨迹误差 minADE\(_1\) 从 1.705 m 改善到 1.573 m;六样本 oracle 指标 minADE\(_6\) 从 0.767 m 变为 0.844 m,退化约 0.08 m。
这里不能把结果简单概括成“加速而且精度完全不变”。更准确的说法是:FlashDrive 用很小的开放环候选覆盖损失换取了 4.7 倍端到端加速,而单轨迹误差反而下降;小规模闭环仿真中的碰撞、驶出道路和规划抖动指标改善,但 Wrong Lane 指标变差。 它把大型推理 VLA 推进到亚 200 ms 区间,却仍不是实车安全验证,也不等于车辆转向与制动只以 6.6 Hz 执行。
1. VLA Background: 从“看懂道路”到“输出可执行轨迹”
这一节先不讨论加速,先回答一个更基础的问题:自动驾驶 VLA 到底在做什么?
1.1 传统模块化自动驾驶与端到端 VLA
传统自动驾驶通常把系统拆成多个显式模块:
相机 / 激光雷达
    ↓
感知:车道线、车辆、行人、交通灯
    ↓
预测:其他交通参与者未来如何运动
    ↓
规划:自车应该走哪条轨迹
    ↓
控制:把轨迹转换成转向、油门和制动
这种方式的优点是接口清楚、容易单独测试;缺点是上游错误会传给下游,而且很难为所有长尾场景写完规则。例如,施工人员站在路中间挥手、临时路障迫使车辆借道、没有信号灯的复杂路口,都可能同时依赖视觉常识、交通语义与交互推理。
Vision-Language-Action Model 希望用一个统一模型把三类能力结合起来:
- Vision: 理解多相机、多帧道路画面;
- Language: 用语言 token 表达场景因果和驾驶意图;
- Action: 输出未来连续轨迹或控制动作。
可以把自动驾驶 VLA 抽象为:
$$ \pi_\theta: (\text{multi-view video},\text{route},\text{ego history}) \longrightarrow (\text{reasoning},\text{future trajectory}). $$这里的 Action 通常不是一个单词,也不一定直接是方向盘角度。FlashDrive 所研究的 Alpamayo 会预测未来若干秒的 trajectory waypoints,即一串带时间顺序的车辆位置与姿态。下游控制器再以更高频率跟踪这条轨迹。
因此,论文中的 6.6 Hz 更接近“大模型轨迹重规划频率”,不能理解成方向盘、制动器也只以 6.6 Hz 更新。车辆底层控制环仍可在两次 VLA 推理之间高频跟踪最近一条轨迹。
1.2 VLM 与 VLA 有什么区别?
假设输入是一张前方道路图片:
- VLM 可以回答:“前方有停止标志,右侧有一辆车驶向路口。”
- VLA 除了形成类似理解,还必须给出行动:“先减速,在停止线停车,让右侧车辆通过,然后继续直行”,并把它落成一条连续可跟踪的轨迹。
也就是说,VLA 比 VLM 多了一个关键约束:输出不仅要语义合理,还要在物理空间中可执行。
语言模型很容易说“停车让行”,但 Action Head 还要回答:
- 从当前速度开始应该以多大减速度接近停止线?
- 未来每个时刻车辆中心位于哪里?
- 轨迹是否留在车道内?
- 转弯曲率和车辆动力学是否合理?
1.3 Alpamayo 1.5 的一次推理经过哪些阶段?
FlashDrive 没有重新发明一个 VLA,而是在 Alpamayo 1.5-10B 的现有推理管线之上优化。一次典型输入包含 4 个相机视角 × 4 个时间帧,也就是 16 幅图像。完整路径可以简化为:
四路相机、每路四帧
        │
        ▼
1. Vision Encode
   图像 → 视觉特征 / 视觉 token
        │
        ▼
2. VLM Prefill
   读取系统提示、路线、自车历史和全部视觉 token
   建立 Transformer 的 KV Cache
        │
        ▼
3. Language Decode
   逐 token 生成 Chain-of-Causation 推理
        │
        ▼
4. Action Generation
   Flow Matching Action Expert 将隐藏表示变成连续轨迹
用一个停车场景来理解:
- Encode 把“停止标志、停止线、右侧来车、车道几何”转换为视觉 token;
- Prefill 让 VLM 在一次大规模并行前向中读完这些 token,并将注意力中的 Key/Value 存进缓存;
- Decode 逐个生成类似 “slow down for the stop sign and yield to cross traffic” 的推理 token;
- Action 从随机噪声出发,经过多步速度场更新,得到减速、停车和再次起步的连续路径。
1.4 Token、Prefill、Decode 与 KV Cache
图像不会以像素数组直接进入语言模型。视觉编码器先把图像切分和压缩成一串向量,每个向量可视为一个 视觉 token。路线文字、相机标签和驾驶推理则是 文本 token。Transformer 最终处理的是一个由不同模态 token 组成的长序列。
Prefill 是模型一次并行读取完整输入序列的阶段。对长度为 \(N\) 的序列,注意力需要建立 token 间的关系,并把每层的 Key 和 Value 保存为 KV Cache。
Decode 是之后逐 token 生成推理的阶段。已经存在的 \(N\) 个 token 不必全部重新前向计算,但每个新 token 仍要查询已有 KV Cache。假设推理共有 \(L\) 个 token,标准自回归过程是:
$$ p(y_{1:L}\mid x) {}={} \prod_{\ell=1}^{L} p(y_\ell\mid x,y_{1:\ell-1}). $$第 \(\ell\) 个 token 必须等前 \(\ell-1\) 个 token 生成后才能确定,这就是 Decode 难以并行的根源。
1.5 Action Head 与 Flow Matching
语言 token 是离散符号,轨迹坐标是连续值。Alpamayo 使用 Flow Matching Action Expert 把 VLM 的上下文表示 \(c\) 转成连续轨迹。
直观上,它先采样一个无结构的噪声轨迹:
$$ \mathbf x_0\sim\mathcal N(\mathbf 0,\mathbf I), $$再学习一个随时间变化的速度场:
$$ \frac{\mathrm d\mathbf x_t}{\mathrm dt} {}={} \mathbf v_\theta(\mathbf x_t,t;c), $$使噪声沿着常微分方程逐渐移动到合理轨迹分布。数值求解器将区间 \([0,1]\) 离散成多个步骤。8 步 Euler 更新可以写成:
$$ \mathbf x_{i+1} {}={} \mathbf x_i+\Delta t_i \mathbf v_\theta(\mathbf x_i,t_i;c), \qquad i=0,\ldots,7. $$每计算一次 \(\mathbf v_\theta\),都要运行一次 Action Expert。于是“只生成一条轨迹”并不意味着 Action 阶段只做一次网络前向。
1.6 一条轨迹与六条轨迹
驾驶场景通常存在多种合理未来。例如到达一个无保护左转路口时,车辆既可能等待,也可能在间隙足够大时通过。生成六条轨迹样本,是为了覆盖这种多模态不确定性。
但要注意:论文的 minADE\(_6\) 是在六条候选中,用真实未来轨迹做事后选择得到的 oracle 指标。它回答“六条候选中是否至少有一条接近真值”,而不回答在线系统是否一定能选中那一条。后文会给出正式定义。
2. Motivation: 瓶颈不是一个,而是四个
Alpamayo 1.5 在 RTX PRO 6000 上生成一条轨迹时的原始延迟为:
| Stage | Latency | 占总延迟 | 主要工作 |
|---|---|---|---|
| Encode | 87.0 ms | 12.1% | 编码 16 幅多视角、多帧图像 |
| Prefill | 165.3 ms | 23.1% | 读取长视觉序列并建立 KV Cache |
| Decode | 271.7 ms | 37.9% | 串行生成短 CoC 推理 |
| Action | 192.9 ms | 26.9% | 多步 Flow Matching 生成轨迹 |
| Total | 716.9 ms | 100% | 完整 VLA 推理 |
Decode 虽然最大,却只占 37.9%。即使假设 Decode 可以被免费消除,剩余阶段仍需要 445.2 ms,仅约 2.25 Hz。只量化语言模型也不能消除视觉重复和 Action Expert 的多步前向。
FlashDrive 的核心判断是:
VLA latency is a cascade of four bottlenecks, and each bottleneck hides a different kind of redundancy.
四种冗余分别是:
| Stage | 冗余来自哪里 | FlashDrive 的对应方法 |
|---|---|---|
| Encode | 相邻滑动窗口有 75% 画面重复 | 只编码最新帧 |
| Prefill | 重复视觉 token 再次建立 KV | Streaming KV Cache |
| Decode | 短而低熵的结构化推理仍串行生成 | DFlash Speculative Reasoning |
| Action | Flow Matching 中间速度几乎不变 | Adaptive Velocity Caching |
这也是文章最值得记住的方法论:先 profile 出每一段延迟,再针对该段真正存在的结构设计捷径。 一个适用于 Decode 的优化,未必适用于 Prefill;一个适用于语言 token 的缓存,也未必能直接用于连续轨迹去噪。
延迟 \(T_{\mathrm{ms}}\) 与规划频率的换算为:
$$ f_{\mathrm{Hz}} {}={} \frac{1000}{T_{\mathrm{ms}}}. $$因此:
$$ \frac{1000}{716.9}\approx1.39\ \mathrm{Hz}, \qquad \frac{1000}{151.4}\approx6.60\ \mathrm{Hz}. $$3. Encode & Prefill: Streaming Inference
3.1 滑动窗口为什么天然有 75% 重复?
设单个相机在时刻 \(t\) 使用四帧窗口:
$$ \mathcal W_t {}={} \{I_{t-3},I_{t-2},I_{t-1},I_t\}. $$下一时刻窗口变成:
$$ \mathcal W_{t+1} {}={} \{I_{t-2},I_{t-1},I_t,I_{t+1}\}. $$四帧中有三帧完全相同,只有 \(I_{t+1}\) 是新画面。对四个相机也是一样:旧方法每次重新编码 16 幅图像,实际只有四幅最新图像从未见过。
FlashDrive 因此执行三个操作:
- 淘汰每个视角最旧的一帧;
- 将其余三帧的缓存位置向前移动;
- 只编码并 Prefill 四个相机各自的最新一帧。
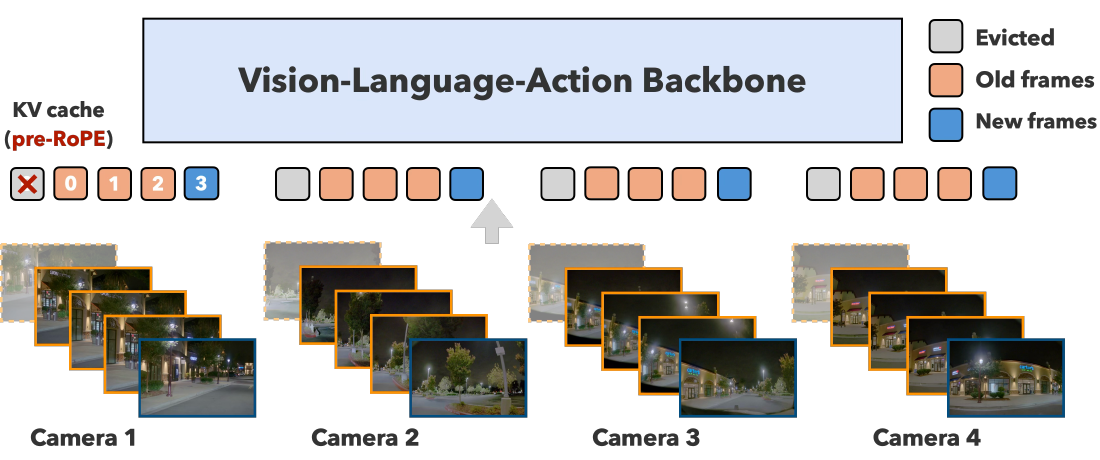
这看起来和聊天模型的 Prefix Cache 相似,但多相机 VLA 有两个额外难点:token 排列不是简单追加顺序,位置编码也会随窗口滑动而变化。
3.2 View-Major Ordering: 为什么不能把新帧直接放到末尾?
Alpamayo 1.5 按视角组织视觉 token。简化后的顺序是:
[Camera 1: f0 f1 f2 f3]
[Camera 2: f0 f1 f2 f3]
[Camera 3: f0 f1 f2 f3]
[Camera 4: f0 f1 f2 f3]
[trajectory history and text]
如果把四幅新图直接追加到序列末尾,顺序就会变成:
[Camera 1 old frames] ... [Camera 4 old frames]
[Camera 1 new] [Camera 2 new] [Camera 3 new] [Camera 4 new]
这与模型训练时见过的布局不同。FlashDrive 必须把每个新帧 token 写入对应视角的“最后一帧槽位”,同时只让这些新 token 作为 Query 进行计算。
标准注意力为:
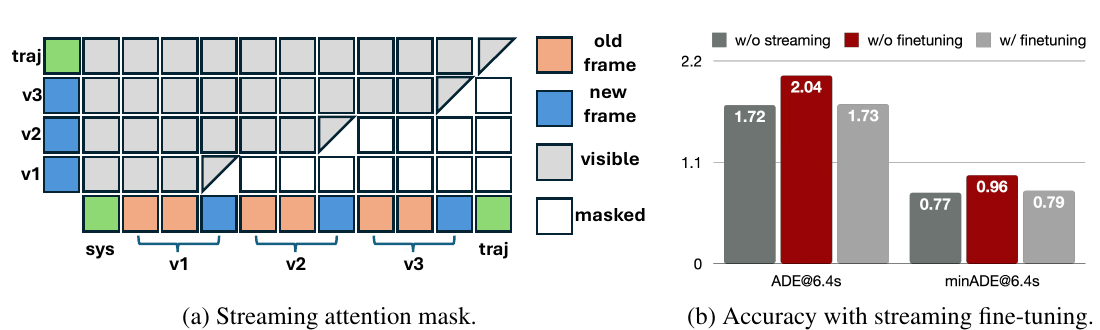
$$ \operatorname{Attn}(\mathbf Q,\mathbf K,\mathbf V) {}={} \operatorname{softmax} \left( \frac{\mathbf Q\mathbf K^\top}{\sqrt d} +\mathbf M \right)\mathbf V, $$其中 \(\mathbf M\) 是 attention mask。FlashDrive 构造专用 mask,使:
- 每个最新帧可以看见 system token;
- Camera \(j\) 的最新帧可以看见此前视角的可见 token;
- 它可以看见本视角的三个历史帧,并在当前帧内部保持因果关系;
- 最后的轨迹与文本 token 可以看见全部视角,并在自身区间保持因果关系;
- 只有最新帧与末尾轨迹/文本形成新 Query,历史帧只提供缓存的 Key/Value。
3.3 RoPE Position Shift: 缓存的 Key 为什么会“过期”?
Transformer 的 Rotary Position Embedding 将位置 \(p\) 旋转进 Query 与 Key。简化写成:
$$ \mathbf q_p^{\mathrm{rope}} {}={} \mathbf R(p)\mathbf q_p, \qquad \mathbf k_p^{\mathrm{rope}} {}={} \mathbf R(p)\mathbf k_p. $$假设旧窗口中的帧位于位置 \(p\)。窗口向前滑动后,它可能应该出现在 \(p-\Delta\)。若缓存保存的是已经做过 RoPE 的 \(\mathbf R(p)\mathbf k_p\),直接搬动缓存不会把旋转改成 \(\mathbf R(p-\Delta)\),于是 token 内容虽然相同,位置语义却错了。
FlashDrive 的解决方法是:
- 缓存 pre-RoPE Key,即还未乘 \(\mathbf R(p)\) 的 Key;
- 窗口滑动后,根据新位置即时重新应用 RoPE;
- Value 不包含这种旋转位置,因此可以直接平移复用。
这一步非常关键。普通文本生成时,历史 token 位置通常不变;滑动视频窗口则会不断淘汰旧帧并整体改写保留帧的位置。
3.4 为什么复用 KV Cache 仍然只是近似?
即使 token 内容和位置都处理正确,Streaming KV Cache 仍不等价于重新运行完整窗口。
原因是历史帧的 Key/Value 最初是在旧上下文中计算的。完整重算时,同一历史帧可能通过注意力与当前窗口中的其他 token 重新交互,产生略有不同的隐藏状态;缓存复用保留的是旧隐藏状态。
可以写成:
$$ (\mathbf K_i,\mathbf V_i)_{\mathrm{cached}} \neq (\mathbf K_i,\mathbf V_i)_{\mathrm{full\ forward\ at}\ t+1}. $$论文发现,不做适配时:
- minADE\(_1\) 约恶化 0.3 m;
- minADE\(_6\) 约恶化 0.2 m。
这种分布偏移主要伤害 Action Expert,而不是语言推理头。原因是:
- 语言 token 自回归生成,通常更依赖最近 token,对少量旧缓存误差较鲁棒;
- Action Expert 通过 cross-attention 汇聚整个 KV Cache 来输出连续坐标,小误差可能在多步 Flow Matching 中累积。
3.5 Streaming Fine-Tuning: 为什么只微调 Action Expert?
一个看似自然的方案是微调整个 VLM,让它适应流式缓存。但附录结果显示,这反而把 minADE\(_1\) 推高到 4.69 m,显著差于完全不微调的 2.04 m。
作者采用针对性的 teacher-forcing rollout:
- 冻结整个 VLM backbone;
- 随机采样长度为 \(L\) 的滑动窗口序列;
- 前 \(L-1\) 步使用真实历史画面运行流式推理,只建立会逐步积累近似误差的 KV Cache,不保留梯度;
- 只在最后一步启用梯度;
- 用真实未来轨迹监督 Action Expert。
训练目标可概括为:
$$ \min_{\phi} \mathbb E \left[ \mathcal L_{\mathrm{action}} \left( A_{t+L-1}, \hat A_{\phi} \bigl( \widetilde{\mathrm{KV}}_{t:t+L-1} \bigr) \right) \right], $$其中 \(\phi\) 只表示 Action Expert 参数,\(\widetilde{\mathrm{KV}}\) 表示经过多轮真实流式执行后得到的近似缓存。
随机改变 \(L\) 的意义是让 Action Expert 同时见到“刚开始流式复用”和“误差已经积累多轮”的情况。最终它将 Streaming 的误差恢复到 1.73 minADE\(_1\) / 0.79 minADE\(_6\),接近非流式基线的 1.72 / 0.77。
| Streaming 训练方式 | minADE\(_1\) | minADE\(_6\) | 结论 |
|---|---|---|---|
| Full baseline | 1.72 | 0.77 | 不使用流式近似 |
| Streaming, no fine-tuning | 2.04 | 0.96 | 缓存分布偏移明显 |
| Fine-tune VLM | 4.69 | 2.98 | 破坏已有推理表示 |
| Fine-tune Action Expert | 1.73 | 0.79 | 几乎恢复基线 |
3.6 Streaming 带来了多少加速?
在系统优化基线上,Streaming Inference 将:
- Encode:40.5 ms 降到 12.0 ms,约 3.4 倍;
- Prefill:188.3 ms 降到 59.6 ms,约 3.2 倍;
- 端到端:513.3 ms 降到 355.8 ms。
它没有直接加速 Decode 和 Action;这正是还需要后两种算法的原因。
4. Decode: Speculative Reasoning with DFlash
4.1 为什么只有约 16 个 token,Decode 仍然最慢?
原始 Decode 需要 271.7 ms,占完整推理的 37.9%,吞吐只有 56.4 token/s。虽然驾驶 CoC 通常只有约 16 个 token,但每个 token 都需要一次目标模型前向,且单 batch 下大量小 kernel 会放大调度开销。
更重要的是,驾驶推理与开放式写作不同。输入画面已经强烈约束了合理答案:
场景:前方停止标志,右侧车辆正穿过路口

可能推理:
slow down → stop at the line → yield to cross traffic
候选不会突然变成一段诗歌或无关代码。论文认为它有两个适合 speculative decoding 的性质:
- Low per-token entropy: 每一步可接受的下一个 token 很少;
- Strong intra-block correlation: “stop sign” 一旦出现,后续 “yield / crossing vehicle / slow down” 高度相关。
4.2 推测式解码不是“让小模型替大模型做决定”
标准推测式解码包含一个快速 Drafter 和一个原始 Target Model:
- Drafter 先提出多个候选 token;
- Target 用一次并行前向计算这些位置的概率;
- 按严格接受/拒绝规则保留最长合法前缀;
- 第一个被拒绝的位置由 Target 分布纠正;
- 从新的前缀继续下一轮。
只要验证规则正确,最终输出仍服从 Target Model 的分布。Drafter 只是在猜 Target 接下来可能说什么,并没有越过 Target 验证。因此 speculative decoding 的质量保证与“直接用小模型替换大模型”完全不同。
举例说,Drafter 一次提出 8 个 token:
slow | down | for | the | stop | sign | ahead | .
如果 Target 只接受前 6 个,那么一次验证仍推进了 6 个 token;第 7 个位置按 Target 规则重新采样,而不是无条件采用错误草稿。平均每轮接受越长,减少的 Target 串行调用越多。
4.3 为什么使用扩散式 Block Drafter?
普通 Drafter 仍按自回归方式逐 token 猜 8 次。DFlash 使用 Diffusion Language Model,把一个 8-token mask block 视为整体,在一次草稿前向中并行提出整个候选块:
$$ [\texttt{MASK}]^8 \xrightarrow{\text{DFlash Draft}} [\tilde y_1,\tilde y_2,\ldots,\tilde y_8]. $$由于块内 token 彼此强相关,整体预测比八次独立贪心猜测更适合结构化驾驶推理。FlashDrive 的 Drafter 只有 2 层,block size 为 8,使用约 60K clips 训练。
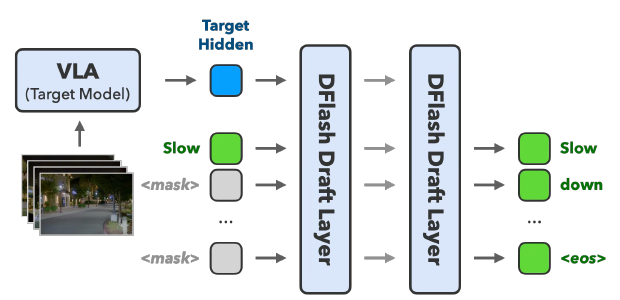
Target Model 最近 token 的隐藏状态已经同时包含视觉场景、路线和当前推理进度。FlashDrive 不像通用 DFlash 那样融合大量 Target 中间表示,而只将最近 8 个 Target token 的 hidden states 融入 Drafter KV Cache,以降低草稿与验证成本。
4.4 DFlash 的收益与 Block Size 消融
最终平均每轮接受 5.6 token:
- Decode latency:271.7 ms 降至 58.2 ms;
- 相对原始实现加速 4.7 倍;
- 相对系统优化后的 170.6 ms 加速 2.9 倍;
- 吞吐:56.4 token/s 提升到 254.4 token/s。
附录还比较了 block size \(B=8\) 与 \(B=16\)。更大的块平均可以接受约 8 个 token,但草稿与验证也更贵,因此总延迟没有稳定下降:
| GPU | \(B=8\) latency | \(B=16\) latency | \(B=8\) throughput | \(B=16\) throughput |
|---|---|---|---|---|
| RTX 4090 | 208.6 ms | 215.2 ms | 246.2 tok/s | 230.8 tok/s |
| RTX PRO 6000 | 159.4 ms | 154.4 ms | 317.5 tok/s | 305.0 tok/s |
这说明 speculative decoding 不是“候选块越长越好”。Block 太短,Target 推进不够;Block 太长,大量候选最终被拒绝,草稿和验证计算被浪费。论文选择 \(B=8\) 作为更均衡的默认配置。
5. Action: Adaptive-Step Flow Matching
5.1 为什么直接把 8 步改成 4 步不够?
最直接的 Action 加速方案是均匀减少 ODE 求解步数。但这隐含一个假设:去噪路径上每个区间同样重要。
作者比较相邻两步的速度向量 \(\mathbf v_i\) 与 \(\mathbf v_{i+1}\),使用两个指标:
$$ r_i {}={} \frac{ \lVert\mathbf v_{i+1}-\mathbf v_i\rVert_2 }{ \lVert\mathbf v_i\rVert_2 }, $$以及:
$$ s_i {}={} \frac{ \mathbf v_{i+1}^{\top}\mathbf v_i }{ \lVert\mathbf v_{i+1}\rVert_2 \lVert\mathbf v_i\rVert_2 }. $$其中 \(r_i\) 越小,表示速度大小和方向变化越小;\(s_i\) 越接近 1,表示两个速度方向越相似。
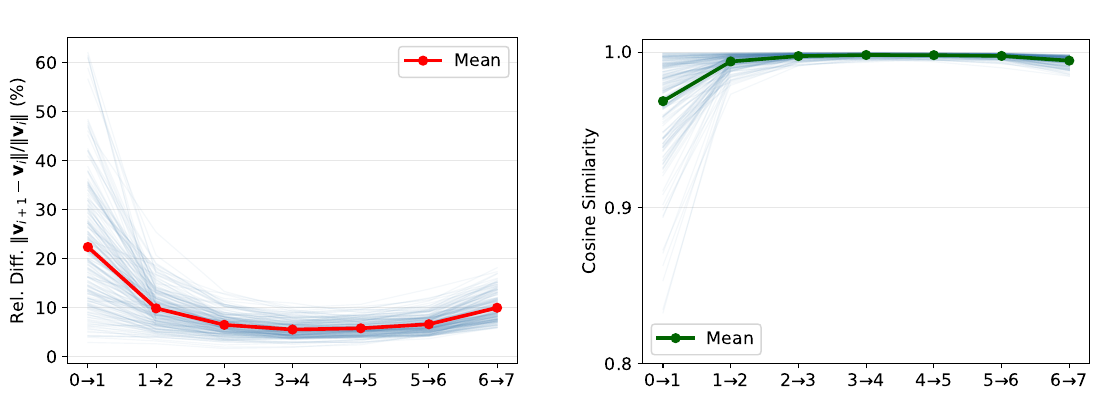
实验呈现非常明显的结构:
- 相对差异是 U 形:首尾大,中间小;
- 余弦相似度是 倒 U 形:首尾低,中间接近 1。
因此真正冗余的不是任意四步,而是中间的连续区域。
5.2 首尾步骤为什么更重要?
论文给出一个很直观的物理解释:
- 早期步骤: 决定粗粒度拓扑,例如选哪条车道、直行还是转弯、从噪声中形成大致轨迹;
- 中间步骤: 在已经确定的大方向上进行小幅平滑,速度场几乎不变;
- 末尾步骤: 将结果拉回物理可行轨迹流形,满足道路几何、车辆运动学和局部精度要求。
可以把它类比为画一条转弯曲线:最开始要决定向左还是向右,最后要把曲线准确接到目标车道,中间几笔往往只是沿着已经决定的弧度延伸。
5.3 Adaptive Velocity Caching
FlashDrive 保留 8 个 Euler 更新,但并非 8 步都重新运行 Action Expert。官方实现的配置是:
DIFFUSION_STEPS = 8
CACHE_STEPS = [3, 4, 5, 6]
也就是说,步骤 0、1、2 和 7 计算新速度;中间步骤 3 到 6 复用最近一次新鲜速度。更新写成:
$$ \widetilde{\mathbf v}_i {}={} \begin{cases} \mathbf v_\theta(\mathbf x_i,t_i;c), & i\notin\mathcal C,\\ \widetilde{\mathbf v}_{i-1}, & i\in\mathcal C, \end{cases} \qquad \mathcal C=\{3,4,5,6\}. $$随后仍然执行:
$$ \mathbf x_{i+1} {}={} \mathbf x_i+\Delta t_i\widetilde{\mathbf v}_i. $$因此它跳过的是昂贵的网络前向,不是把四个 ODE 时间区间直接删除。轨迹仍经过 8 次数值更新,时间网格保持不变。
在系统优化基线上:
- Action latency:113.9 ms 降到 47.6 ms;
- Action 阶段加速 2.4 倍;
- minADE\(_6\) 增加约 0.04 m;
- minADE\(_1\) 反而改善约 0.14 m。
论文认为,少做冗余中间修正可能起到数值正则化作用,减少 ODE 求解器的累积误差。但应将其理解为本实验中的现象,而不是“缓存速度一定提升轨迹精度”的普遍结论。
6. Quantization: 为什么 W4A16 还不够?
6.1 W4A8 的记号
量化记号中的:
- \(W4\):模型权重使用 4-bit;
- \(A8\):矩阵乘法输入激活使用 8-bit;
- BF16:16-bit Brain Floating Point。
Alpamayo 1.5-10B 在 FP16 下生成六条轨迹约占 31.6 GB。只有高端工作站卡才能轻松容纳,对 Jetson 或消费级 GPU 很不友好。
6.2 Prefill 与 Decode 为什么需要不同优化?
Decode 常常 memory-bound。 每次只生成一个新 token,矩阵维度较小,GPU 花很多时间从显存读取大规模权重。把权重从 16-bit 压到 4-bit 可以显著减少带宽压力。
Prefill 常常 compute-bound。 一次要处理数千个视觉 token,形成较大的矩阵乘法。只有权重 4-bit、激活仍 16-bit 的 W4A16 无法充分使用高速 INT8 Tensor Core 路径。
因此 FlashDrive 使用:
| Format | Weight | Activation | Decode | Prefill |
|---|---|---|---|---|
| BF16 | 16-bit | 16-bit | 基线 | 基线 |
| W4A16 | 4-bit | 16-bit | 减少权重带宽 | 收益有限 |
| W4A8 | 4-bit | 8-bit | 减少带宽 | 使用更快的 INT8 GEMM |
具体实现采用 ParoQuant 处理权重离群值,再用 W4A8 Marlin kernel 执行。连续轨迹对数值误差更敏感,因此 Action Expert 保留 BF16,只量化语言骨干。
最终:
- 显存从约 31.6 GB 降至约 18.3 GB;
- 在前三种算法已经把延迟降到 176.0 ms 后,量化进一步降至 151.4 ms;
- Prefill 从 58.9 ms 降到 47.2 ms;
- Decode 从 57.5 ms 降到 45.3 ms。
量化贡献的端到端下降约 24.6 ms,比例没有 Streaming 或 DFlash 那么大,但它同时扩大了可部署硬件范围,并让六轨迹设置在 RTX 3090/4090 上从 OOM 变为可运行。
7. System Optimizations: 算法减少计算,系统减少开销
7.1 CUDA Graph
GPU 程序通常由 CPU 逐个发射 kernel。VLA 同时包含 Vision Encoder、长序列 Prefill、许多单 token Decode 和多步 Action Expert,kernel 类型多且单次 batch 小。Decode 时 GPU 计算可能很快,反而经常等待 CPU 发射下一项工作。
CUDA Graph 会先记录固定形状下的 kernel 序列,之后用一次 GPU-side replay 重放完整流程。它特别适合:
- 输入 shape 可静态化;
- 同一执行模式反复出现;
- 单个 kernel 很短,但数量很多。
官方实现还使用静态 KV Cache,为 CUDA Graph 提供稳定地址与张量形状。
7.2 Kernel Fusion
Transformer 中 Q、K、V 投影常被实现为三次独立 kernel:
$$ \mathbf Q=\mathbf X\mathbf W_Q, \qquad \mathbf K=\mathbf X\mathbf W_K, \qquad \mathbf V=\mathbf X\mathbf W_V. $$FlashDrive 将其合并成一次更大的投影和 kernel 发射;MLP 的 gate projection 与 up projection 也采用相同思路。Max-autotune 进一步合并连续的 element-wise 与 reduction 操作,减少中间结果写回显存。
7.3 系统优化的边界
CUDA Graph 与 Fusion 将总延迟从 716.9 ms 降到 513.3 ms,获得 1.40 倍加速。但收益并不均匀:
| Stage | Baseline | System Optimized | 变化 |
|---|---|---|---|
| Encode | 87.0 | 40.5 | 明显改善 |
| Prefill | 165.3 | 188.3 | 测得增加 23.0 ms |
| Decode | 271.7 | 170.6 | 明显改善 |
| Action | 192.9 | 113.9 | 明显改善 |
论文指出,Prefill 主要由一个很大的矩阵乘法主导,kernel launch 不是主要开销;表中 23 ms 增加处于单 batch 测量方差范围,不能据此说系统优化会稳定拖慢 Prefill。这个结果反而说明:系统级优化擅长消除调度与访存开销,但不能替代真正减少计算量的算法。
8. Experimental Setup
8.1 Model 与 Dataset
主实验模型是 Alpamayo 1.5-10B,附录还验证了 Alpamayo 1,也就是此前发布的 Alpamayo-R1-10B。
数据来自 NVIDIA Autonomous Vehicle Dataset:
- Streaming Fine-Tuning:从不同数据块采样约 4K clips,每个 clip 最多抽取 150 个样本,合计约 600K training samples;
- DFlash Drafter:从约 60K clips 中各采样一个窗口;
- Evaluation:采样 100 clips,按 10 FPS 提取滑动窗口,每个 clip 120 个窗口,共 12K samples。
Streaming 微调使用随机起点与随机 rollout 长度,让 Action Expert 看到不同程度的缓存误差积累。
8.2 ADE 与 minADE
设真实未来平面位置为 \(\mathbf g_t\),第 \(k\) 条预测轨迹为 \(\hat{\mathbf g}^{(k)}_t\),预测包含 \(T\) 个时间点。单条轨迹的 Average Displacement Error 为:
$$ \operatorname{ADE}_k {}={} \frac{1}{T} \sum_{t=1}^{T} \left\lVert \hat{\mathbf g}^{(k)}_t-\mathbf g_t \right\rVert_2. $$\(K\) 条样本的 minADE 为:
$$ \operatorname{minADE}_K {}={} \min_{1\le k\le K} \operatorname{ADE}_k. $$论文报告的预测 horizon 是 6.4 s:
- minADE\(_1\)@6.4s: 只生成一条轨迹,直接计算其误差;
- minADE\(_6\)@6.4s: 生成六条轨迹,事后挑选最接近真实未来的一条。
minADE\(_6\) 通常更低,因为它有六次机会。它主要衡量候选集合的覆盖能力,不等于在线规划器实际选择后的误差。
8.3 Open-Loop 与 Closed-Loop
Open-loop evaluation 使用记录好的真实传感器数据。模型预测不会反过来改变下一帧画面。优点是可重复、便于大规模比较;缺点是无法观察小误差经过车辆运动后如何积累。
Closed-loop evaluation 把模型放入 AlpaSim。模型输出改变车辆下一时刻位置,新的场景再反馈给模型。它更接近真实控制,但仿真器、场景数量和交通建模也会限制结论。
9. Main Results
9.1 端到端消融:每一项分别解决什么?
下表是论文 Table 1 的完整结果,硬件为 RTX PRO 6000,生成一条轨迹。为避免窄屏横向溢出,将同一张原表拆成延迟与准确率两部分。
Latency breakdown,单位为 ms;Tok/s 是 Decode 吞吐:
| Configuration | Encode | Prefill | Decode | Tok/s | Action | Total |
|---|---|---|---|---|---|---|
| Alpamayo 1.5 | 87.0 | 165.3 | 271.7 | 56.4 | 192.9 | 716.9 |
| + System Optimizations | 40.5 | 188.3 | 170.6 | 89.5 | 113.9 | 513.3 |
| + Streaming Inference | 12.0 | 59.6 | 170.5 | 89.5 | 113.8 | 355.8 |
| + Speculative Reasoning | 40.7 | 187.3 | 58.2 | 254.4 | 115.0 | 401.3 |
| + Adaptive-Step Flow Matching | 40.9 | 188.3 | 173.6 | 89.1 | 47.6 | 450.4 |
| + All above | 12.1 | 58.9 | 57.5 | 255.6 | 47.5 | 176.0 |
| + Quantization | 12.0 | 47.2 | 45.3 | 326.9 | 46.9 | 151.4 |
对应的轨迹误差:
| Configuration | minADE\(_1\) | minADE\(_6\) |
|---|---|---|
| Alpamayo 1.5 | 1.705 | 0.767 |
| + System Optimizations | 1.673 | 0.770 |
| + Streaming Inference | 1.697 | 0.791 |
| + Speculative Reasoning | 1.633 | 0.777 |
| + Adaptive-Step Flow Matching | 1.536 | 0.812 |
| + All above | 1.563 | 0.850 |
| + Quantization | 1.573 | 0.844 |
必须正确理解表中的加号:
- Streaming、Speculative、Adaptive 三行都是 各自单独叠加在 System Optimizations 上;
- 它们并不是从上一行继续累加;
- 只有 All above 才把三种算法同时启用;
- 最后一行再在 All above 上加入 W4A8。
因此可以看到非常清晰的“对症优化”:
- Streaming 只显著改变 Encode 与 Prefill;
- DFlash 只显著改变 Decode;
- Adaptive Flow Matching 只显著改变 Action;
- 三者组合时没有抢夺同一份收益,延迟下降可以累积。
算法优化将 513.3 ms 的系统基线进一步降到 176.0 ms,节省 337.3 ms;W4A8 再节省 24.6 ms。最终每一段都落在约 12–47 ms 范围内,不再有一个阶段独占大多数时间。
9.2 准确率应该怎样解读?
最终结果:
$$ \operatorname{minADE}_1: 1.705\longrightarrow1.573, $$$$ \operatorname{minADE}_6: 0.767\longrightarrow0.844. $$前者改善 0.132 m,后者恶化 0.077 m。两者方向不同并不矛盾:
- 单次采样的中心质量可能因 Streaming 微调和 Adaptive Caching 的正则化效应而提高;
- 六次采样的多样性或尾部覆盖可能略有下降,使 oracle 最优样本不如原模型。
论文把 0.08 m 除以 6.4 s,得到约 1.2 cm/s,并认为低于车道级规划容差。需要谨慎理解:ADE 是多个未来时刻的平均空间距离,不是一个严格的恒定横向漂移速度;这个换算只是帮助建立误差量级直觉。
9.3 Cross-Device Deployment
生成一条轨迹:
| Device | Baseline | FlashDrive | Speedup |
|---|---|---|---|
| Jetson Thor | 3770.3 | 943.6 | 4.0× |
| RTX 3090 | 1891.9 | 382.3 | 4.9× |
| RTX 4090 | 1307.1 | 217.2 | 6.0× |
| RTX 5090 | 878.1 | 183.7 | 4.8× |
| RTX PRO 6000 | 716.9 | 151.4 | 4.7× |
生成六条轨迹:
| Device | Baseline | FlashDrive | Speedup |
|---|---|---|---|
| Jetson Thor | 14596.5 | 1522.6 | 9.6× |
| RTX 3090 | OOM | 694.8 | — |
| RTX 4090 | OOM | 404.1 | — |
| RTX 5090 | 3163.5 | 317.9 | 10.0× |
| RTX PRO 6000 | 2609.8 | 245.8 | 10.6× |
单位均为 ms。单样本在五种设备上获得 4.0–6.0 倍加速。六样本加速更大,并让 RTX 3090/4090 从 OOM 变为可运行。
论文没有把六样本额外收益完全拆解;一个合理推断是,多样本会放大 Action Expert 的并行计算与显存占用,因此 W4A8、共享上下文和 Action Caching 的相对收益更明显。但这是根据结果做的系统层解释,不应当作论文已经严格证明的因果结论。
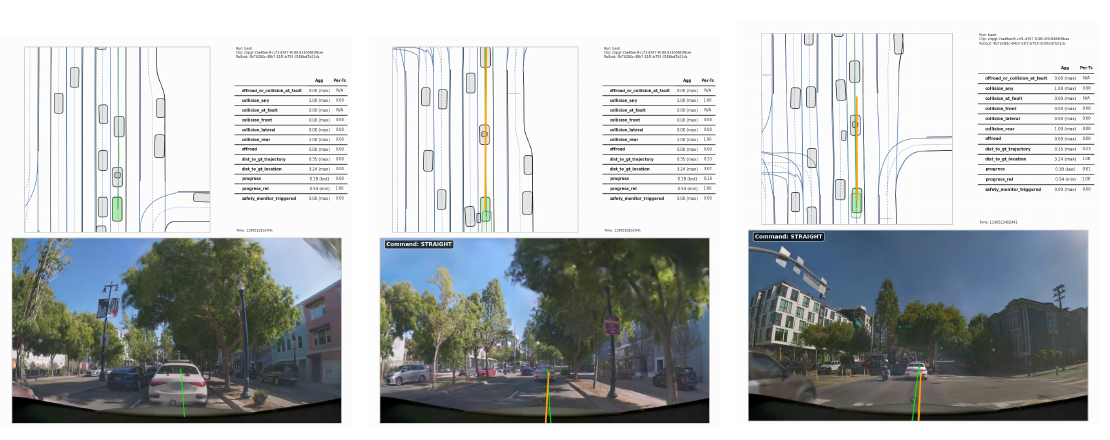
9.4 Closed-Loop AlpaSim
闭环实验使用 100 个随机 clips:
| Metric | Alpamayo 1.5 | FlashDrive | 趋势 |
|---|---|---|---|
| \(D_{\mathrm{traj}}\) ↓ | 20.0 | 22.4 | 变差 |
| \(D_{\mathrm{loc}}\) ↓ | 35.2 | 32.8 | 改善 |
| \(P_{\mathrm{rel}}\) ↑ | 0.85 | 0.85 | 持平 |
| Collision ↓ | 0.19 | 0.15 | 改善 |
| Off Road ↓ | 0.41 | 0.32 | 改善 |
| Wrong Lane ↓ | 0.45 | 0.51 | 变差 |
| Plan Deviation ↓ | 0.24 | 0.16 | 改善 |
| Per-step Latency ↓ | 1150 ms | 463 ms | 2.5× |
几个指标的含义:
- \(D_{\mathrm{traj}}\):自车到完整真实轨迹的距离;
- \(D_{\mathrm{loc}}\):自车到时间对齐真实位置的距离;
- \(P_{\mathrm{rel}}\):沿真实路线取得的相对进度;
- Collision / Off Road / Wrong Lane:整个 rollout 中是否发生对应事件;
- Plan Deviation:连续两次规划在重叠未来时刻的 L2 差异,越低表示计划越稳定。
FlashDrive 的碰撞率、驶出道路率和计划抖动都下降,说明小幅开放环误差没有在这组仿真中放大成明显闭环退化。但也必须看到:
- \(D_{\mathrm{traj}}\) 从 20.0 增加到 22.4;
- Wrong Lane 从 0.45 增加到 0.51;
- Wrong Lane 对路口和并线处的车道几何很敏感,本身可能噪声较大;
- 只有 100 个 clips,论文没有提供置信区间和显著性检验。
所以这组结果支持“没有观察到整体闭环安全退化”,却不足以证明“FlashDrive 已通过真实道路安全验证”。
10. Additional Results and Ablations
10.1 Alpamayo 1 / R1 上是否仍有效?
| Model | Total Latency | minADE\(_1\) | minADE\(_6\) |
|---|---|---|---|
| Alpamayo 1 | 703.8 ms | 1.869 | 0.800 |
| + FlashDrive | 155.4 ms | 1.662 | 0.910 |
FlashDrive 在上一代模型上仍有 4.5 倍加速,说明四段优化不只绑定 Alpamayo 1.5 的某个偶然实现。但 minADE\(_6\) 退化 0.110 m,比 Alpamayo 1.5 的 0.077 m 更大,也提醒我们不同 backbone 对近似计算的容忍度不同。
10.2 为什么 Fine-Tune VLM 会失败?
附录最有信息量的负结果就是:微调整个 VLM 比完全不微调更差。
一个合理解释是,流式近似的主要消费者是 Action Expert,而 VLM 已经拥有成熟的视觉—语言对齐和推理表示。用有限的 4K clips 调整整个大骨干,既难以精确校准每层缓存误差,又可能破坏原有表示;只训练 Action Expert 则直接优化最终连续输出,并减少可训练参数与灾难性遗忘风险。
这也体现一种实用原则:不要因为误差出现在共享表示中,就默认要更新产生表示的所有层;应先找出真正对误差敏感的下游模块。
10.3 Qualitative Example
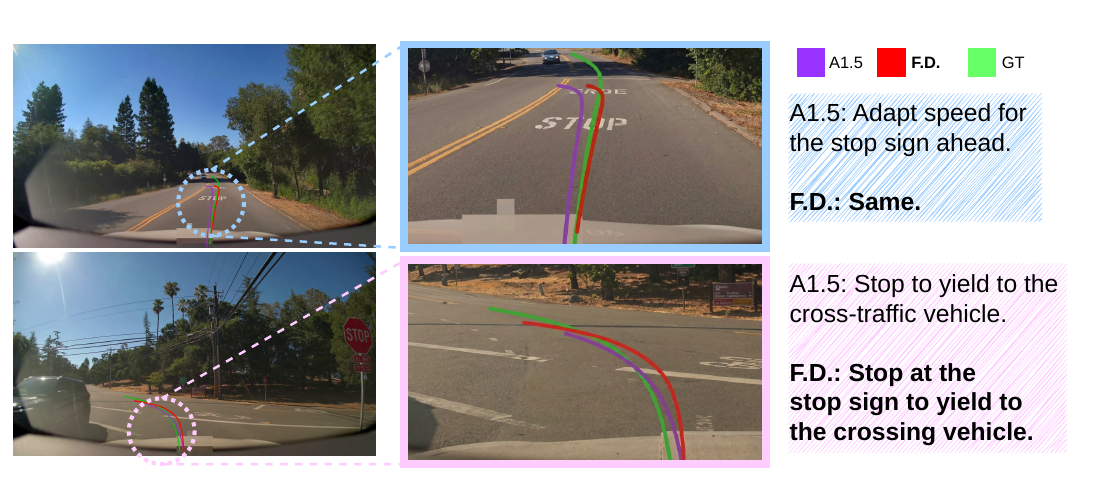
附录展示了两类场景:
- Longitudinal Straight Driving: 两者都识别前方停止标志并调整速度;
- Oncoming Vehicle Encounter: 两者都判断应停车让行,FlashDrive 的 CoC 明确提到 crossing vehicle。
图中紫色是 Alpamayo 1.5,红色是 FlashDrive,绿色是真实轨迹。两个示例中,FlashDrive 轨迹更靠近真值,语言推理没有因 DFlash 或 W4A8 产生明显语义偏移。
定性图只能说明方法在这些案例中行为合理,不能代替 12K 开放环样本和闭环指标;它的主要价值是帮助确认“数字上的 minADE 变化”对应怎样的实际道路轨迹。
11. Implementation Map
官方仓库已经开源完整优化路径。若要对照论文读代码,可以按下面的映射:
| Paper Component | Main File | 关键实现 |
|---|---|---|
| Streaming Inference | flashdrive/streaming.py | View-major mask、窗口转换、KV 平移 |
| DFlash | flashdrive/dflash.py | Block drafter、Target 验证、接受前缀 |
| Adaptive Flow Matching | flashdrive/diffusion.py | Euler 更新与 cache steps |
| W4A8 | flashdrive/quantization.py | ParoQuant rotation 与 Marlin linear |
| System Compilation | flashdrive/_compile.py | torch.compile 与 CUDA Graph |
| Kernel Fusion | flashdrive/fusion.py | Expert projection fusion |
| Benchmark | scripts/infer.py | 四帧窗口、8 步 diffusion、缓存步骤 3–6 |
官方基准脚本的优化配置明确写为:
MAX_NEW_TOKENS = 128
DIFFUSION_STEPS = 8
CACHE_STEPS = [3, 4, 5, 6]
使用优化 checkpoint 的基本入口是:
python scripts/infer.py --model-path z-lab/Alpamayo-1.5-10B
使用 NVIDIA 原始 checkpoint 会运行未优化基线:
python scripts/infer.py --model-path nvidia/Alpamayo-1.5-10B
需要注意:
- 代码使用 MIT License;
- Alpamayo 权重继续遵循 NVIDIA 的 non-commercial license;
- 官方环境要求 Python 3.12、CUDA 12.8,以及 compute capability 8.0 以上的 NVIDIA GPU;
- 第一个 Streaming window 只负责填充完整 KV Cache,不返回轨迹;从后续窗口开始才产生流式输出。
12. Limitations
12.1 Streaming Cache 不是精确等价变换
DFlash 的严格验证可以保持 Target token 分布,但 Streaming KV Cache 会保留旧上下文下计算的隐藏状态,本质上是近似。Action Expert 微调把误差降到很小,却没有数学上的无损保证。若视频窗口长度、相机布局、天气或交通分布明显改变,可能需要重新校准。
12.2 训练与部署仍绑定特定输入结构
当前实现假设典型的四视角、四帧、view-major 输入,并针对 Alpamayo 家族做系统工程。论文认为方法可以迁移到同样具有 Encode–Prefill–Decode–Action 结构的 VLA,但不同模型的 token 排列、位置编码、Action Head 与量化敏感性都需要单独适配。
12.3 6.6 Hz 不是完整自动驾驶实时性的终点
151.4 ms 已经进入城市轨迹重规划的实用区间,但真实车辆系统还包括:
- 相机采集与同步;
- 图像预处理和数据传输;
- 路线与地图输入;
- 轨迹筛选和安全约束;
- 下游控制器;
- 故障检测与冗余系统。
论文基准主要测模型 rollout,不等于传感器到执行器的完整车辆端到端延迟。低层稳定控制仍需要更高频率运行。
12.4 Closed-Loop 证据仍有限
AlpaSim 的 100 clips 说明加速没有明显破坏这组仿真任务,但不覆盖真实道路的传感器噪声、极端天气、硬件故障和复杂人类驾驶行为。Collision 改善也不能直接外推成真实事故率下降。
12.5 最终选择哪条候选轨迹仍是另一个问题
minADE\(_6\) 使用真值事后选择最佳候选。实际部署时真值未知,还需要一个 planner、ranker 或 cost function 在候选间做选择。FlashDrive 加速的是候选生成,不直接解决候选评分与安全过滤。
12.6 组件越多,工程复杂度越高
FlashDrive 同时需要:
- 流式缓存布局与位置修正;
- Action Expert 的 Streaming Fine-Tuning;
- 单独训练的 DFlash Drafter;
- 特定 W4A8 checkpoint 和 kernel;
- 静态 shape、CUDA Graph 与算子融合。
4.7 倍来自多种收益叠加,也意味着复现和维护成本高于一个单独的量化或剪枝方法。
13. How to Remember FlashDrive
可以用下面这张表建立最终心智模型:
| 问题 | 直觉例子 | FlashDrive |
|---|---|---|
| 画面重复 | 四帧窗口向前滑一步,三帧没变 | 只编码最新帧 |
| KV 重复 | 旧画面已经被 Transformer 读过 | 移动并复用 pre-RoPE KV |
| 推理串行 | “stop at the sign” 高度可预测,却逐字生成 | DFlash 一次提出 8-token block |
| 去噪重复 | 中间四步速度方向几乎相同 | 复用中间速度,只重算首尾 |
| 数值冗余 | BF16 对语言骨干过于保守 | VLM W4A8,Action Expert BF16 |
| 调度冗余 | CPU 反复发射许多小 kernel | CUDA Graph 与 Fusion |
完整优化后的阶段变化是:
$$ \begin{aligned} \text{Encode:}\quad &87.0 \rightarrow 12.0\ \mathrm{ms},\\ \text{Prefill:}\quad &165.3 \rightarrow 47.2\ \mathrm{ms},\\ \text{Decode:}\quad &271.7 \rightarrow 45.3\ \mathrm{ms},\\ \text{Action:}\quad &192.9 \rightarrow 46.9\ \mathrm{ms}. \end{aligned} $$FlashDrive 最重要的贡献不只是一个 151.4 ms 数字,而是一套 profile-then-exploit 的思路:
- 不把异构推理链路粗略概括成“大模型计算量大”;
- 找出每个阶段真正存在的冗余结构;
- 让算法捷径与该阶段的计算性质匹配;
- 用系统优化消除剩余调度开销;
- 最后用开放环、闭环和跨设备实验分别检查准确率、控制行为与部署性。
它也给出了一个清楚的边界:FlashDrive 让推理型 VLA 更接近实时部署,但没有单独解决实车安全、候选轨迹选择和完整传感器到执行器延迟。把这两句话同时记住,才是对论文结论最准确的概括。