FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution
Status: arXiv v1, 2026-08-17
Paper: https://arxiv.org/abs/2608.16157
GitHub: https://github.com/FlashML-org/FreeToken
Project / Download: https://flashml.ai
Authors: Shuo Yang, Xiaoze Fan, Melissa Pan, Haocheng Xi, Zhe Wang, Shanlin Sun, Kurt Keutzer, Song Han, Matei Zaharia, Chenfeng Xu, Ion Stoica
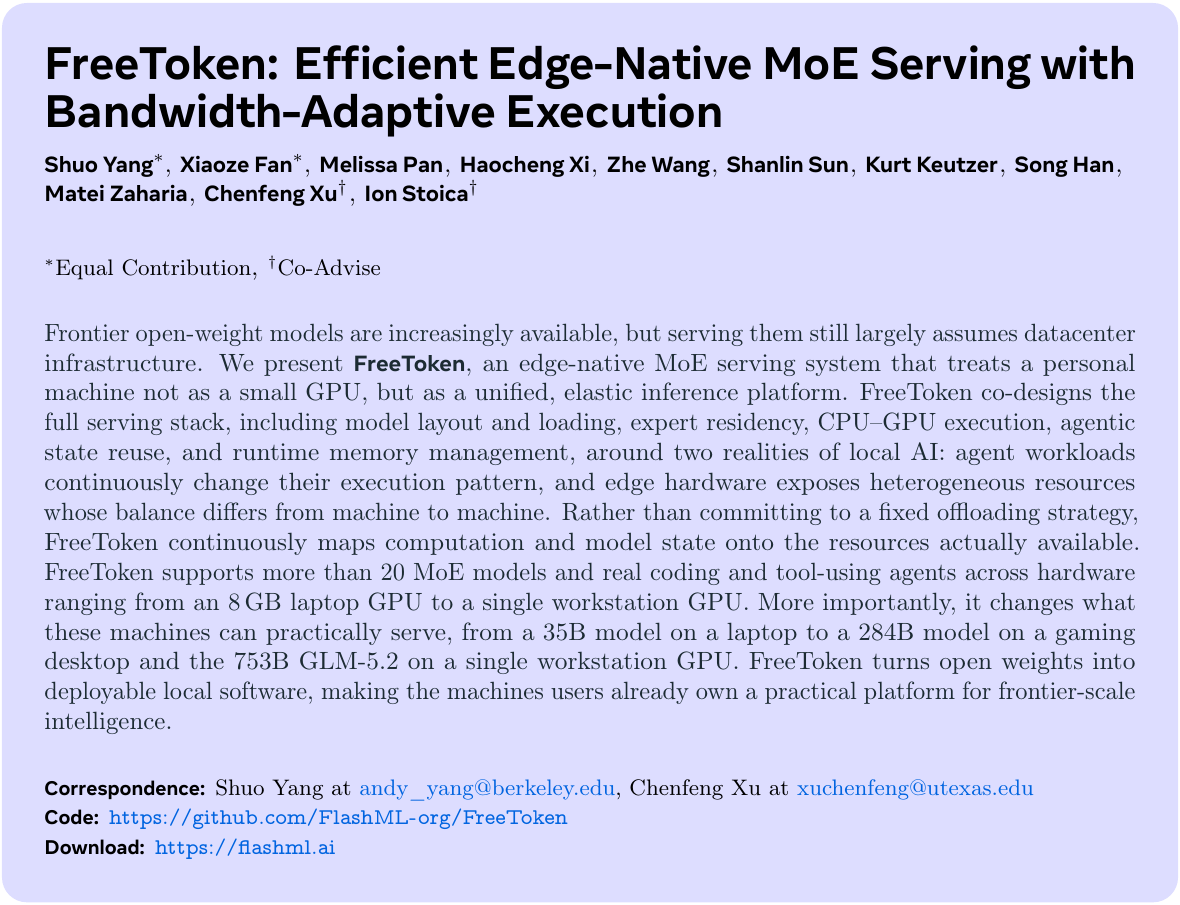
一句话总结: FreeToken 不把个人电脑看成“一块放不下模型的小 GPU”,而是把 GPU、CPU、主存、PCIe 和 SSD 组织成一个统一的弹性推理平台:Prefill 时整层双缓冲隐藏专家搬运,Decode 时根据机器实测带宽把缓存 miss 动态分给 GPU 加载和 CPU 原地计算,Agent 上下文被编辑时则从语义边界的状态检查点恢复。
版本说明: 本文严格对应 2026 年 8 月 17 日发布的 arXiv v1。论文是一篇刚发布的预印本,文中的模型、软硬件支持与性能数字应按该版本理解。
Abstract
MoE 模型有一个很诱人的性质:虽然总参数量可能达到数百 B,但每个 token 只激活少量专家,因此一次 token 计算真正用到的参数远少于完整模型。以论文中的 DeepSeek-V4-Flash 为例,它有 284B 总参数、13B 激活参数,每层只从 256 个 routed experts 中选择 6 个。13B 的活跃计算量对消费级 GPU 并非不可承受,真正困难的是:没有被当前 token 激活的专家仍然要被存放,而 284B 的完整权重远超消费级显存。
常见方案把完整专家池放进 CPU 内存,只在 GPU 中保留一部分专家。问题随即从“算力够不够”变成了三个系统问题:
- 长 prompt 的 Prefill 会在许多 token 之间覆盖几乎所有专家,单纯利用 token 级稀疏性无法避免整池搬运;
- Decode 中每次缓存 miss 都必须在“经 PCIe 搬到 GPU”和“留在 CPU 直接算”之间选择,最优比例因机器而异;
- Agent 会反复增加、截断或替换工具上下文,KV Cache、循环状态与专家缓存的显存需求都在变化。
FreeToken 因而不是一个孤立的专家缓存策略,而是一套贯穿完整 serving stack 的设计:
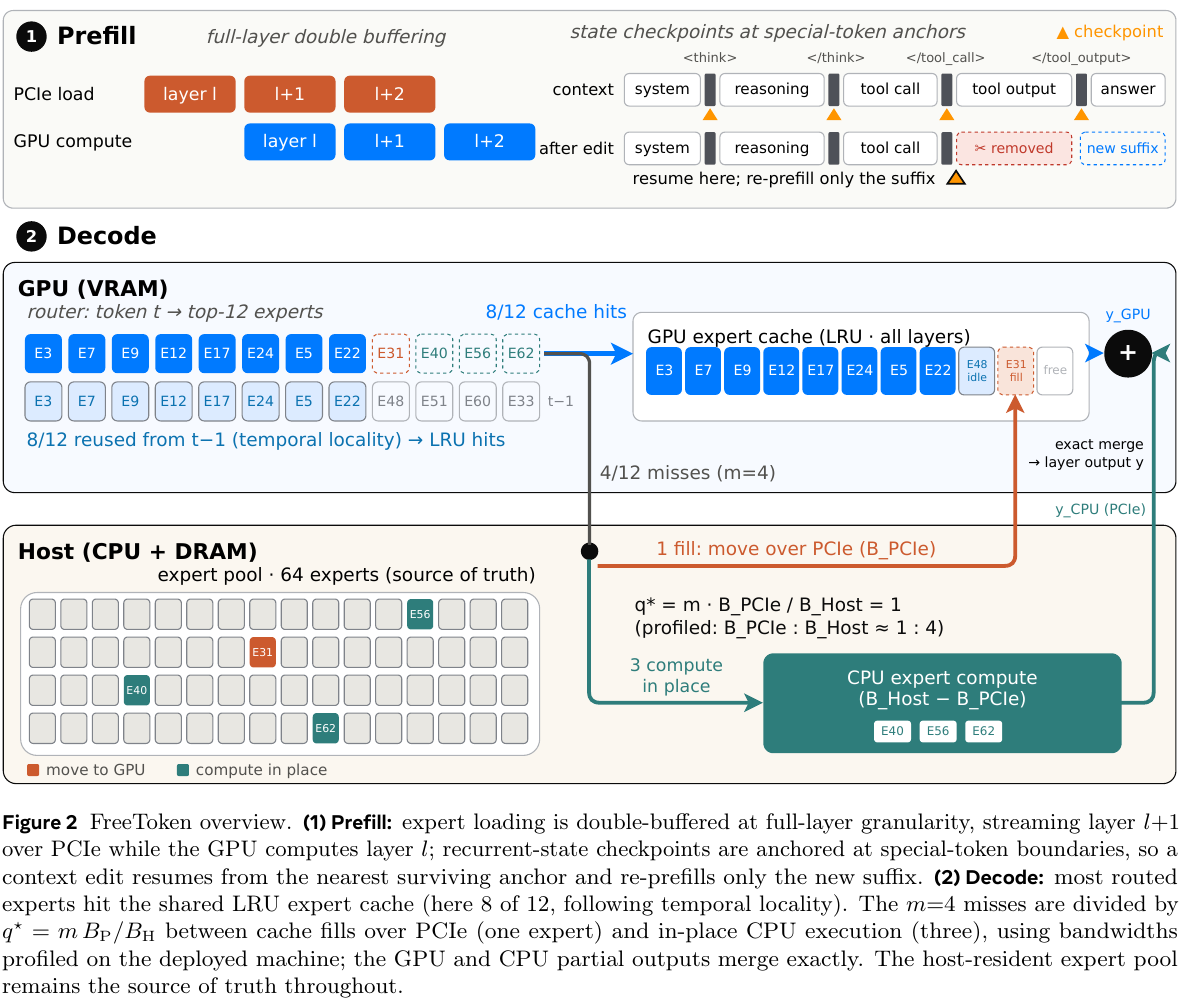
- Prefill: 用两个完整 MoE 层大小的缓冲区,一边在 GPU 上计算第 \(l\) 层,一边经 PCIe 预取第 \(l+1\) 层;
- 上下文复用: 标准注意力层继续使用 radix-tree KV Cache,混合线性注意力中的 recurrent state 则在 reasoning、tool call、tool output、conversation turn 等语义边界保存完整检查点;
- Decode: GPU 中用跨层共享的 LRU 专家缓存;发生 miss 后,根据 PCIe 带宽 \(B_P\) 和 CPU 专家处理带宽 \(B_H\) 计算 \(q^\star\),把一部分专家加载到 GPU,另一部分留在 CPU 原地计算,两路结果精确合并;
- 弹性显存: 在 KV Cache 与专家缓存之间动态重分配剩余显存,无需重新启动引擎或重新加载完整主存权重;
- 工程实现: 用固定形状的工作区、device-side valid count、CUDA Graph、持久化 CPU worker 和 FTW 权重布局,把动态路由保留在低开销执行路径中。
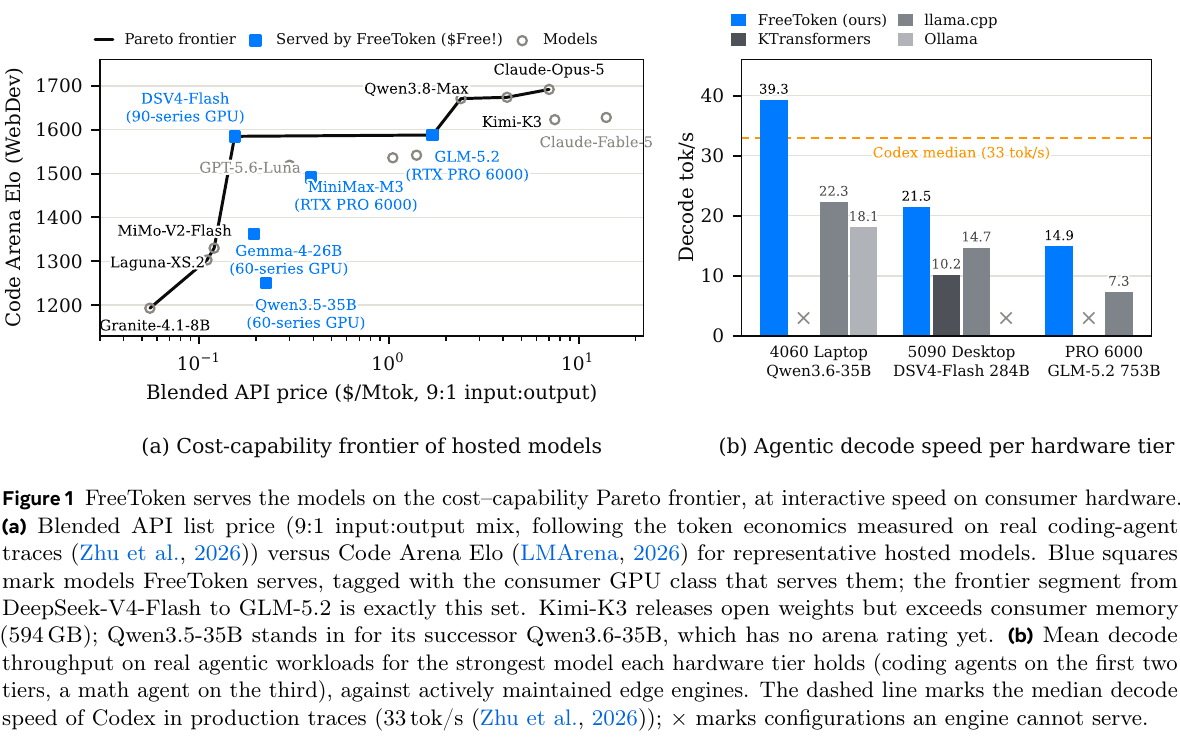
论文在从 8 GB RTX 4060 Laptop 到 96 GB RTX PRO 6000 的设备上测试了 Qwen3.6-35B-A3B、DeepSeek-V4-Flash 284B 和 GLM-5.2 753B。FreeToken 在 RTX 5090 上达到 77–83 tok/s 的 Qwen3.6 Decode 和 22–25 tok/s 的 DeepSeek-V4-Flash Decode;在 8 GB Laptop 上运行 35B MoE 达到 39.3 tok/s;在单张 RTX PRO 6000 上运行 753B GLM-5.2 达到 14.9 tok/s。
这些数字的重点不是“模型被塞进了显存”,而是完整专家池根本没有全部进显存:主存保存真值,显存保存热点,CPU 与 GPU 共同处理剩余 miss。
1. Background: 先理解 FreeToken 到底在解决什么
1.1 Dense LLM 与 MoE LLM 的区别
Dense Transformer 的每个 token 都会经过同一组 FFN 参数。假设第 \(l\) 层输入为 \(x_t^{(l)}\),可以简化写成:
$$ h_t^{(l)} {}={} \operatorname{FFN}^{(l)} \left(x_t^{(l)}\right). $$模型参数越多,每个 token 读取和计算的参数通常也越多。Mixture-of-Experts 则把一个 FFN 换成 \(E\) 个专家,并增加一个 router。Router 为当前 token 选择 top-\(k\) 个专家:
$$ \mathcal A_t^{(l)} {}={} \operatorname{TopK} \left( \operatorname{Router}^{(l)} \left(x_t^{(l)}\right),k \right), \qquad k\ll E. $$最终输出是这些专家输出的加权和:
$$ h_t^{(l)} {}={} \sum_{e\in\mathcal A_t^{(l)}} p_{t,e}^{(l)} \operatorname{Expert}_{l,e} \left(x_t^{(l)}\right). $$这里必须分清三个量:
- 总参数量: 模型包含的全部参数,决定完整权重需要多少存储;
- 激活参数量: 一个 token 实际经过的参数,决定单 token 的主要计算量;
- 工作集: 一段时间内不同 token 合起来访问过的专家,决定缓存和搬运压力。
MoE 只保证单个 token 的激活集合很小,不保证一整段 prompt 的专家并集也很小。这正是后续 Prefill 问题的根源。
1.2 一个具体例子:284B 为什么仍可能在 32 GB GPU 上计算
论文中的 DeepSeek-V4-Flash 有 43 个 MoE 层,每层 256 个 routed experts,每个 token 选择其中 6 个。于是:
- 当前 token 在某一层只需要 6 个专家;
- 其余 250 个专家此刻没有参与计算;
- 整个模型总参数为 284B,但单 token 的激活参数约为 13B。
13B 活跃参数经过低比特量化后,计算规模可以落入高端消费级 GPU 的能力范围;但完整专家池仍然很大,论文给出的 DeepSeek-V4-Flash FP4 专家权重约为 140 GB。所以典型执行路径变成:
SSD:启动前保存模型文件
  ↓
CPU DRAM:常驻完整 routed-expert pool,作为 source of truth
  ↓ PCIe
GPU VRAM:非专家参数 + KV Cache + 少量热点专家
  ↓
GPU Tensor Cores:执行大部分计算
这不是“把 284B 模型压缩成 13B 模型”。完整 284B 权重仍存在,只是当前 token 不需要同时把所有专家放进 GPU。
1.3 为什么带宽比 FLOPs 更关键
如果需要的专家已经在 VRAM,GPU 能以约 TB/s 级显存带宽读取权重;若专家只在主存,则有两条路:
- 把专家权重经 PCIe 搬到 VRAM,再由 GPU 计算;
- 权重不搬,CPU 直接读取主存中的专家并计算。
论文测试机器的 GPU 显存带宽约为 1–1.8 TB/s,但:
- PCIe 4.0 x16 的有效专家传输带宽约 25 GB/s;
- PCIe 5.0 x16 约 49–53 GB/s;
- 消费级 DDR4 主存约 50–60 GB/s;
- 较好的 DDR5 平台约 50–90 GB/s,工作站平台可以更高。
所以 cache hit 与 miss 的代价完全不同。一次 hit 直接走 GPU;一次 miss 若盲目搬运,会卡在 PCIe;若全部交给 CPU,又会卡在主存带宽和 CPU kernel。FreeToken 的核心思想不是强行选定一条路,而是让两条路并行,并让完成时间尽量相同。
1.4 Prefill 和 Decode 是两种完全不同的负载
自回归模型推理通常分为:
- Prefill: 一次读入完整 prompt,批量计算所有输入 token,并建立 KV Cache 或 recurrent state;
- Decode: 每次只生成一个或少量新 token,重复读取模型权重和历史状态。
Prefill 的 token 多、并行度高。即使每个 token 只选几个专家,几千个 token 的路由并集也可能覆盖几乎全部专家,因此专家工作集会从“稀疏”变成“近似稠密”。
Decode 的 token 少、并行度低,但相邻 token 的语义和隐藏状态连续,路由通常具有短期局部性。刚刚用过的专家很可能再次被访问,所以缓存才真正有价值。
这解释了为什么 FreeToken 为两阶段设计了完全不同的策略:
| 阶段 | 路由特征 | 主要问题 | FreeToken 策略 |
|---|---|---|---|
| Prefill | 大量 token 的专家并集接近完整层 | 大规模权重搬运、搬运与计算串行 | 整层双缓冲流水线 |
| Decode | 单 token 稀疏,相邻 token 有局部性 | cache miss 应该搬还是算 | LRU + 带宽自适应 CPU/GPU 拆分 |
| Agent 再 Prefill | 上下文被增删改,公共前缀很长 | KV 或 recurrent state 重算 | radix prefix + 语义锚点检查点 |
1.5 Agent 工作负载为何比普通聊天更难
一个 coding agent 的上下文可能这样增长:
system prompt
→ 用户 issue
→ reasoning
→ tool call: 搜索文件
→ tool output: 2000 行结果
→ reasoning
→ tool call: 运行测试
→ tool output: 日志
→ answer
为了控制长度,agent harness 可能删除旧工具输出、把它替换成占位符,或只保留最近几轮。表面上只是中间一段文本发生变化,系统却必须重新确认修改位置后的模型状态:
- 标准注意力层的 KV Cache 可以复用仍然相同的最长前缀;
- recurrent / linear-attention 层把整个前缀压进一个状态,不能从任意 token 中间切开;
- 新后缀仍需要 Prefill,期间又会访问大量专家。
因此 agent serving 同时放大了上下文状态复用、专家搬运和尾部 TTFT 问题。
2. Why Existing Edge MoE Serving Falls Short
2.1 Prefill 会破坏专家稀疏工作集
假设一层有 256 个专家,每个 token 选择 6 个。单看一个 token,激活比例只有:
$$ \frac{6}{256} \approx 2.34\%. $$但一个 8192-token prompt 会产生大量路由选择。不同 token 的选择取并集后,很容易覆盖大部分甚至全部专家。此时“只加载被路由专家”仍近似等于加载完整专家层,只是加载发生得更零碎、更难合并。
对约 140 GB 的 DeepSeek-V4-Flash FP4 专家池,单次 Prefill 理论传输时间大致是:
$$ T_{\mathrm{transfer}} \approx \frac{140\ \mathrm{GB}}{B_P}. $$于是:
- \(B_P\approx60\ \mathrm{GB/s}\) 时,至少约 2.3 s;
- \(B_P\approx25\ \mathrm{GB/s}\) 时,至少约 5.6 s;
- 只有约 12 GB/s 的 Laptop 链路时,至少约 11.7 s。
这还只是权重传输下界,没有包含 GPU 计算、调度与上下文状态处理。
2.2 静态专家放置跟不上 Decode 路由
一种简单方案是在 Prefill 结束后统计热门专家,固定把它们留在 GPU。问题是 Decode 期间 token 内容持续变化,下一步路由不一定延续整段 Prefill 的全局频率。
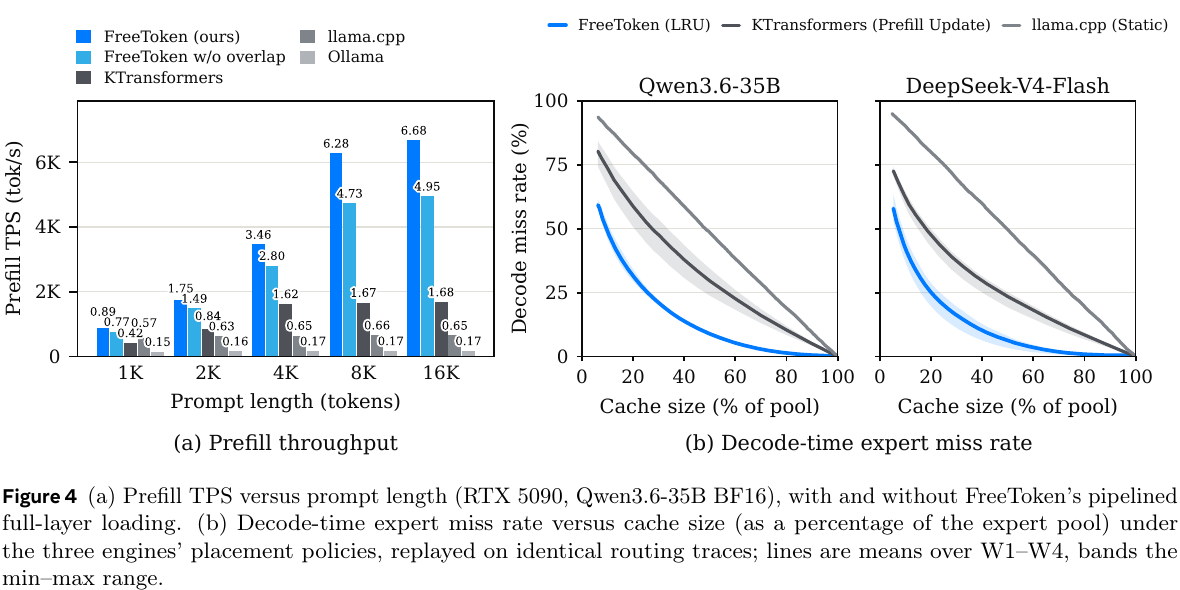
论文将三种策略放在相同 routing trace 上比较:
- llama.cpp 的静态划分不了解当前路由;
- KTransformers 根据 Prefill 更新放置,但 Decode 期间不持续逐 miss 适应;
- FreeToken 的全局 LRU 随每次真实访问更新。
结果说明,Decode 更需要短时间尺度的路由局部性,而不是一次性统计出的长期热门集合。
2.3 只搬到 GPU 或只在 CPU 算都不稳健
设 Decode 某层当前有 \(m\) 个 miss。
- 全搬 GPU:可能使 PCIe 满载,而 CPU 内存计算资源空闲;
- 全留 CPU:可能使 CPU/DRAM 满载,而 PCIe 与 GPU miss path 空闲;
- 固定各一半:当机器换成 PCIe 4.0 Laptop、PCIe 5.0 Desktop 或多通道 Workstation 时,不再匹配真实资源比例。
边缘机器的资源组合并不规则。比如论文测得:
- RTX 4060 Laptop:\(B_P=11.8\) GB/s,\(B_H=47.5\) GB/s;
- RTX 5090 Desktop:\(B_P=49.0\) GB/s,\(B_H=53.8\) GB/s;
- RTX PRO 6000 Workstation:\(B_P=51.5\) GB/s,\(B_H=178\) GB/s。
即使 GPU 更强,也不能由 GPU 型号单独决定 miss 服务策略;关键是整机的 PCIe 与主存/CPU 处理带宽比。
2.4 显存预算并不固定
本地 GPU 可能同时服务浏览器、桌面、游戏或其他 CUDA 程序。模型内部的显存需求也会变化:
- 对话越长,KV Cache 越大;
- 并发请求越多,KV pages 越多;
- KV Cache 增长后,可用于专家缓存的空间变少;
- 请求结束后,又可能释放空间给专家缓存。
预先永久切出固定比例会导致一边 OOM、另一边空置。FreeToken 因此把二者放进同一个可调整预算。
2.5 启动本身也会成为瓶颈
若 140 GB 专家池从约 7 GB/s 的 NVMe SSD 读入主存,光读取就约 20 s。若程序先分配并触碰一块巨大 pinned buffer,再复制或重排一次,启动会进一步变慢并占用额外峰值内存。
因此系统需要同时优化:
- 磁盘上的权重布局;
- 直接读到最终 host layout;
- 内存填充后的 pinning;
- 无 GPU warmup 的冷缓存启动。
3. FreeToken Overview
FreeToken 的模型状态层次可以概括为:
CPU DRAM
└─ 完整 routed-expert pool:唯一、完整的专家权重真值

GPU VRAM
├─ 非专家权重:常驻
├─ KV pages / recurrent working state
└─ 全局 expert cache:跨所有 MoE 层共享
   └─ 每个 slot = 一个完整的 (layer, expert) 对
这里的“全局共享”很重要。若每层固定预留相同数量的 slot,某些层不够用、另一些层空闲时不能互借。FreeToken 让所有层竞争同一专家缓存,因此缓存容量会流向当前真正活跃的 layer-expert 对。
可以把设计按“何时发生”拆开:
- 加载模型时: SSD 权重直接进入最终 CPU 专家池,非专家权重进 GPU;
- Prefill 时: 两个完整层缓冲交替工作,并在语义边界建立可复用状态;
- Decode 命中时: 驻留专家直接在 GPU 执行;
- Decode miss 时: 一部分专家经 PCIe 填入 GPU cache,其余在 CPU 原地执行;
- 显存压力变化时: 在 scheduler safe point 重建不同大小的专家 cache;
- 所有时刻: CPU 专家池都是 source of truth,GPU cache 只影响速度,不决定正确性。
FreeToken 的关键不是任何一个单项技术,而是让 Prefill、Decode、上下文恢复和内存管理使用同一套专家池与显存预算。
4. Prefill: 用整层双缓冲把传输藏到计算后面
4.1 为什么要在路由结果出来前加载整层
Prefill 有很多 token。等 router 给出所有 token 的 top-\(k\) 结果后再逐个加载专家,会产生大量细粒度、不规则传输。更重要的是,路由并集通常已经接近完整层,等待并不能省下多少权重。
FreeToken 反过来利用这个事实:既然大概率要覆盖整层,就直接在上一层计算期间加载下一整层,不必等待下一层 router。
4.2 双缓冲时间线
系统从全局专家 slot pool 中借出两个完整层大小的 buffer:
时间 →

PCIe stream:  [加载 layer l] [加载 layer l+1] [加载 layer l+2]
GPU compute:                  [计算 layer l]   [计算 layer l+1]
Buffer A:     layer l                         layer l+2
Buffer B:                    layer l+1
稳定阶段中:
- GPU 从 Buffer A 读取第 \(l\) 层专家并计算;
- 独立传输流同时把第 \(l+1\) 层专家读入 Buffer B;
- 第 \(l\) 层结束后两个 buffer 交换;
- 下一层计算与再下一层传输继续重叠。
单层稳态耗时近似为:
$$ T_{\mathrm{layer}} \approx \max \left( T_{\mathrm{compute}}, T_{\mathrm{PCIe}} \right), $$而不是串行时的:
$$ T_{\mathrm{serial}} \approx T_{\mathrm{compute}} {}+{} T_{\mathrm{PCIe}}. $$当 PCIe 更慢时,计算被藏在传输后面;当计算更慢时,传输被藏在计算后面。论文的 8192-token 实验中,一个 prefill chunk 需要 1.19–1.22 s,几乎等于把 64.4 GB 专家池以 52.7 GB/s 流过 PCIe 一次的时间,说明专家计算基本被隐藏。
4.3 为什么不用三缓冲或更大缓存
两块 buffer 已足够形成 producer-consumer 流水线:一个供 GPU 消费,一个供 PCIe 填充。更多完整层 buffer 会占用本可服务 Decode 热点专家或 KV Cache 的显存,却不会再降低稳态的两阶段临界路径。
两块 buffer 来自同一个全局 slot pool,Prefill 结束后仍留在其中的专家可以直接成为 Decode 初始缓存。系统没有建立另一套互不相通的 Prefill staging memory。
若剩余显存连两个完整层都放不下,FreeToken 不会强行超额分配,而是回退到按需加载。这保证可运行性,但无法获得完整双缓冲的吞吐收益。
4.4 这项优化解决不了什么
整层双缓冲并没有减少 Prefill 必须经过 PCIe 的总字节数。它做的是重叠而不是压缩:
- 若 PCIe 极慢,端到端速度仍受 PCIe 上限限制;
- 首层加载和末层收尾无法完全隐藏;
- 短 prompt 的专家并集可能没那么稠密,整层预取的收益相对较小;
- 若显存不足以容纳两层,系统只能使用 fallback。
因此论文报告的性能曲线是 prompt 越长越占优,而不是每个长度都获得相同倍数。
5. Semantic-Aware State Cache: Agent 编辑上下文后从哪里恢复
5.1 标准 Attention 的 prefix reuse
对标准 full-attention 层,如果新请求和旧请求共享前缀:
$$ X_{\mathrm{old}} {}={} [P,S_{\mathrm{old}}], \qquad X_{\mathrm{new}} {}={} [P,S_{\mathrm{new}}], $$那么 \(P\) 对应的 KV Cache 可以直接复用,只需 Prefill 新后缀 \(S_{\mathrm{new}}\)。SGLang 一类系统通常使用 radix tree 按 token 前缀组织缓存。
5.2 recurrent state 为什么不能任意切开
部分 hybrid-attention 模型还包含 linear attention 或其他 recurrent layer。它们把前缀不断压缩进一个递推状态:
$$ s_i {}={} f(s_{i-1},x_i). $$状态 \(s_i\) 是从 \(x_0\) 到 \(x_i\) 的聚合结果。若中间的 \(x_j\) 被删除或替换,旧的 \(s_i\) 已经混入了 \(x_j\),不能只“删掉对应的一小块”。必须找到编辑位置之前保存的完整状态,再从那里重新推进。
5.3 为什么检查点要放在语义边界
显存不可能为每个 token 保存一份完整 recurrent state。FreeToken 只保留少量检查点,并将预算花在 agent 框架最常修改的位置:
- reasoning segment 结束;
- tool call 开始或结束;
- tool output 结束;
- conversation turn 结束。
这些边界通常由特殊 token 标记,且 agent harness 往往整块删除、截断或替换工具结果。也就是说,编辑位置不是均匀随机的,语义边界比“每隔固定 1024 token”更可能存活。
5.4 一个上下文编辑例子
旧上下文为:
[system]
[reasoning A]
[tool call: rg]
[tool output: 5000 tokens]
[reasoning B]
为了节省窗口,框架把旧 tool output 替换成短占位符:
[system]
[reasoning A]
[tool call: rg]
[tool output removed]
[new suffix]
如果在 tool call 结束处保存过 recurrent-state checkpoint,那么:
- full-attention 层从 radix tree 复用相同前缀的 KV Cache;
- recurrent 层恢复 tool call 后的完整状态;
- 只为新的占位符和 new suffix 再 Prefill;
- 无需从 system prompt 重新运行整个上下文。
若恰好没有可用检查点,就恢复更早的存活检查点;最坏情况仍需从头 Prefill,因此检查点提升的是常见编辑模式下的性能,不改变正确性。
5.5 检查点如何淘汰
这些 recurrent-state checkpoints 附着在 prefix-tree 节点上,但有独立的 LRU 预算。原因是 KV page 与完整 recurrent state 的大小、复用粒度和价值不同,不能只用同一个页面淘汰规则粗暴管理。
“Semantic-aware”并不意味着系统用 LLM 理解文本语义。它利用的是 agent protocol 已经显式提供的 special-token boundaries。
6. Decode: 先命中缓存,再给 miss 选择执行位置
6.1 全局 LRU 专家缓存
Router 仍在 GPU 上执行。对当前 Decode step,把被路由专家分成:
- \(\mathcal H\):已经驻留在 GPU cache 的 hit experts;
- \(\mathcal M\):不在 GPU cache 的 unique missing experts;
- \(m=|\mathcal M|\):去重后的 miss 数量。
去重很重要。同一个 batch 的不同 token 可能命中同一个 layer-expert 对,系统只需要加载或执行该专家一次对应的 grouped workload,而不是重复搬运同一份权重。
GPU cache 使用跨所有 MoE 层的 LRU。相邻 Decode token 的路由通常不会完全跳变,因此最近访问专家有较高概率再次命中。LRU 不需要预测下一个 token 的专家,只根据已经发生的访问维护短期工作集。
6.2 每个 miss 有两条精确执行路径
FreeToken 把 \(\mathcal M\) 拆成互不重叠的两部分:
$$ \mathcal M {}={} \mathcal F \mathbin{\dot\cup} \mathcal C. $$其中:
- \(\mathcal F\):fill set,专家经 PCIe 搬入 GPU cache,再由 GPU 执行;执行后继续驻留;
- \(\mathcal C\):CPU set,专家保持在 CPU DRAM,由 CPU kernel 原地执行,不改变 cache residency;
- \(q=|\mathcal F|\),所以 \(|\mathcal C|=m-q\)。
这不是用 CPU 近似 GPU 专家,也不是跳过低分专家。Router 选择的专家和门控权重保持不变,只是把相同专家算子放到不同设备执行。GPU 与 CPU 产生的 partial output 最后按原门控权重合并。
6.3 两个实测带宽
系统在部署机器上测量:
- \(B_P\):pinned host memory 到 GPU 的有效专家传输带宽;
- \(B_H\):CPU 侧 MoE expert kernel 的有效专家处理带宽。
这里的 \(B_H\) 不是 DRAM 厂商标称带宽,也不是 CPU 峰值 FLOPs,而是包含实际量化格式、读取模式和 kernel 的端到端有效吞吐。用实测值的原因是本地机器的 NUMA、内存通道数、PCIe 代际与 CPU 指令集差异很大。
6.4 为什么 CPU 可用带宽是 \(B_H-B_P\)
PCIe DMA 从主存读取待搬运专家时,也会占用主存子系统。若 PCIe 路径正以 \(B_P\) 读取专家,CPU 分支不能仍假设拥有完整 \(B_H\)。论文使用简单的残余带宽模型:
$$ B_R {}={} \max(B_H-B_P,0). $$设一个完整 layer-expert 对大小为 \(S\)。两条并发路径的近似耗时是:
$$ T_{\mathrm{fill}}(q) \approx \frac{qS}{B_P}, $$$$ T_{\mathrm{cpu}}(m-q) \approx \frac{(m-q)S}{B_H-B_P}. $$两条路径并行,所以暴露在关键路径上的 miss 时间近似为:
$$ T_{\mathrm{miss}} \approx \max \left( T_{\mathrm{fill}}(q), T_{\mathrm{cpu}}(m-q) \right). $$若把所有工作压给一边,另一边先完成后会空等。最好的 \(q\) 应使两边时间接近。
6.5 \(q^\star\) 的推导
令两条路径耗时相等:
$$ \frac{qS}{B_P} {}={} \frac{(m-q)S}{B_H-B_P}. $$约去 \(S\) 并整理:
$$ q(B_H-B_P) {}={} (m-q)B_P, $$$$ qB_H {}={} mB_P. $$因此:
$$ \boxed{ q^\star \approx m\frac{B_P}{B_H} } $$系统将结果取为可执行的整数,并至少选择一个 fill,使 GPU cache 能持续升温。若 \(B_H\le B_P\),残余 CPU 带宽近似为零,策略自然趋向把全部 miss 送入 GPU。
6.6 论文图中的数值例子
Figure 2 中:
- 当前有 \(m=4\) 个 unique misses;
- 实测比例 \(B_P:B_H\approx1:4\)。
于是:
$$ q^\star \approx 4\times\frac{1}{4} {}={} 1. $$系统把 1 个 miss 搬入 GPU cache,把其余 3 个交给 CPU。搬入 GPU 的专家执行后会留下,未来 token 可能命中;CPU 执行的三个专家只服务当前 step,不污染有限 cache。
再看两种真实硬件:
- RTX 4060 Laptop: \(B_P/B_H=11.8/47.5\approx0.25\)。若有 8 个 miss,\(q^\star\approx2\),大约 2 个 fill、6 个 CPU 原地算;
- RTX 5090 Desktop: \(B_P/B_H=49.0/53.8\approx0.91\)。若有 8 个 miss,\(q^\star\approx7\),多数 miss 适合经 PCIe 送 GPU。
同一份模型、同样的 8 个 miss,在不同机器上会得到完全不同的拆分。这就是 bandwidth-adaptive 的具体含义。
6.7 系统如何选择哪 \(q\) 个专家进入缓存
\(q^\star\) 只决定数量,不负责预测专家。系统仍按缓存替换逻辑选择 fill set:
- 对路由专家去重并查询 residency;
- 从全局 LRU 中选择至多 \(q\) 个 victim slots;
- 将选中的 missing experts 批量搬入这些 slots;
- 未选中的 misses 进入 CPU task descriptors;
- hits 与刚填入的 experts 合成 GPU grouped execution 集合。
因此 FreeToken 的创新点不是“更准地猜下一个专家”,而是:缓存已经 miss 以后,如何不让 PCIe 成为唯一出路。
6.8 CPU 与 GPU 并发执行的顺序
运行时先尽快启动 CPU 分支,因为它需要经过 descriptor 提交、CPU worker 调度和主存读取。与此同时 GPU 进行:
- cache metadata 更新;
- 一次融合的 expert batch copy;
- hit experts 与 fill experts 的 grouped GPU execution。
CPU 完成后把 partial output 写回 pinned buffer,再与 GPU 输出精确合并为当前 MoE layer 输出。两路并行使关键路径接近两者最大值,而 \(q^\star\) 尽量把这个最大值压低。
6.9 “精确”应该怎样理解
FreeToken 不改变:
- Router 选出的 expert IDs;
- top-\(k\) 数量;
- 门控权重;
- 专家本身的部署权重;
- 最终需要相加的专家输出集合。
所以它没有采用 expert dropping、专家替身或低分专家跳过等算法近似。论文还说明 DeepSeek-V4-Flash 的原生 MXFP4 expert blocks 被各引擎 bit-exact 地消费。
但“精确路由与完整专家计算”不应被扩大解释成不同设备、不同 kernel 的浮点归约顺序必然逐 bit 相同。更稳妥的表述是:在模型部署精度下,FreeToken 没有引入额外的模型级近似。
7. Elastic Memory: KV Cache 与专家缓存共享剩余显存
7.1 显存布局
FreeToken 先放入必须常驻的非专家参数,再把剩余显存分为:
$$ M_{\mathrm{free}} {}={} M_{\mathrm{KV}} {}+{} M_{\mathrm{expert\ cache}} {}+{} M_{\mathrm{workspace}}. $$随着上下文和并发变化,\(M_{\mathrm{KV}}\) 会增长或缩小,专家 slot 数量也要相应变化。系统只以完整 layer-expert 为 slot,不保存半个专家,简化了多 tensor bank 的一致映射。
7.2 为什么只能在 safe point 调整
正在运行的 CUDA Graph、GPU kernel 或 PCIe copy 可能持有旧 slot 地址。若在任意时刻移动缓存,会产生悬空映射或覆盖仍在使用的专家。因此 FreeToken 在 scheduler safe point:
- 等当前相关工作完成;
- 根据新显存预算确定 expert slots;
- 重建 GPU expert cache;
- 保留 CPU 完整专家池,不重新读盘;
- 后续 miss 用正常路径逐步恢复热点。
这属于运行时重新平衡,不是每个 token 都重分配内存,也不是完全无成本,但避免了重启引擎和重新加载数百 GB 权重。
7.3 快速冷启动
FreeToken 的 FTW 权重文件已经按运行时需要的 host layout 排列。加载时:
- 并行 direct I/O 直接写入最终 host banks;
- 不先建立一份临时布局再复制;
- 内存填充后才 pin,避免预先触碰巨大空 buffer;
- 不做完整 GPU cache warmup。
第一条请求从冷 cache 开始,miss 会沿正常 CPU/GPU 路径被服务,并逐步形成 LRU 热点集。这样把“必须等缓存预热完才能接请求”改为“第一条请求稍冷,但服务立即可用”。
8. Implementation Details: 动态路由如何留在 CUDA Graph 中
8.1 难点:CUDA Graph 喜欢固定,MoE 路由却是动态的
CUDA Graph 通过提前捕获 kernel launch、memcpy 和依赖关系来减少 CPU 提交开销,但每个 token 的:
- routed expert IDs;
- hit/miss 数量;
- victim slots;
- CPU/GPU 划分;
都在改变。若每步退出 Graph,在 Python 或 CPU 端重新组织大量小操作,Decode 的低并行计算会被调度开销淹没。
8.2 把控制流表示成数据
FreeToken 保留固定形状的 buffers 和 graph nodes,把动态信息写成 device-side data:
- 固定上限大小的 expert ID / slot / task arrays;
- device-resident valid counts;
- 未使用条目用 mask 屏蔽;
- copy 和 grouped kernel 保持固定 graph 结构。
一个 GPU kernel 完成:
- 去重 routed experts;
- 查询 cache residency;
- 根据 \(m,B_P,B_H\) 得到 \(q\);
- 从 LRU 候选中选择 victims;
- 把逻辑 expert ID 改写为物理 GPU slot 或 CPU flag。
论文采用单遍方式选出 \(K\) 个 LRU victim candidates,再使用前 \(q\le K\) 个,避免根据每步路由建立变长控制图。
8.3 CPU 分支也被纳入捕获路径
系统为不同 Decode batch size 预先准备稳定的:
- pinned input/output buffers;
- task descriptors;
- host function submission nodes;
- result copy 与同步节点。
CPU 端使用持久化 C++ worker pool,并把 worker 固定到物理核心,减少线程迁移和重复创建。CPU expert kernel 使用 SIMD,并在 kernel 内完成 dequantization,避免先把完整低比特专家解量化成更大的临时权重。
8.4 FTW 权重布局
每层有 \(E\) 个专家时,逻辑 ID 被展平为:
$$ \operatorname{id}(l,e) {}={} lE+e. $$一个专家可能由多个 tensor banks 组成。FTW 让不同 bank 中相同逻辑 ID 的行共同构成一个完整 expert slot。这样:
- cache metadata 只维护一个逻辑映射;
- 一次 fill 可以一致更新所有 expert banks;
- 磁盘读取直接进入运行时目标位置;
- 避免加载后的大规模转置与重排。
8.5 不能 pin 完整专家池时的 fallback
某些平台无法为完整主存专家池提供可 DMA 的 pinned / registered memory。FreeToken 此时回退到 pure-CPU MoE backend:
- 非专家层仍在 GPU;
- routed expert 全部在 CPU 原地执行;
- CPU 与 GPU 之间只传 activation、routing metadata 和聚合输出;
- 不再搬运大块专家权重。
这保证更多设备可以运行,但性能不再享受 GPU expert cache 和 PCIe fill 的协同。
9. Evaluation Setup
9.1 测试硬件
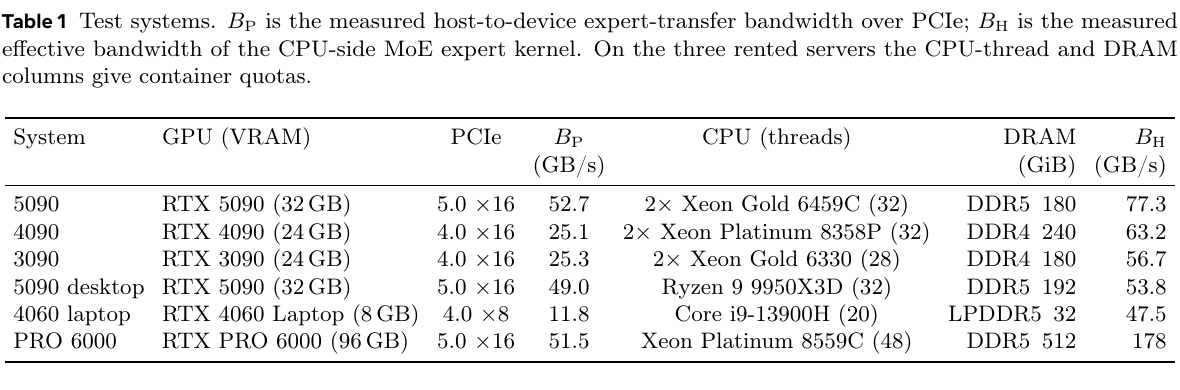
论文覆盖六套资源比例明显不同的机器:
| 系统 | GPU / VRAM | PCIe | \(B_P\) | CPU / 内存 | \(B_H\) |
|---|---|---|---|---|---|
| 5090 Server | RTX 5090 / 32 GB | 5.0 x16 | 52.7 GB/s | 双 Xeon,DDR5 180 GiB | 77.3 GB/s |
| 4090 Server | RTX 4090 / 24 GB | 4.0 x16 | 25.1 GB/s | 双 Xeon,DDR4 240 GiB | 63.2 GB/s |
| 3090 Server | RTX 3090 / 24 GB | 4.0 x16 | 25.3 GB/s | 双 Xeon,DDR4 180 GiB | 56.7 GB/s |
| 5090 Desktop | RTX 5090 / 32 GB | 5.0 x16 | 49.0 GB/s | Ryzen 9950X3D,DDR5 192 GiB | 53.8 GB/s |
| 4060 Laptop | RTX 4060 / 8 GB | 4.0 x8 | 11.8 GB/s | i9-13900H,LPDDR5 32 GiB | 47.5 GB/s |
| PRO 6000 | RTX PRO 6000 / 96 GB | 5.0 x16 | 51.5 GB/s | Xeon 8559C,DDR5 512 GiB | 178 GB/s |
前三套租用服务器对 CPU 线程与 NUMA 资源做了限制,用来模拟边缘机器的 host bandwidth;Qwen 测试使用 6 个 CPU threads,DeepSeek-V4-Flash 使用 8 个。它们不是物理意义上的普通个人台式机,这一点在解释“edge-native”时需要保留。
9.2 模型
- Qwen3.6-35B-A3B: 35B 总参数、约 3B active;除 4060 Laptop 使用官方 NVFP4 外,其余主要结果为 BF16;
- DeepSeek-V4-Flash: 284B 总参数、13B active;原生 MXFP4 routed experts;
- GLM-5.2: 753B 总参数、40B active;NVFP4 routed experts,checkpoint 约 433 GB,在 RTX PRO 6000 上测试。
Laptop 列和其他 Qwen 列不是同精度,因此 39.3 tok/s 不能简单当作 BF16 下 4060 与 4090 的纯硬件等价比较。
9.3 四类工作负载
| 编号 | 场景 | 主要特征 |
|---|---|---|
| W1 | AIME 数学推理 | 单轮、长 Chain-of-Thought、无工具,Decode dominated |
| W2 | OpenCode + SWE-bench | 真实工具执行,3 个脚本化用户轮次,必须产生 gold patch |
| W3 | Claude Code native protocol | 同一 SWE issue,可创建并发 subagents,session 增长至 56–65k tokens |
| W4 | OpenClaw 邮件/日历 Agent | 13 个固定用户轮次,约 24.5k system context floor,必须完成全部轮次 |
这套设计的价值在于没有只测“给一个 prompt 连续吐 token”。W2–W4 会增长上下文、调用工具、重新 Prefill,更能暴露缓存更新和 tail TTFT 问题。
9.4 Baselines 与指标
对比对象为:
- llama.cpp;
- Ollama;
- KTransformers;
- MoE-Infinity,在模型与 workload 受支持时运行。
权重格式尽可能严格对齐;论文特别说明 DeepSeek-V4-Flash 的原生 MXFP4 experts 被各引擎 bit-exact 使用。
主要指标:
- Decode throughput: 每请求平均生成速度,tok/s,越高越好;
- TTFT: 每请求平均 time to first token,越低越好。
论文没有比较完整 agent trajectory 的跨引擎 wall-clock time,因为不同引擎可能导致模型产生不同工具调用、上下文长度和步骤数。这个选择使单项 serving 指标更可比,但也意味着实验没有直接证明“整个 coding task 总耗时一定按同样倍数下降”。
10. Main Results
10.1 端到端 Decode 与 TTFT
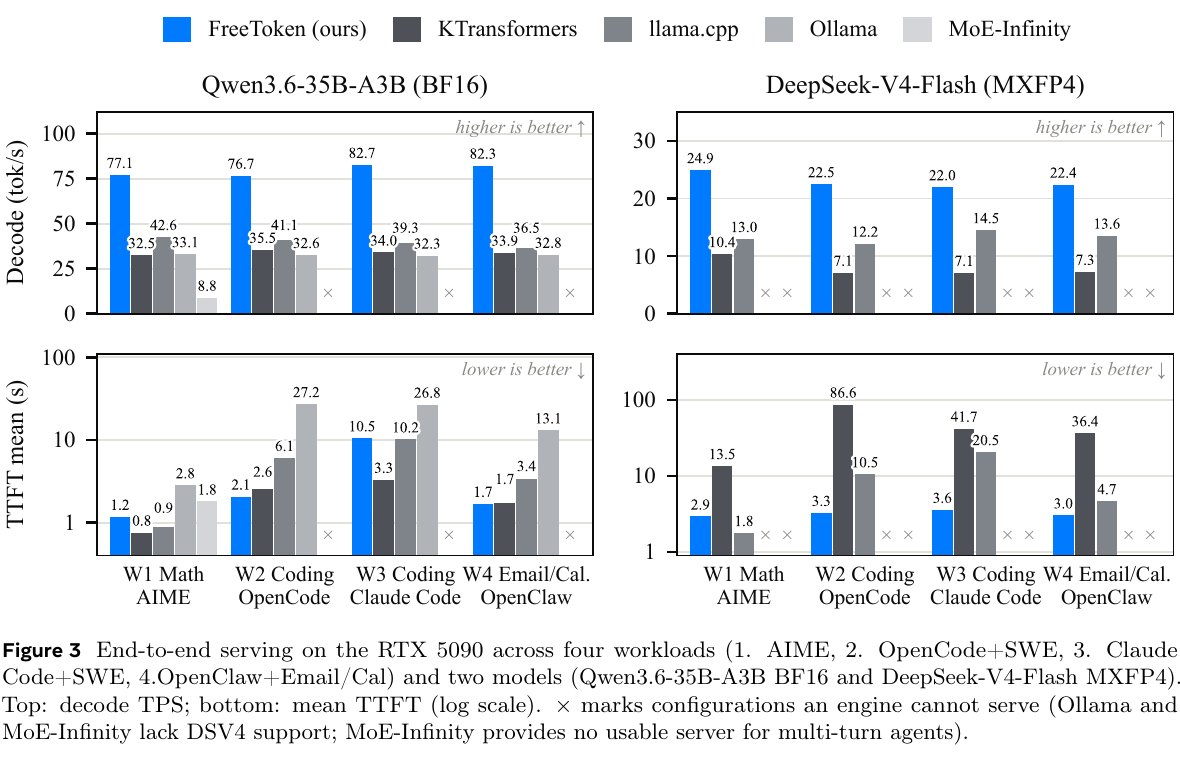
在 RTX 5090 Server 上:
- Qwen3.6 的 FreeToken Decode 为 77.1、76.7、82.7、82.3 tok/s;
- DeepSeek-V4-Flash 为 24.9、22.5、22.0、22.4 tok/s;
- 相对最强 baseline,Qwen3.6 提升约 1.8–2.3 倍,DeepSeek-V4-Flash 提升约 1.5–1.9 倍;
- 从 W1 单轮推理切换到三个 Agent workload 后,FreeToken 仍保持在 W1 速度的 12% 以内;
- KTransformers 在 DeepSeek-V4-Flash 的 W2 上相对 W1 Decode 速度下降约 31%,说明 prefill-time placement 对不断变化的 Agent 路由更敏感。
Figure 3 中几个具体对比:
| Model / Workload | FreeToken | KTransformers | llama.cpp | Ollama |
|---|---|---|---|---|
| Qwen W1 | 77.1 | 32.5 | 42.6 | 33.1 |
| Qwen W2 | 76.7 | 35.5 | 41.1 | 32.6 |
| Qwen W3 | 82.7 | 34.0 | 39.3 | 32.3 |
| Qwen W4 | 82.3 | 33.9 | 36.5 | 32.8 |
| DSV4 W1 | 24.9 | 10.4 | 13.0 | 不支持 |
| DSV4 W2 | 22.5 | 7.1 | 12.2 | 不支持 |
| DSV4 W3 | 22.0 | 7.1 | 14.5 | 不支持 |
| DSV4 W4 | 22.4 | 7.3 | 13.6 | 不支持 |
单位均为 tok/s。MoE-Infinity 只在 W1 提供可用服务,Qwen3.6 为 8.8 tok/s;更长 prompt 会触及其 per-expert prefill staging 限制,多轮 Agent server 也不保留可用 KV Cache。
10.2 TTFT 的平均值与尾部
FreeToken 在 6 个多轮测试 cell 中有 5 个取得最低平均 TTFT。例外是 Qwen3.6 × W3,KTransformers 的 GPU prefill 路径更有优势;短而独立的 W1 prompt 则对 llama.cpp 更友好。
真正影响 agent 可用性的往往是尾部:
- FreeToken 所有 cell 的 worst turn 都小于 44 s;
- llama.cpp 某处达到 232 s;
- Ollama 某处达到 179 s;
- KTransformers 某处达到 946 s。
OpenClaw 默认约有 120 s idle watchdog,Claude Code 的请求 timeout 约为 10 分钟。一次极慢的 re-prefill 不是“用户多等一会儿”,而可能让 agent 直接放弃整次请求。因此论文把 tail TTFT 解释为 availability boundary,而不仅是平均 latency statistic。
11. Breakdown: 性能到底来自哪里
11.1 Pipelined Prefill
在 RTX 5090、Qwen3.6-35B BF16 上,FreeToken 的 Prefill throughput 随 prompt 变长显著提高:
| Prompt | FreeToken | 去掉 overlap | KTransformers | llama.cpp | Ollama |
|---|---|---|---|---|---|
| 1K | 0.89K | 0.70K | 0.47K | 0.57K | 0.15K |
| 2K | 1.75K | 1.49K | 0.84K | 0.63K | 0.16K |
| 4K | 3.46K | 2.80K | 1.62K | 0.65K | 0.17K |
| 8K | 6.28K | 4.73K | 1.67K | 0.66K | 0.17K |
| 16K | 6.68K | 4.95K | 1.68K | 0.65K | 0.17K |
单位是 Ktok/s。关闭第二个 full-layer buffer:
- 4K prompt 损失 19%;
- 8K 损失 25%;
- 16K 损失 26%。
prompt 越长,专家并集越接近完整池,计算/传输流水线越容易进入稳定阶段,因此双缓冲收益更明显。16K 时 6.68K tok/s 也表明瓶颈已接近一次流过完整专家池的 PCIe ceiling。
11.2 Expert Cache Locality
在 RTX 5090 的可用 cache capacity 下:
- Qwen3.6 cache 可容纳专家池约 37%;
- FreeToken LRU miss rate 为 16%;
- KTransformers 的 Prefill placement 为 41%;
- llama.cpp static placement 为 62%。
DeepSeek-V4-Flash 更极端:
- cache 只容纳完整专家池约 11%;
- FreeToken miss rate 为 39%;
- KTransformers 为 59%;
- llama.cpp 为 89%。
这说明收益并不是“32 GB 足以缓存大多数专家”。对 DSV4,GPU 只装下约一成专家,LRU 仍因短期路由局部性显著降低 miss;剩余 miss 再由 CPU/GPU 分流,而不是全部经 PCIe。
11.3 不要把 miss rate 当成唯一指标
miss rate 更低不自动等于总延迟更低。一个 miss 还涉及:
- expert 大小;
- PCIe 传输;
- cache victim 与 metadata;
- CPU kernel;
- 两分支能否重叠;
- 当前 KV / expert cache 的空间分配。
FreeToken 的优势来自 LRU 降低 miss 数量与 \(q^\star\) 降低剩余 miss 代价的组合。只有其中一个环节都无法完整解释端到端结果。
12. Cross-Hardware Results: 同一策略如何适应不同资源比例
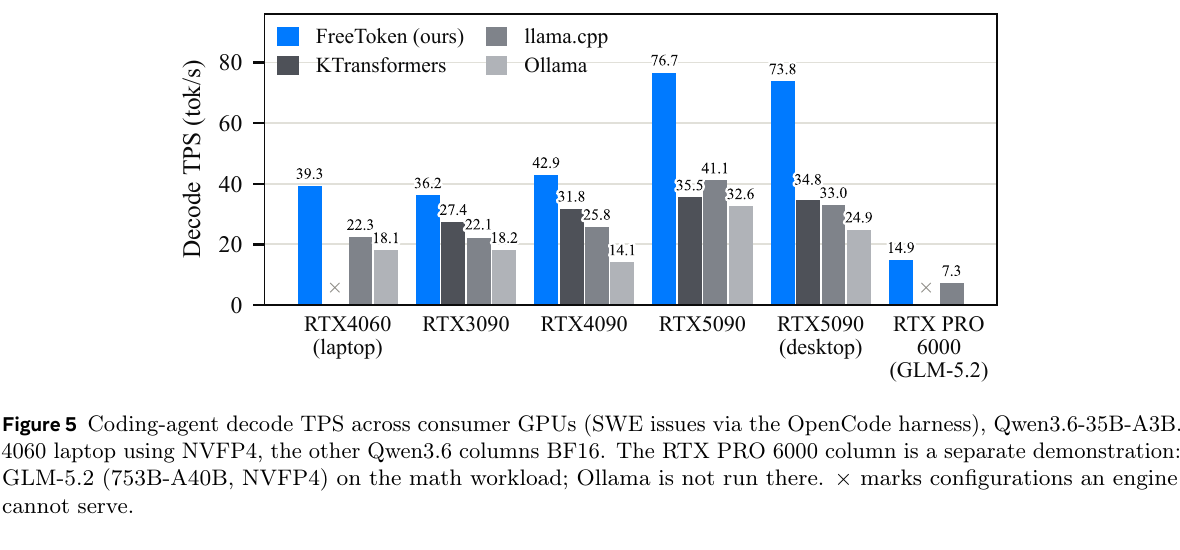
W2 coding-agent workload 的 Qwen3.6 结果为:
| Hardware | FreeToken | 最强 baseline | FreeToken 优势 |
|---|---|---|---|
| RTX 4060 Laptop | 39.3 | llama.cpp 22.3 | 约 1.8 倍 |
| RTX 3090 | 36.2 | KTransformers 27.4 | 约 1.3 倍 |
| RTX 4090 | 42.9 | KTransformers 31.8 | 约 1.3 倍 |
| RTX 5090 Server | 76.7 | llama.cpp 41.1 | 约 1.9 倍 |
| RTX 5090 Desktop | 73.8 | KTransformers 34.8 | 约 2.1 倍 |
RTX 4060 Laptop 只有 8 GB VRAM,却以 NVFP4 运行 35B MoE 并达到 39.3 tok/s,约为论文中 RTX 4090 FreeToken 数值的 92%。这并不说明 4060 算力接近 4090,而是说明每 token 计算只激活少量专家、低比特格式减小工作量,同时 Laptop 较低的 \(B_P/B_H\) 让更多 miss 走 CPU 分支。
同为 RTX 5090:
- Server 为 76.7 tok/s;
- Consumer Desktop 为 73.8 tok/s;
- FreeToken 只下降约 4%。
Desktop 的 \(B_H\) 从 Server 的 77.3 GB/s 降到 53.8 GB/s,但 \(B_P\) 仍有 49.0 GB/s。FreeToken 自动增大 fill 比例,使 PCIe/GPU 路径承担更多 miss,因此较少受双通道主存限制。llama.cpp 在同一变化中只保留约 80% 的吞吐。
12.1 753B 模型的单工作站演示
在 96 GB RTX PRO 6000、512 GiB DDR5 工作站上:
- FreeToken 运行 GLM-5.2 753B 达到 14.9 tok/s;
- llama.cpp 为 7.3 tok/s;
- 平均 TTFT 分别约为 7.5 s 与 7.8 s;
- KTransformers 在该机器上没有可服务路径。
论文解释 KTransformers 的 GLM-5.2 路径需要约 753 GB–1.5 TB host-resident experts,超过 512 GiB 主存,且没有读取 GLM-5.2 NVFP4 layout 的 CPU kernel。
这里的“单 GPU 运行 753B”不等于模型只占 96 GB:checkpoint 约 433 GB,完整专家池主要依赖 512 GiB 主存,GPU 只保存非专家部分、状态和热点专家。这是单机层次化内存 serving,不是单卡显存容纳完整模型。
13. How to Read the Paper’s Claims Correctly
13.1 FreeToken 没有消除 PCIe 瓶颈
Prefill 仍要把近似完整专家池流过 PCIe,只是通过双缓冲把计算重叠进去。Decode miss 也仍会受 PCIe 与主存带宽约束,只是系统不再把每个 miss 都强制放到同一条通路。
更准确的结论是:
FreeToken 将“PCIe 是唯一的串行 miss 路径”改成“PCIe/GPU 与 CPU/DRAM 两条可并行、按带宽平衡的路径”。
13.2 它不是专家预测器
\(q^\star\) 不预测哪些专家会被 Router 选择。执行顺序是:
Router 已经产生真实 expert IDs
→ 查 GPU cache
→ 确定真实 misses
→ q* 决定多少 miss 走 fill、多少走 CPU
所以即使未来专家完全不可预测,FreeToken 仍能优化已有 miss 的服务;缓存命中收益则来自真实路由的时间局部性。
13.3 它也不是把 CPU 当作单纯仓库
传统 offloading 中,CPU DRAM 只保存字节,miss 时必须把字节送入 GPU。FreeToken 允许权重在所在位置直接执行,使 host memory 从被动容量资源变成计算资源。
不过 CPU 分支并非免费:它依赖高效低比特 kernel、SIMD、线程绑定与足够主存带宽。若 CPU kernel 很弱或内存系统与 PCIe 严重争用,\(B_H\) 会降低,策略就会自动减少 CPU 工作。
13.4 “Edge-native”不等于廉价低资源
论文覆盖 8 GB Laptop,但大型演示仍需要:
- DSV4 的约 140 GB 专家池和相应主存;
- GLM-5.2 的约 433 GB checkpoint;
- PRO 6000 测试机的 512 GiB DRAM。
因此 FreeToken 扩大了个人机器可运行模型的边界,却没有消除总存储、主存容量、功耗与散热需求。能运行 753B 的“工作站”与普通 16 GB 内存笔记本不是同一资源等级。
14. Limitations and Open Questions
14.1 论文版本与实验覆盖
这是 2026-08-17 的 arXiv v1,尚应等待更广泛复现。论文覆盖 20 多个可支持模型的系统,但主要量化结果集中在三类模型和六套硬件;不同 NUMA 拓扑、AMD GPU、Apple Silicon、Windows 驱动路径或统一内存架构是否有同等收益,不能从当前结果直接推出。
14.2 \(q^\star\) 是简洁的一阶带宽模型
推导隐含若干近似:
- 专家大小可用统一 \(S\) 表示;
- 两条路径主要是 bandwidth-bound;
- PCIe 流量从 CPU 可用带宽中线性扣除;
- GPU miss expert compute 已被 transfer 或其他工作隐藏;
- \(B_P\) 与 \(B_H\) 在运行期间相对稳定。
实际机器可能出现 NUMA 远端访问、温控降频、其他程序抢占内存带宽、小 miss 数量下的固定调度成本等。实测 profiling 比理论峰值更可靠,但若运行环境长期变化,带宽参数仍可能需要重新校准。
14.3 LRU 不是所有 workload 的最优替换策略
实验表明 Agent 路由具有短期局部性,LRU 明显优于 static 与 prefill-time placement。但若 workload 在多个专家集合之间周期性跳转,或 batch 混合大量无关请求,LFU、reuse-distance、request-aware partition 等策略可能更合适。FreeToken 选择 LRU 的优势是简单、在线、低控制开销。
14.4 评价指标没有覆盖所有用户成本
论文重点测量 Decode TPS 和 TTFT,没有系统报告:
- 整机功耗和每 token 能耗;
- SSD 与 DRAM 容量成本;
- 完整 agent task 的总 wall-clock;
- 模型任务质量与不同量化格式的统一精度比较;
- 高并发、多租户下的公平性和抖动。
尤其 Laptop 使用 NVFP4、其他 Qwen 列主要为 BF16,不能只看 TPS 就判断端到端精度—速度最优。
14.5 状态检查点依赖 agent protocol
语义边界检查点在工具调用和对话轮次清晰的 Agent 中很自然。如果应用是没有 special-token anchors 的连续文档流,或编辑发生在块内部,检查点命中率会降低。系统仍保持正确,只是重新 Prefill 的后缀变长。
14.6 Fast bootstrap 不是零启动成本
FTW 避免额外重排、复制和 GPU warmup,但数百 GB 权重仍必须从磁盘进入主存。7 GB/s NVMe 读取 140 GB 仍需约 20 s;433 GB checkpoint 更长。所谓 fast 是接近存储带宽下界,而不是瞬时加载。
15. From One Token to One Complete FreeToken Step
把所有机制串起来,Decode 一个 token 时发生:
- GPU 使用当前 hidden state 计算 router,得到每层 top-\(k\) 专家;
- device kernel 对专家 ID 去重并查全局 LRU;
- hits 直接映射到现有 GPU slots;
- 对 \(m\) 个 misses,根据实测 \(B_P,B_H\) 计算 \(q^\star\);
- 从 LRU 中选择 \(q\) 个 victim slots,并将对应 misses 批量填入;
- 剩余 \(m-q\) 个 misses 写入 CPU task descriptors;
- CPU worker 原地读取 host expert pool 并计算;
- GPU 同时执行 hits 与 fills;
- 两边 partial outputs 按原 router 权重合并;
- 更新 cache recency,进入下一层和下一个 token。
而一次新的 Agent 请求到来时:
- radix tree 找到标准注意力可复用的最长 token prefix;
- recurrent-state cache 找到编辑前最深的语义锚点;
- 只对新后缀执行 Prefill;
- Prefill 使用 full-layer double buffering;
- Prefill 留下的 layer-expert slots 直接成为后续 Decode 的初始 cache;
- 上下文增长导致 KV pages 增多时,在 scheduler safe point缩减专家 cache。
这两条流程共享同一个 CPU source-of-truth expert pool、GPU slot pool 和 serving scheduler,因此 FreeToken 才是一套完整系统,而不只是一个公式。
16. Key Takeaways
- MoE 的单 token 稀疏不等于长 prompt 工作集稀疏。 Prefill 与 Decode 必须分别设计。
- 个人电脑不只是小 GPU。 CPU、DRAM、PCIe、SSD 都能成为 serving 数据路径的一部分。
- Prefill 的主要方法是隐藏搬运。 两个完整层 buffer 让第 \(l+1\) 层传输与第 \(l\) 层计算重叠。
- Decode 的主要方法是分流 miss。 \(q^\star\approx mB_P/B_H\) 根据整机实测带宽决定 GPU fills 数量,剩余专家在 CPU 原地计算。
- 这不是专家预测或模型近似。 Router 结果不变,所有 routed experts 都被执行,CPU/GPU partial outputs 合并。
- Agent 场景需要状态级复用。 KV prefix tree 处理 full attention,语义边界 checkpoints 处理不可任意切分的 recurrent state。
- 显存必须弹性管理。 长上下文让 KV Cache 增长,专家 cache 需要在 safe point缩放,而 CPU 完整专家池保持不变。
- 最有说服力的结果是跨资源比例稳定。 8 GB Laptop 上 35B MoE 达 39.3 tok/s,单 Workstation 上 753B 达 14.9 tok/s;同一公式会因 \(B_P/B_H\) 不同自动选择不同 CPU/GPU 比例。
- 系统没有让大模型变小。 数百 GB 主存、磁盘容量、启动 I/O 与能耗仍真实存在。
- 当前结论来自 arXiv v1。 它清楚展示了系统设计方向,但仍需要更广硬件、能耗、并发和任务级指标的复现。
FreeToken 最值得记住的系统观点是:
当 MoE 的活跃计算已经能放进消费级 GPU 时,能否服务完整模型不再只由显存容量决定,而取决于系统能否把模型状态与计算实时映射到整台机器的异构资源上。