Long-Context Modeling with Dynamic Hierarchical Sparse Attention for Memory-Constrained LLM Inference
Conference: ICML'26 Spotlight
Paper: https://arxiv.org/abs/2510.24606
Github: https://github.com/xiongsiheng/DHSA
Abstract
Transformer Attention 的时间和显存开销随上下文长度平方增长,限制了长上下文 LLM 在有限显存设备上的部署。虽然长上下文 Attention 通常具有明显稀疏性,但显著 token 的位置会随任务和输入变化。Sliding Window、A-shape 和固定 Block-Sparse 等静态模式无法充分适应这种输入相关的稀疏分布;部分动态方法又依赖预定义模板或启发式规则。
论文提出 Dynamic Hierarchical Sparse Attention(DHSA)。DHSA 保持 LLM backbone 冻结,根据每层的 query/key 表征在线预测稀疏模式。方法首先使用轻量级边界预测器将序列划分为可变长 chunk,然后计算 chunk-level similarity,并将高分 chunk 展开为 token-level key index。稀疏注意力后端只对被选中的 token 执行精确 causal attention。
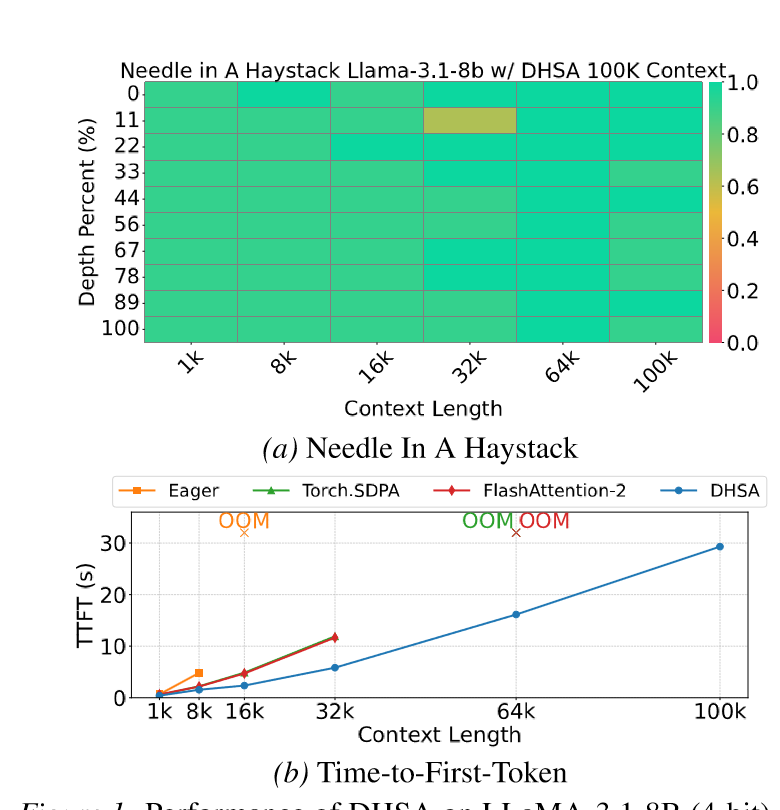
在 Needle-in-a-Haystack、LongBench 和 RULER 上,DHSA 在低 token density 下保持接近 Dense Attention 的准确率。在效率方面:
- 相同 prefill 成本下,相比 Block-Sparse 获得约 12%–20% relative accuracy gain;
- 128K context、6.25% token density 下,attention kernel 相对 FlashAttention-2 加速约 10.66×;
- LLaMA-3.1-8B 4-bit 在单张 RTX 3090 24GB 上可以处理 100K context,而 Dense Attention 无法在该显存限制下运行;
- LongBench 上平均 TTFT 从 Dense FA2 的 3.28 秒降低到 1.88 秒。
1. Introduction
长上下文能力使 LLM 能够处理长文档问答、代码仓库分析、历史记录总结和长时间 Agent 交互。然而,标准 Attention 需要计算所有 query-key pair:
$$ \mathrm{Attention}(Q,K,V) =\mathrm{softmax}\!\left( \frac{QK^{\top}}{\sqrt d}+M_{\mathrm{causal}} \right)V. $$对于长度为 \(L\) 的输入,其计算复杂度为 \(\mathcal{O}(L^2)\)。随着 context 从 8K 增长到 128K,Attention score 的计算和中间状态会快速增加。
作者对 LLaMA-3.1-8B 4-bit 的 Attention 分布进行分析后发现,只保留少量 key 就能覆盖超过 95% 的 Attention mass。这说明长上下文中存在大量低权重 token interaction。
但是,稀疏 Attention 存在两个主要问题:
- 显著位置随输入变化。 对不同 query 和不同任务,重要 key 的位置并不固定;
- 显著 token 通常按语义片段聚集。 这些片段可能对应句子、段落、代码块或主题区域,并不与固定长度 block 对齐。
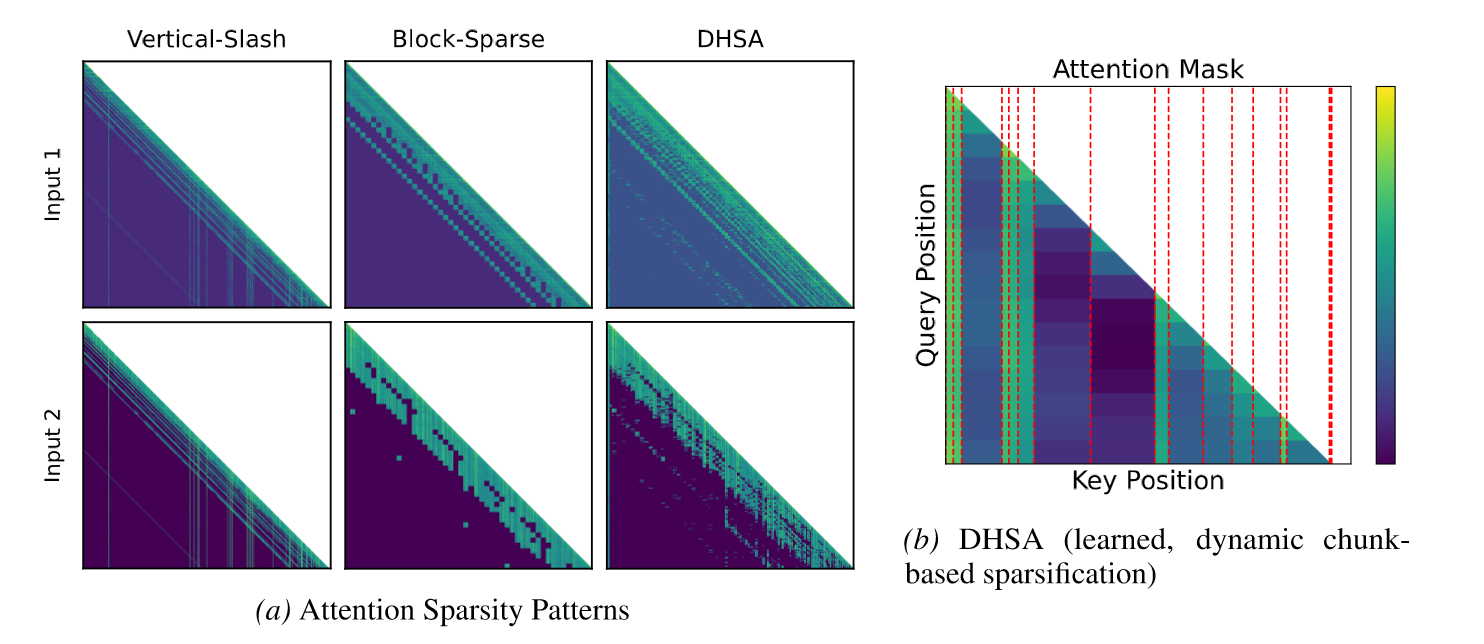
图中 Vertical-Slash 和 Block-Sparse 使用较规则的稀疏区域,而 DHSA 根据不同输入生成不同的 mask。右侧红色虚线表示动态预测的 chunk boundary。
现有方法可以分为:
- Static Sparse Attention:Sliding Window、Dilated、Strided、A-shape;
- Template-based Dynamic Attention:例如 MInference 的 Vertical-Slash;
- Fixed Block Selection:根据 block similarity 选择固定大小的 block;
- Decode-oriented KV Compression:StreamingLLM、DuoAttention、Quest 等,主要降低 decode 阶段的 KV Cache 成本。
DHSA 主要面向 prefill acceleration。它不修改 LLM 参数,而是在 query/key projection 和 Attention backend 之间增加输入相关的路由模块。
需要先区分 prefill 与 decode 的瓶颈:
| Stage | Input Shape | Main Attention Cost | DHSA in Experiments |
|---|---|---|---|
| Prefill | 一次处理长度为 \(L\) 的 prompt | 所有 causal query-key pair,近似 \(\mathcal{O}(L^2)\) | 使用动态稀疏 Attention |
| Decode | 每步新增一个 query,读取既有 KV Cache | 单步近似 \(\mathcal{O}(L)\),并受 KV Cache bandwidth 影响 | 恢复 Dense Attention |
因此,DHSA 解决的是长输入、短输出或 prefill-dominated workload。它与 KV Cache eviction、KV quantization 和 decode-time retrieval 是互补关系,不应把 10× kernel speedup 理解成整个生成过程必然加速 10×。
论文的主要贡献包括:
- 提出 chunk-to-token 的分层稀疏路由方法;
- 使用 attention-derived soft label 训练动态边界预测器;
- 提出对可变长 chunk 更稳定的长度归一化表示;
- 提供 PyTorch SDPA 和 tiled online-softmax 两种后端;
- 在 GPU、CPU 和多个开源模型家族上验证准确率、延迟和显存收益。
从系统能力看,论文将方法按 prefill、model-agnostic 和 hardware compatibility 三个维度比较:
| Method | Accelerate Prefill | Model-Agnostic | GPU + CPU |
|---|---|---|---|
| StreamingLLM | ✓ | ✓ | |
| MInference | ✓ | ✓ | |
| Block-Sparse | ✓ | ||
| DuoAttention | ✓† | ||
| SeerAttention | ✓ | ||
| Quest | ✓† | ||
| DHSA | ✓ | ✓ | ✓ |
† 表示概念上可以跨架构,但现有开源实现只支持部分模型家族。DHSA 的 model-agnostic 指算法和 backend 接口可以接入不同 Transformer;boundary predictor 仍需要按 backbone family 单独训练。
2. Dynamic Hierarchical Sparse Attention
2.1 Overall Framework
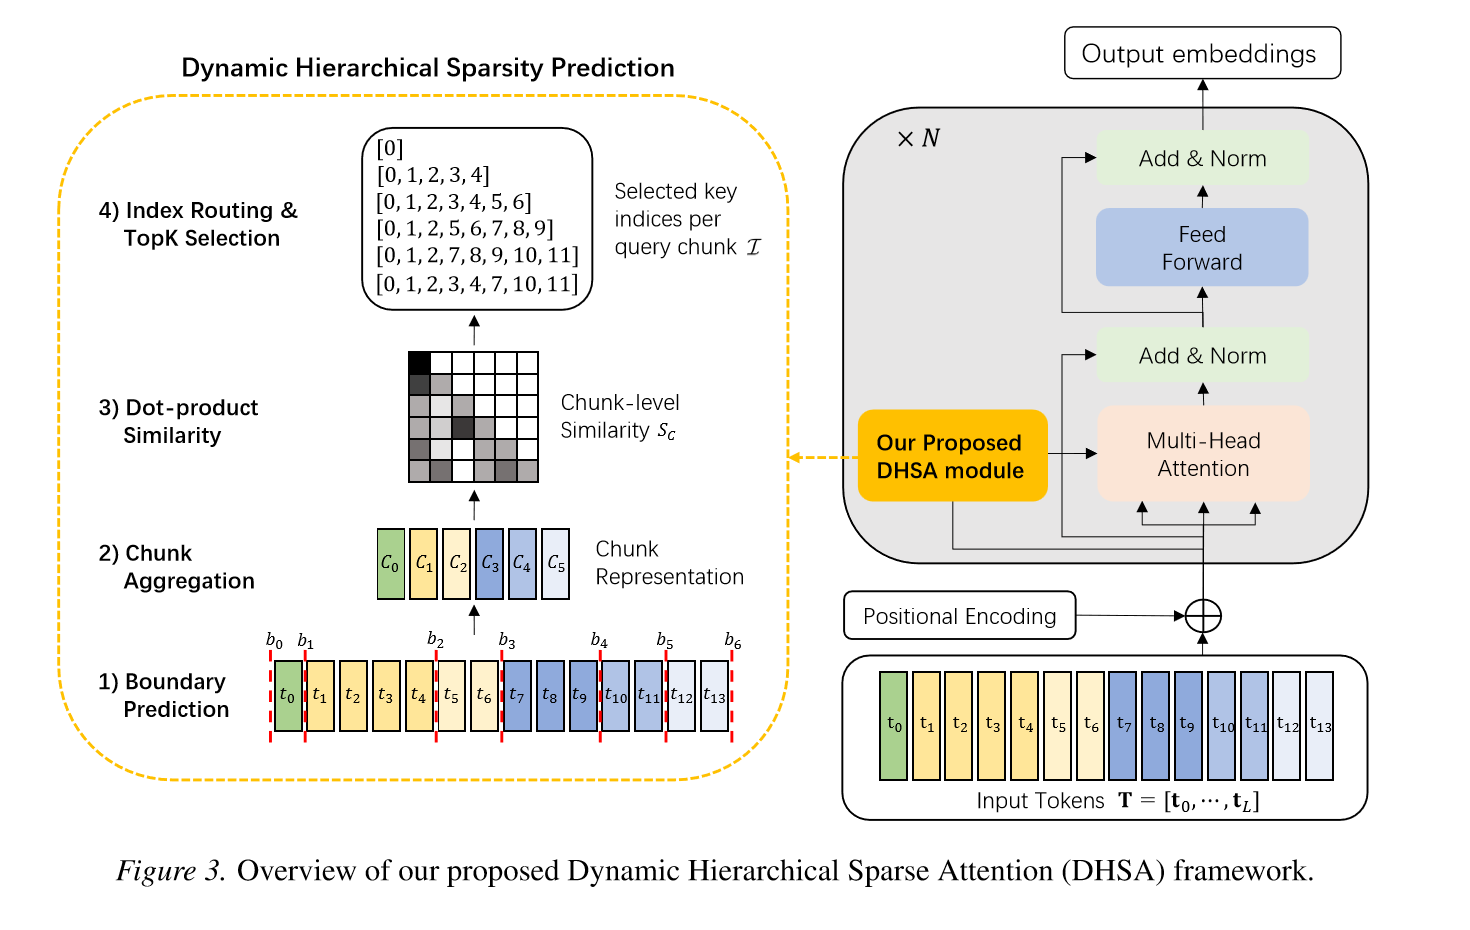
DHSA 被插入到 decoder-only Transformer 的每个 Attention layer。对于当前层的 token query/key,系统依次完成:
- Boundary Prediction:预测语义 chunk 的边界;
- Chunk Aggregation:将可变数量的 token 聚合成 chunk representation;
- Chunk Similarity:计算 chunk-level query-key similarity;
- Index Routing:为每个 query chunk 选择有限数量的 key token;
- Sparse Attention:只在选中的 key/value 上计算精确 causal attention。
这种设计将预测粒度和计算粒度分开:
- chunk-level prediction 用于降低稀疏位置预测成本;
- token-level attention 用于保留细粒度信息和精确输出。
2.2 Hierarchical Sparsity Prediction
给定长度为 \(L\) 的 token 序列:
$$ \mathbf{T} =[\mathbf{t}_0,\mathbf{t}_1,\ldots,\mathbf{t}_{L-1}], $$目标是得到 token-level sparsity mask:
$$ \mathbf{M}\in\{0,1\}^{L\times L}, $$其中 \(M_{i,j}=1\) 表示保留 query token \(i\) 与 key token \(j\) 的交互。
如果直接预测完整 \(M\),仍然需要为 \(L^2\) 个 token pair 打分,因此 DHSA 将过程拆成两步。
Step 1: Chunk-Level Prediction
根据边界集合:
$$ \mathcal{B} =\{b_0,b_1,\ldots,b_{N_c}\}, \qquad 0=b_0 \lt b_1 \lt \cdots \lt b_{N_c}=L, $$将序列切分成 \(N_c\) 个互不重叠的 chunk:
$$ \mathbf{C}_k =\mathbf{T}[b_k:b_{k+1}). $$将所有 chunk query/key 表示堆叠后得到:
$$ \mathbf{Q}_c =[\mathbf{q}_{\mathbf{C}_1},\ldots, \mathbf{q}_{\mathbf{C}_{N_c}}]^{\top}, $$$$ \mathbf{K}_c =[\mathbf{k}_{\mathbf{C}_1},\ldots, \mathbf{k}_{\mathbf{C}_{N_c}}]^{\top}. $$Chunk-level similarity matrix 为:
$$ \mathbf{S}_c =\mathbf{Q}_c\mathbf{K}_c^{\top} \in\mathbb{R}^{N_c\times N_c}. $$由于 \(N_c\ll L\),该矩阵比完整 token-level similarity matrix 更小。
Step 2: Token-Level Selection
对于每个 query chunk,DHSA:
- 根据 \(S_c\) 对因果可见的 key chunk 排序;
- 从高分到低分依次展开其中包含的 token index;
- 当 token 数量达到预算 \(N_b\) 时停止;
- 得到有序 key index 集合 \(\mathcal{I}_k\);
- 将 \(\mathcal{I}_k\) 传给 sparse attention backend。
因此,chunk 只负责路由。最终的 Attention 仍然对原始 token query、key 和 value 进行计算。
实际 backend 为了保持 GPU 计算规则,会把 query 侧划分为固定大小 \(B_r\) 的 row block,而 key 侧仍使用动态 chunk。对于第 \(i\) 个 query row block:
- 用 \(\sqrt{B_r}\cdot\mathrm{AvgPool}(Q_i)\) 得到 query representation;
- 与所有动态 key chunk representation 做点积;
- 按 similarity 从高到低遍历 key chunk;
- 将 chunk 展开成原始 token index,并裁掉位于 query 未来的 index;
- 达到 \(N_b\) 后 hard truncate,再将 index 排序以便 backend 访问。
for each query row block i:
    score = q_block[i] @ dynamic_key_chunks.T
    ranked_chunks = argsort(score, descending=True)
    selected = []

    for chunk in ranked_chunks:
        selected += causal_token_indices(chunk, query_end=i)
        if len(selected) >= token_budget:
            break

    I[i] = sort(selected[:token_budget])
这样既避免预测 \(L\times L\) mask,又确保最终 attention 的选择单位仍然是 token。动态 chunk 的长度不同,所以最后一个被选 chunk 可能只保留一部分 token;hard truncate 保证各 query block 使用相同的预算上限。
2.3 Dynamic Boundary Detection
固定大小 chunk 容易切断句子、段落或代码块。DHSA 将动态分块建模为边界检测任务:判断位置 \(i\) 是否为一个 chunk 的结尾。
2.3.1 Boundary Predictor Architecture
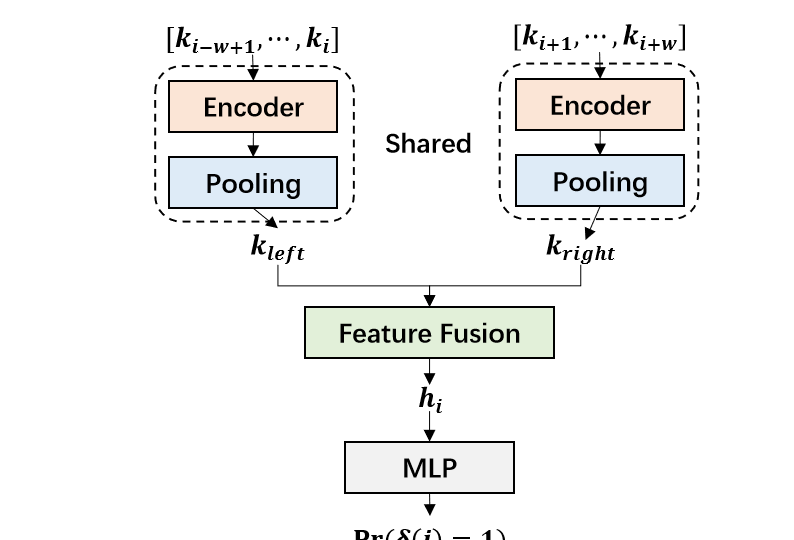
对于候选位置 \(i\),从 token key vector 中提取左右两个局部窗口:
$$ \mathbf{k}_{\mathrm{left}} =\mathrm{Pool}\!\left( \mathrm{Enc}([ \mathbf{k}_{i-w+1},\ldots,\mathbf{k}_i]) \right), $$$$ \mathbf{k}_{\mathrm{right}} =\mathrm{Pool}\!\left( \mathrm{Enc}([ \mathbf{k}_{i+1},\ldots,\mathbf{k}_{i+w}]) \right). $$Encoder 是独立于基础 LLM 参数的 self-attention module,左右窗口共享同一组参数。两个窗口的表示通过以下特征进行融合:
$$ \mathbf{h}_i =[ \mathbf{k}_{\mathrm{left}}, \mathbf{k}_{\mathrm{right}}, |\mathbf{k}_{\mathrm{left}}-\mathbf{k}_{\mathrm{right}}|, \mathbf{k}_{\mathrm{left}}\odot\mathbf{k}_{\mathrm{right}}, \mathrm{cos}(\mathbf{k}_{\mathrm{left}}, \mathbf{k}_{\mathrm{right}}) ]. $$两层 MLP 输出位置 \(i\) 是边界的概率:
$$ \Pr(\delta(i)=1)=\mathrm{MLP}(\mathbf{h}_i). $$推理时,系统先过滤低置信候选,再使用 Non-Maximum Suppression(NMS)保留每个局部邻域中分数最高的位置,避免相邻位置产生过密边界。
Encoder 内部先把窗口 key vector 投影为独立的 \(Q^b,K^b,V^b\),执行 8-head self-attention,再使用 average pooling 得到固定长度表示。窗口默认 \(w=4\),即每个候选位置共查看左右 8 个 token。Feature fusion 不只使用 cosine similarity,是因为不同信号提供互补信息:
- raw left/right vector 保留两侧语义内容;
- absolute difference 强调发生变化的维度;
- element-wise product 表示共同激活;
- cosine similarity 提供与向量尺度无关的整体对齐程度。
附录指出只使用单一 similarity 的预测不够稳定,多信号融合在不同输入长度和语义变化下更可靠。边界预测只看局部窗口,使每个位置的 receptive field 固定,整体预测成本随 \(L\) 线性增长。
2.3.2 Automatic Boundary Labeling
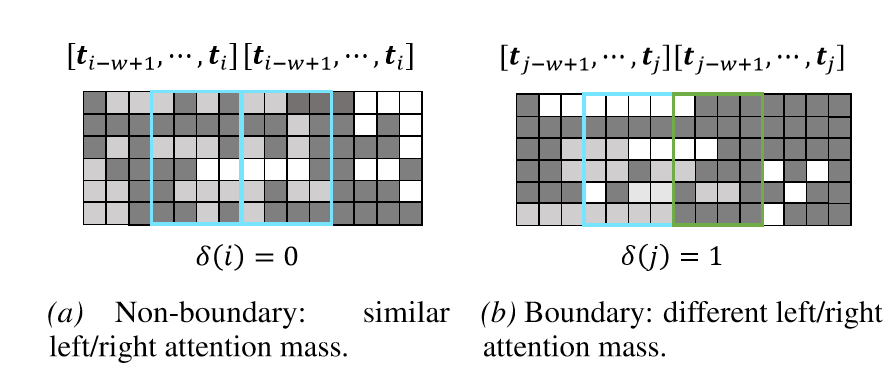
人工标注长序列中的语义边界成本很高,因此作者从冻结主干的 Dense Attention 中自动生成标签。
基本观察是:
- 同一个语义片段中的相邻 token 通常具有相似的累计 Attention pattern;
- 当语义内容发生切换时,边界左右窗口获得的累计 Attention mass 会发生明显变化。
设 Dense Attention matrix 为:
$$ A\in\mathbb{R}^{L\times L}, $$窗口大小为 \(w=4\)。位置 \(i\) 左侧窗口从后续 token 获得的累计 Attention mass 为:
$$ a_{\mathrm{past}}(i) =\frac{1}{L-1-i-w} \sum_{u=i+w+1}^{L-1} \sum_{v=i-w+1}^{i}A_{u,v}. $$右侧窗口的累计 Attention mass 为:
$$ a_{\mathrm{fut}}(i) =\frac{1}{L-1-i-w} \sum_{u=i+w+1}^{L-1} \sum_{v=i+1}^{i+w}A_{u,v}. $$定义 Attention ratio:
$$ r_i =\frac{ \max(a_{\mathrm{fut}}(i),a_{\mathrm{past}}(i))+\varepsilon }{ \min(a_{\mathrm{fut}}(i),a_{\mathrm{past}}(i))+\varepsilon }, \qquad \varepsilon=0.001. $$\(r_i\) 越大,说明左右窗口的 Attention behavior 差异越明显。生成硬边界时,作者从 \(r_i>1.1\) 的位置中选择 top-\(N_c-1\),并固定将 0 和 \(L\) 作为序列首尾边界。
2.3.3 Soft Labels and Training Loss
硬标签会受到 chunk 数量预算影响。相同的 \(r_i\) 在不同 \(N_c\) 设置下可能被标成不同类别。因此训练时将 ratio 转换为连续 soft label:
$$ y_i =\sigma\!\left( \alpha(\log(r_i+\zeta)-\beta) \right), $$其中 \(\alpha=2.0\),\(\beta=\log 2\),\(\zeta=10^{-6}\)。当 ratio 增大时,soft label 单调接近 1,但 cutoff 附近的位置仍保留连续置信信息,避免不同 chunk budget 给相同位置产生相互矛盾的 hard label。
边界 token 数量显著少于非边界 token,因此损失采用带正类权重的 focal BCE:
$$ \mathcal{L}_i =(1-p_i)^{\gamma} \left[ -w y_i\log p_i -(1-y_i)\log(1-p_i) \right], $$其中 \(\gamma=2.0\),正类权重 \(w=1.3\)。
训练数据来自 Long Data Collections、TriviaQA 和 ChatQA2,每个数据集选择前 10,000 个样本。边界预测器:
- 对每个 backbone family 单独训练;
- 保持基础 LLM 完全冻结;
- 参数量约为 20 MB;
- 在同一模型家族的所有层和数据集之间共享;
- 单张 RTX 3090 训练 10,000 steps;
- Gemma-2-2B-it 的训练时间约为 8.89 小时。
2.3.4 Data Preparation, Metrics, and Training Acceleration
三个训练数据源各取前 10,000 个训练样本,每个验证集各取前 100 个样本。训练阶段监控:
- positive precision / recall / F1,其中 soft label \(\ge 0.5\) 视为正类;
- top-\(K\) boundary overlap,\(K=500\);
- 所有 Transformer layer 的 boundary loss。
Top-\(K\) overlap 定义为预测 top-500 位置与自动标签 top-500 位置的交集大小除以 500。这个指标比单纯分类 accuracy 更贴近推理,因为部署时真正需要的是从所有候选位置中选出最值得作为边界的一小部分。
训练加速包含两点:
- Only store labels:离线只保存 boundary label,不保存体积巨大的 input embedding;标签可以并行生成;
- Train all layers together:每个样本只让冻结 LLM 前向一次,取出全部层的 embedding,再同时更新各层共享的 predictor,而不是为每层重复执行 backbone。
边界预测器训练 10,000 steps。Gemma-2-2B-it 单张 RTX 3090 每 iteration 约 3.20 秒,总计约 8.89 小时。它保持 LLM 权重冻结,但仍然需要 dense attention 输出来离线构造 supervision,因此“无需重训主模型”不等于“完全没有训练与标注成本”。
2.3.5 Boundary Inference and Hyperparameters
推理阶段对所有位置并行计算 boundary probability,然后执行两层筛选:
- threshold 去掉低置信候选;
- NMS 在局部窗口中只保留最高分位置,防止相邻 token 被连续标成多个边界。
验证集最终选择 \(w=4\)、NMS window size 8。论文在三个模型家族中复用同一组 moderate hyperparameter,而不针对 LongBench 的每个子任务单独调参。序列的 0 和 \(L\) 始终作为首尾边界,保证所有 token 都属于某个 chunk。
2.4 Robust Chunk Representation
动态分块会产生不同长度的 chunk。直接使用 average pooling 存在两个问题:
- padding 的零向量会稀释平均值;
- 长 chunk 的表示幅值可能被过度缩小。
令第 \(k\) 个 chunk 的长度为:
$$ L_k=b_{k+1}-b_k, $$DHSA 使用 prefix sum 计算真实 token 区间,并进行平方根长度归一化:
$$ \mathbf{q}_{\mathbf{C}_k} =\frac{1}{\sqrt{L_k}} \sum_{i=b_k}^{b_{k+1}-1} \mathbf{q}_i, $$$$ \mathbf{k}_{\mathbf{C}_k} =\frac{1}{\sqrt{L_k}} \sum_{i=b_k}^{b_{k+1}-1} \mathbf{k}_i. $$该表示等价于普通平均值乘 \(\sqrt{L_k}\),用于平衡 sum pooling 和 average pooling 对 chunk 长度的不同敏感性。
为什么是 \(1/\sqrt{L_k}\) 而不是 \(1/L_k\)?如果直接 sum pooling,长 chunk 仅因 token 更多就可能获得更大点积;如果使用 average pooling,长 chunk 中少量关键 token 的贡献又容易被过度稀释。平方根归一化处于两者之间,使 representation norm 随长度增长更温和。
此外,prefix sum 允许任意动态区间在常数次索引操作中求和,不需要先把可变长 chunk padding 到统一长度。这同时避免零 padding 污染均值,并降低动态分块的聚合开销。
2.5 Sparse Attention Backends
DHSA 将 query 和 key 的处理方式解耦:
- query 仍按照固定大小的 row block 处理;
- key/value 根据路由结果动态选择 token index。
固定 query block 可以保持较规则的计算形状,同时允许 key 侧使用细粒度动态稀疏模式。
PyTorch SDPA Backend
对于每个 query row block:
- 根据 \(\mathcal{I}_k\) gather 对应的 key/value;
- 使用绝对 token position 构造精确 causal mask;
- 调用 PyTorch scaled dot-product attention;
- 将结果写回对应的 query position。
该后端兼容 GPU、CPU 和不同模型家族。
具体而言,第 \(i\) 个 row block 的 query 为 \(Q[q_s:q_e)\),路由给出 index \(\mathcal{I}_i\)。backend gather:
$$ K_{\mathrm{sel}}=K[\mathcal{I}_i],qquad V_{\mathrm{sel}}=V[\mathcal{I}_i], $$再用 query 和 selected key 的绝对位置构造 \(\{0,-\infty\}\) causal mask。不能只依赖局部矩阵下三角,因为 gather 后的列号不再等于原始 token position。该 backend 支持 token-level selection,并通过 tile 与 buffer reuse 控制大 \(|\mathcal{I}_i|\) 时的峰值内存。
Tiled Online-Softmax Backend
GPU tiled backend 采用类似 FlashAttention 的 streaming softmax:
- 将 selected keys 划分为 column tile;
- 逐 tile 计算 \(QK^{\top}/\sqrt d\);
- 应用基于绝对位置的 causal mask;
- 在线更新 softmax maximum、normalization term 和 weighted sum;
- 不物化完整 Attention probability matrix。
默认 row block size 和 column tile size 都设置为 128。对于 64K 以上输入,系统还会 tile boundary MLP、释放临时 buffer,并在条件允许时缓存边界和路由结果。
在线 softmax 对每个 column tile 更新三个状态:当前行最大值 \(m\)、归一化和 \(\ell\)、未归一化加权和 \(O_{\mathrm{sum}}\)。新 tile 到来时先用新的最大值重标定旧统计,再累积当前 tile,最终输出 \(O_{\mathrm{sum}}/\ell\)。因此无需物化完整 attention probability matrix,同时与一次性 softmax 保持数值等价。
两种 backend 的取舍为:
| Backend | Advantage | Limitation | Suitable Scenario |
|---|---|---|---|
| PyTorch SDPA | 实现简单、模型与硬件兼容性高、支持 CPU | gather 和 mask 物化有额外开销 | 原型验证、Gemma、CPU 部署 |
| Tiled online-softmax | 峰值显存低、GPU 长序列吞吐更高 | 需要专门 kernel 与硬件适配 | NVIDIA GPU 长上下文 prefill |
2.6 Complexity
每个 Transformer layer 的计算成本包括:
- boundary prediction:\(\mathcal{O}(L)\);
- chunk representation:\(\mathcal{O}(L)\);
- chunk similarity:\(\mathcal{O}(N_c^2)\);
- sparse token attention:\(\mathcal{O}(L N_b)\)。
因此总复杂度约为:
$$ \mathcal{O}(L) +\mathcal{O}(N_c^2) +\mathcal{O}(L N_b). $$Token density 定义为:
$$ \rho=\frac{N_b}{L}. $$当 \(N_b\) 和 \(N_c\) 固定时,DHSA 随序列长度近似线性扩展;当 density 固定时,主要 Attention 项为 \(\mathcal{O}(\rho L^2)\),但只计算原 Dense Attention 中的 \(\rho\) 比例,并降低中间矩阵和显存开销。
严格说,“near-linear scaling”只成立于固定 \(N_b\) 和固定/受控 \(N_c\)。实验常用固定 density \(\rho=N_b/L\),此时 \(N_b\) 会随 \(L\) 增长,\(L N_b=\rho L^2\) 仍是二次项,只是常数缩小到 Dense Attention 的一部分。DHSA 的实际优势来自较低 density、避免 \(L\times L\) score matrix,以及 kernel 能够跳过未选 key,而不是在任意配置下都把理论复杂度变成线性。
3. Experiments
3.1 Experimental Setup
Models
| Model | Precision | Maximum Context |
|---|---|---|
| LLaMA-3.1-8B-Instruct | 4-bit | 128K |
| Qwen2.5-3B-Instruct | BF16 | 32K |
| Gemma-2-2B-it | BF16 | 8K |
附加实验还包括 LLaMA-3.1-8B BF16 和 Qwen2.5-14B 4-bit。
LLaMA 与 Qwen 的所有层使用 global attention;Gemma-2 每隔一层使用 global attention,其余层为 4,096-token sliding window。LongBench 中 LLaMA 为适配单张 24GB GPU,将评测上限设为 48K;超过模型上限的样本保留开头 1K token 和末尾 \(C_{\max}-1\mathrm{K}\) token。
实验环境为:
| Platform | Hardware | Software |
|---|---|---|
| GPU | NVIDIA RTX 3090 24GB, Ubuntu 22.04.4 | Python 3.12, CUDA 12.4, PyTorch 2.5.1+cu124, Transformers 4.52.3 |
| CPU | Intel Core 5 120U, 10 cores / 12 threads, Windows 11 | Python 3.11, PyTorch 2.9.1+cpu, Transformers 4.52.3 |
Benchmarks
- LongBench:single-document QA、multi-document QA、summarization、few-shot learning、synthetic task 和 code;
- Needle-in-a-Haystack:评测不同上下文长度和插入深度下的远距离检索;
- RULER:控制上下文长度,并包含需要组合多个分散证据的任务。
LongBench 共 16 个数据集:
| Category | Datasets | Main Metric |
|---|---|---|
| Single-document QA | NarrativeQA, Qasper, MultiFieldQA_en | F1 |
| Multi-document QA | HotpotQA, 2WikiMultihopQA, MuSiQue | F1 |
| Summarization | GovReport, QMSum, MultiNews | ROUGE-L |
| Few-shot learning | TREC, TriviaQA, SAMSum | Accuracy / F1 |
| Synthetic | PassageCount, PassageRetrieval_en | Accuracy |
| Code | LCC, RepoBench-P | Edit Similarity |
各数据集平均长度约 1.2K–18K token,正文表格先对 category 内数据集取平均,再报告六类任务的总平均。
Needle-in-a-Haystack 的标准设置使用 1K–64K context、0%–100% insertion depth,depth 间隔 10%。Needle 是关于在 Dolores Park 吃三明治的句子,retrieval question 要求补全 “The best thing to do in San Francisco is:”,以 ROUGE 判断是否正确;扩展图进一步测试到 100K。
Baselines
- StreamingLLM;
- StreamingLLM with dilated / strided pattern;
- MInference;
- Block-Sparse Attention;
- DuoAttention;
- SeerAttention;
- Quest。
所有方法在 6.25%、12.5% 和 25% token density 下进行匹配比较。GPU 实验使用单张 RTX 3090 24GB;CPU 实验使用 Intel Core 5 120U。
具体 budget 配置如下:
| Baseline | Configuration |
|---|---|
| StreamingLLM | 20% preserved keys 为 global token,80% 为 local window |
| Dilated | 20% global + 80% dilated,interval = 1 |
| Strided | 20% global + 40% local + 40% dilated,interval = 1 |
| MInference | Vertical-Slash;50% vertical + 50% slash;last_q=64 |
| Block-Sparse | 固定 block size = 128 |
| DuoAttention | 学习 retrieval/streaming head mask,并调整 sparsity ratio 匹配 density |
| SeerAttention | 调整 non-zero ratio 匹配目标 density |
| Quest | decode token budget 对齐相同有效 density |
所有生成使用 greedy decoding。MInference、Block-Sparse、SeerAttention 和 DHSA 在 prefill 使用 sparse attention、decode 恢复 dense;DuoAttention 与 Quest 本身是 decode-oriented,保留其官方 dense-prefill / sparse-decode 实现,主要用于下游准确率参考。DuoAttention 实际会因 streaming head 额外保留 attention sink 与 recent token,所以有效 token 数略高于其他方法。
3.2 LongBench Main Results
在 token density 为 12.5% 时,三种 backbone 的完整 category-level 结果如下:
LLaMA-3.1-8B-Instruct 4-bit
| Method | Single | Multi | Summ. | Few-shot | Synth. | Code | Avg. |
|---|---|---|---|---|---|---|---|
| Dense | 22.0 | 10.5 | 29.4 | 68.3 | 44.0 | 22.3 | 32.7 |
| StreamingLLM | 15.0 | 6.8 | 27.7 | 62.3 | 26.0 | 22.0 | 27.0 |
| StreamingLLM + Dilated | 15.1 | 6.7 | 27.6 | 62.3 | 26.0 | 22.1 | 27.0 |
| StreamingLLM + Strided | 12.0 | 5.0 | 25.5 | 58.9 | 11.3 | 24.1 | 23.4 |
| MInference | 17.6 | 8.2 | 26.7 | 67.8 | 24.3 | 22.1 | 28.4 |
| Block-Sparse | 16.3 | 7.4 | 22.3 | 59.7 | 44.2 | 20.5 | 27.9 |
| DuoAttention | 13.0 | 6.5 | 26.4 | 60.9 | 3.5 | 22.5 | 23.3 |
| SeerAttention | 19.9 | 10.4 | 25.6 | 68.7 | 40.1 | 19.5 | 30.8 |
| Quest | 22.4 | 10.7 | 27.1 | 60.3 | 45.2 | 21.4 | 30.9 |
| DHSA | 18.3 | 10.1 | 26.9 | 68.8 | 45.7 | 22.7 | 31.8 |
Qwen2.5-3B-Instruct BF16
| Method | Single | Multi | Summ. | Few-shot | Synth. | Code | Avg. |
|---|---|---|---|---|---|---|---|
| Dense | 12.7 | 6.9 | 25.5 | 66.9 | 20.0 | 19.8 | 26.0 |
| StreamingLLM | 9.2 | 6.0 | 25.7 | 54.8 | 2.5 | 19.8 | 20.7 |
| StreamingLLM + Dilated | 9.7 | 6.2 | 25.0 | 54.0 | 3.3 | 19.6 | 20.7 |
| StreamingLLM + Strided | 8.1 | 7.0 | 24.7 | 47.2 | 2.1 | 18.1 | 18.8 |
| MInference | 10.1 | 5.5 | 24.1 | 57.0 | 2.5 | 19.6 | 21.1 |
| Block-Sparse | 9.6 | 4.6 | 21.3 | 56.1 | 10.0 | 17.5 | 20.6 |
| DHSA | 11.3 | 7.9 | 24.7 | 67.2 | 14.0 | 21.6 | 25.3 |
Gemma-2-2B-it BF16
| Method | Single | Multi | Summ. | Few-shot | Synth. | Code | Avg. |
|---|---|---|---|---|---|---|---|
| Dense | 27.0 | 26.2 | 24.7 | 65.0 | 7.5 | 25.5 | 30.9 |
| StreamingLLM | 13.6 | 15.2 | 22.9 | 53.4 | 7.5 | 26.2 | 23.9 |
| StreamingLLM + Dilated | 14.8 | 16.5 | 22.3 | 52.2 | 10.0 | 28.7 | 24.7 |
| StreamingLLM + Strided | 14.1 | 15.1 | 23.2 | 51.2 | 10.0 | 24.4 | 23.7 |
| MInference | 17.3 | 20.8 | 22.3 | 58.0 | 5.0 | 27.5 | 26.3 |
| Block-Sparse | 11.4 | 17.4 | 16.3 | 51.6 | 2.5 | 25.1 | 21.6 |
| DHSA | 27.6 | 24.5 | 23.1 | 64.4 | 7.5 | 25.4 | 30.3 |
DHSA 在三个 backbone 上都比固定 Block-Sparse 更接近 Dense Attention。LLaMA-3.1-8B 上只保留 12.5% key 时,平均分从 Dense 的 32.7 降到 31.8;Block-Sparse 则下降到 27.9。Gemma 上的差距最明显:DHSA 30.3,已经接近 Dense 30.9,而 Block-Sparse 只有 21.6。
不同 density 下的 LLaMA 平均分为:
| Density | Single | Multi | Summ. | Few-shot | Synth. | Code | Avg. |
|---|---|---|---|---|---|---|---|
| 6.25% | 18.1 | 7.2 | 21.2 | 64.4 | 36.3 | 20.2 | 27.7 |
| 12.5% | 18.3 | 10.1 | 26.9 | 68.8 | 45.7 | 22.7 | 31.8 |
| 25.0% | 24.3 | 10.2 | 28.9 | 69.4 | 52.7 | 23.7 | 34.4 |
| Dense | 22.0 | 10.5 | 29.4 | 68.3 | 44.0 | 22.3 | 32.7 |
随着 token budget 增大,DHSA 的性能单调提升。25% density 下平均分高于 Dense baseline,表明动态选择也可能减少部分低相关 Attention interaction,但该结果仍受到具体任务分布和评测波动影响。
3.3 Needle-in-a-Haystack
在 6.25% token density 下,DHSA 在 1K 到 100K context 范围内测试不同 needle depth。结果显示,大部分上下文长度和插入位置都能够成功恢复目标句子。
固定 Block-Sparse 在 needle 超出局部或固定 block 范围时准确率明显下降,而 DHSA 可以通过输入相关的 chunk routing 选择远距离 key。
在单张 RTX 3090 24GB 上:
- Eager Attention 在较短 context 即出现 OOM;
- Torch SDPA 和 FlashAttention-2 无法扩展到 100K;
- DHSA 可以完成 LLaMA-3.1-8B 4-bit 的 100K prefill。
3.4 Overlap with Oracle Top-K Attention
NIAH 的正确率只能说明最终是否取回 needle,不能直接观察稀疏 mask 是否保留 Dense Attention 真正关注的 key。因此作者在 32K context 的最后 4K query token 上计算 retained-key overlap:
$$ \mathrm{Overlap@K} =\frac{|I_{\mathrm{sparse}}\cap I_{\mathrm{dense\ topK}}|}{K}. $$实验从 LLaMA-3.1-8B 4-bit 的所有 layer 与 head 提取 Dense Attention score,再对 overlap 取模型级平均。Figure 12 显示,在不同 retained-key budget 下,DHSA 始终比 Streaming、MInference 和 Block-Sparse 保留更多 dense top-K key。
这项结果直接支持 hierarchical routing 的机制:收益不是仅由保留 local window 或 attention sink 获得,而是动态 chunk ranking 更有效地把有限预算分配给当前输入中真正高权重的区域。它也与后文理论中的 recall 指标对应。
3.5 RULER
RULER 不只包含单 needle 检索,还包含 QA-1、QA-2 和 VT 等需要从多个位置组合证据的任务。
| Method @ 12.5% | 4K | 8K | 16K | 32K | 48K |
|---|---|---|---|---|---|
| Dense | 95.8 | 93.8 | 93.2 | 81.5 | 75.2 |
| MInference | 91.7 | 88.4 | 88.6 | 74.7 | 64.2 |
| Block-Sparse | 60.3 | 65.4 | 69.3 | 53.0 | 43.1 |
| DHSA | 92.1 | 88.5 | 88.7 | 76.2 | 71.5 |
DHSA 在 32K 和 48K 上获得稀疏基线中的最高平均分,说明动态路由可以同时保留多个分散相关区域,而不仅依赖局部窗口或单个检索位置。
论文还给出 QA-1、QA-2 和 VT 的任务级结果:
| Method | 4K QA-1 | QA-2 | VT | 8K QA-1 | QA-2 | VT | 16K QA-1 | QA-2 | VT | 32K QA-1 | QA-2 | VT |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Dense | 83.8 | 72.0 | 100.0 | 78.5 | 72.0 | 99.6 | 72.2 | 66.0 | 100.0 | 70.5 | 66.0 | 67.6 |
| Block-Sparse | 23.0 | 32.0 | 85.2 | 37.2 | 34.0 | 84.0 | 33.7 | 44.0 | 82.4 | 24.2 | 28.0 | 24.0 |
| DHSA | 74.3 | 65.8 | 99.4 | 69.1 | 63.3 | 97.6 | 63.5 | 61.1 | 97.9 | 59.2 | 56.8 | 61.4 |
DHSA 在每个长度与三个任务上都高于 Block-Sparse。特别是在 32K,QA-1 / QA-2 从 24.2 / 28.0 提升到 59.2 / 56.8,说明动态 mask 可以同时覆盖多个分散证据区域,而固定 block 在相同 budget 下会浪费大量 token。
3.6 Accuracy-Speed Trade-Off
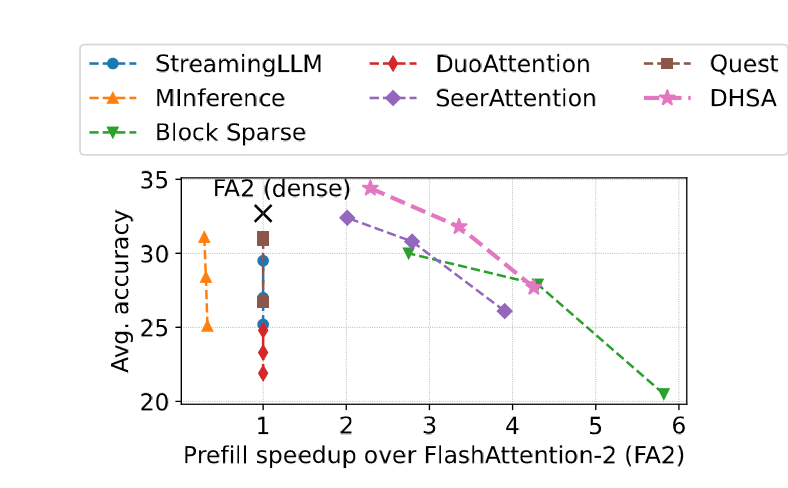
图中横轴为相对 FlashAttention-2 的 prefill kernel speedup,纵轴为 LongBench average accuracy。DHSA 在 6.25%、12.5% 和 25% 三种 density 下形成较好的 accuracy-speed curve。
Block-Sparse 在低 density 下可以获得较高速度,但准确率下降明显;DHSA 的速度接近 Block-Sparse,同时保持更高的 LongBench 分数。
3.7 Prefill Kernel Latency
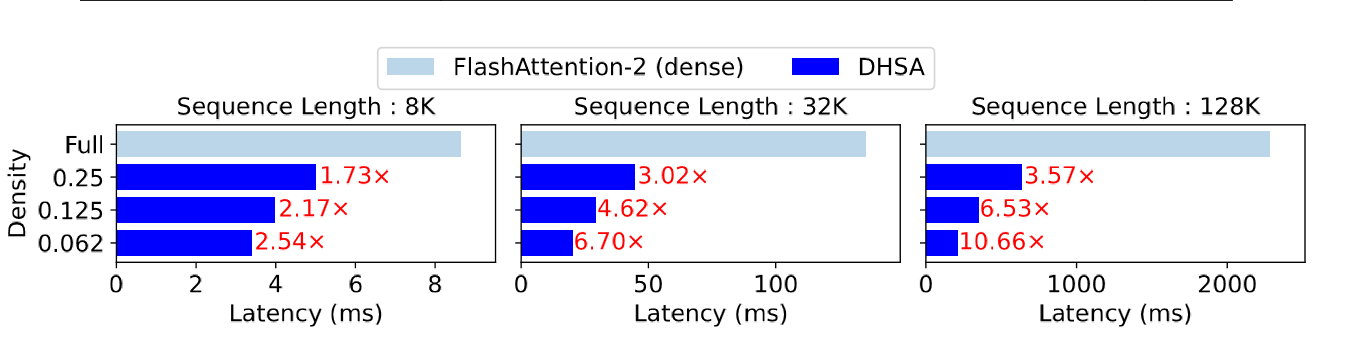
| Context Length | 25% Density | 12.5% Density | 6.25% Density |
|---|---|---|---|
| 8K | 1.73× | 2.17× | 2.54× |
| 32K | 3.02× | 4.62× | 6.70× |
| 128K | 3.57× | 6.53× | 10.66× |
上下文越长、density 越低,Sparse Attention 节省的计算越多。128K、6.25% density 下,DHSA kernel 相比 Dense FlashAttention-2 获得约 10.66× 加速。
额外实验显示,该加速可以扩展到更大或更高精度的 backbone:
| Model | Dense FA2 @ 128K | DHSA 6.25% @ 128K |
|---|---|---|
| LLaMA-3.1-8B BF16 | 2297.3 ms | 214.5 ms |
| Qwen2.5-14B 4-bit | 2873.2 ms | 270.3 ms |
3.8 End-to-End TTFT
LongBench 16 个数据集上的平均结果:
| Method | Average TTFT |
|---|---|
| Dense FA2 | 3.28 s |
| DHSA | 1.88 s |
代表性数据集的端到端 TTFT 为:
| Dataset | Average Tokens | Dense FA2 | DHSA | Reduction |
|---|---|---|---|---|
| NarrativeQA | 29,869 | 10.73 s | 5.37 s | 50.0% |
| HotpotQA | 12,854 | 3.71 s | 2.04 s | 45.0% |
| MuSiQue | 15,617 | 4.59 s | 2.32 s | 49.5% |
| QMSum | 13,917 | 4.05 s | 2.15 s | 46.9% |
| PassageCount | 14,970 | 4.38 s | 2.26 s | 48.4% |
| RepoBench-P | 10,818 | 3.07 s | 1.84 s | 40.1% |
| 16-dataset Average | – | 3.28 s | 1.88 s | 42.7% |
不同输入长度下的组件开销为:
| Component | 8K | 16K | 32K |
|---|---|---|---|
| Boundary Prediction | 45 ms | 97 ms | 201 ms |
| Routing / Chunk Selection | 237 ms | 379 ms | 944 ms |
| Sparse Attention Kernel | 128 ms | 316 ms | 939 ms |
| DHSA TTFT | 1,550 ms | 2,360 ms | 5,830 ms |
| Dense FA2 TTFT | 2,170 ms | 4,710 ms | 11,680 ms |
32K 时 routing cost 为 944 ms,与 sparse attention kernel 的 939 ms 接近,说明动态索引生成会引入额外开销。但随着 context 增长,减少 Dense Attention 计算带来的收益超过 routing cost,使端到端 TTFT 仍降低约 2×。
3.9 Batch Inference
不同样本会产生不同的稀疏 mask,因此 Dynamic Sparse Attention 很难直接使用统一的 batch pattern。DHSA 使用轻量 for-loop 逐样本处理,而不强制 batch 内共享 mask。
在显存受限设置中,这种方法可以避免 batched FlashAttention-2 的 OOM,并获得更低 latency;但它无法完全利用规则大 batch 的并行能力。
这是一种明确面向 memory-constrained setting 的选择:为每个样本保留独立 mask,不为了 batch efficiency 牺牲动态性。batch size 较小、输入很长时,避免 OOM 的收益大于 Python/dispatch 层面的序列化开销;显存充足且 batch 很大时,规则 Dense FA2 仍可能更容易发挥吞吐优势。
3.10 Ablation Study
LLaMA-3.1-8B 4-bit、LongBench、12.5% density 下:
| Variant | Average Score |
|---|---|
| DHSA | 31.8 |
| w/o Robust Chunk Representation | 30.7 |
| w/o Dynamic Chunking | 28.0 |
| w/o Both Components | 27.9 |
Dynamic Chunking 带来主要性能提升:移除后平均分从 31.8 降到 28.0。Robust Chunk Representation 在动态分块基础上继续提升 1.1 分。当两个组件都移除时,方法退化为标准固定 Block-Sparse,分数为 27.9。
完整 category-level ablation 为:
| Variant | Single | Multi | Summ. | Few-shot | Synth. | Code | Avg. |
|---|---|---|---|---|---|---|---|
| DHSA | 18.3 | 10.1 | 26.9 | 68.8 | 45.7 | 22.7 | 31.8 |
| w/o Robust Chunk Repr. | 17.1 | 8.2 | 27.0 | 67.2 | 45.0 | 21.4 | 30.7 |
| w/o Dynamic Chunking | 16.4 | 7.4 | 22.1 | 59.8 | 44.0 | 20.6 | 28.0 |
| w/o Both | 16.3 | 7.4 | 22.3 | 59.7 | 44.2 | 20.5 | 27.9 |
Dynamic Chunking 对 few-shot learning 的影响尤其大,从 68.8 降到 59.8;Robust Chunk Representation 的收益较平均,说明前者决定能否对齐相关语义区域,后者主要改善选中区域的排序稳定性。
3.11 Hyperparameter Sensitivity
Gemma-2-2B-it、12.5% density 下,boundary receptive field 的敏感性为:
| Context Window \(w\) | 1 | 2 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|---|
| Score | 22.8 | 23.6 | 25.4 | 24.8 | 24.1 | 23.5 |
NMS window 的结果为:
| NMS Window | 0 | 1 | 2 | 4 | 8 | 16 | 32 | 64 | 128 |
|---|---|---|---|---|---|---|---|---|---|
| Score | 23.8 | 24.2 | 24.6 | 25.1 | 25.4 | 25.0 | 24.4 | 23.6 | 22.5 |
\(w\) 太小会缺少判断语义变化的局部证据,太大则会把多个主题平滑在一起;NMS 太小产生过密边界,太大又会压掉有效的相邻边界。中等设置形成稳定平台,论文最终使用 \(w=4\)、NMS window 8,并跨模型家族复用。
3.12 Larger and Higher-Precision Backbones
| Backbone | Dense | Block-Sparse | DHSA |
|---|---|---|---|
| LLaMA-3.1-8B BF16 | 41.5 | 33.4 | 40.4 |
| Qwen2.5-14B 4-bit | 36.5 | 23.6 | 34.3 |
DHSA 在 LLaMA BF16 和 Qwen2.5-14B 4-bit 上仍然保持接近 Dense Attention 的 LongBench 平均分,并明显优于相同 token density 的 Block-Sparse。
完整 category-level 结果显示,LLaMA BF16 上 DHSA 的 code score 为 61.4,甚至略高于 Dense 的 60.3;Qwen2.5-14B 上 synthetic score 为 43.0,远高于 Block-Sparse 的 11.3,但仍低于 Dense 的 48.6。这表明扩大 backbone 不会消除动态路由优势,但不同任务对稀疏化的敏感度仍有明显差异。
4. Relation to Existing Approaches
4.1 Static Sparse Attention
Sliding-window、dilated、strided、Longformer/BigBird-style local-global pattern 的优势是 mask 规则、kernel 友好,但通常需要在预训练阶段就让模型适应这种连接方式。直接把已经使用 Dense Attention 训练的 LLM 改成静态 pattern,重要 token 一旦落在模板外就会产生明显精度损失。
4.2 Dynamic Prefill Attention
MInference 根据 Vertical-Slash、A-shape 和 Block-Sparse 等模板识别 attention pattern,计算效率高,但候选结构仍由预定义模板限制。Fixed Block-Sparse 可以根据相似度动态选择 block,却受固定 block boundary 约束:语义片段跨越边界时,要么漏掉一半,要么连同大量无关 token 一起保留。
SeerAttention 学习 block mask,预测能力更强,但需要模型/实现适配。DHSA 的区别是同时学习边界位置与chunk relevance:先让计算单元对齐输入中的语义变化,再在这些单元之间做动态选择。
4.3 Decode and KV-Cache Optimization
StreamingLLM、H2O、DuoAttention、Quest 和 KV quantization 主要减少 decode 时需要保留或读取的 KV Cache。它们能够降低长输出的 memory bandwidth 与 cache capacity,但不会直接减少 prompt prefill 中的 \(QK^\top\) 计算。DHSA 当前实验只稀疏 prefill,因此两类方法可以组合:prefill 由 DHSA 路由,decode 再使用 KV eviction、retrieval 或 quantization。
5. Theoretical Analysis
论文使用一个简化的 semantic segment model 比较 DHSA 与固定 Block-Sparse。分析单位是单层、单 head、单个 query \(i\)。令未归一化 attention importance 为 \(a_{ij}\ge0\),Dense Attention 的 oracle top-\(K\) key set 为 \(I_i^\star\)。
对任意稀疏选择 \(\widehat I_i\),recall 定义为:
$$ \mathrm{Recall}_i(\widehat M) =\frac{|I_i^\star\cap\widehat I_i|}{|I_i^\star|}, \qquad |\widehat I_i|=|I_i^\star|=K. $$相同 token budget 是比较成立的关键,否则选择更多 key 的方法自然会获得更高 recall。
5.1 Semantic Segment Assumption
将序列划分为连续语义片段:
$$ \mathcal{S}_c =\{b_{c-1}+1,\ldots,b_c\}, \qquad c=1,\ldots,C. $$第 \(c\) 个 segment 对 query \(i\) 的平均重要性为:
$$ \mu_{ic} =\frac{1}{|\mathcal{S}_c|} \sum_{j\in\mathcal{S}_c}a_{ij}. $$定义 segment 内最大变化 \(\epsilon_{\mathrm{intra}}\) 与 segment 间最小均值差 \(\Delta_{\mathrm{inter}}\),并假设:
$$ \epsilon_{\mathrm{intra}} \ll \Delta_{\mathrm{inter}}. $$直观上,同一短语、句子或代码块内 token 的重要性接近,而跨越语义边界时重要性发生更明显的改变。
假设:
- 重要 key 聚集在长度为 \(m\) 的连续语义片段中;
- 同一片段内部的 importance 变化较小;
- 不同片段的平均 importance 差异较大;
- 预测边界相对真实边界最多偏移 \(\delta\) 个 token。
进一步假设共有 \(R\) 个 relevant segment,每个长度为 \(m\),其中所有 token 都属于 oracle important set,因此:
$$ K=|I_i^\star|=Rm. $$DHSA 的 chunk similarity 能正确区分 relevant 与 irrelevant segment;预测 chunk 与真实 relevant segment 的左右边界误差都不超过 \(\delta\)。
5.2 DHSA Recall Lower Bound
在 chunk ranking 保持正确时,DHSA 的 recall 下界为:
$$ \mathrm{Recall}_i(M^{\mathrm{DHSA}}) \ge 1-\frac{2\delta}{m}. $$证明思路很直接:每个 relevant segment 最多在左、右边界各漏掉 \(\delta\) 个 token,所以 \(R\) 个 segment 总共最多漏掉 \(2\delta R\) 个 important token。除以 oracle important token 总数 \(Rm\):
$$ 1-\frac{2\delta R}{Rm} =1-\frac{2\delta}{m}. $$当边界误差远小于真实片段长度,即 \(\delta\ll m\),recall 接近 1。
5.3 Fixed Block-Sparse Upper Bound
对于 block size 为 \(B\ge m\) 的固定 Block-Sparse,在语义片段跨越 block boundary 的不利对齐下:
$$ \mathrm{Recall}_i(M^{\mathrm{block}}) \le \frac{m}{2B}. $$在该构造中,每个长度为 \(m\) 的 relevant segment 恰好跨过两个 fixed block,每个 block 最多只含 \(m/2\) 个 important token,却必须为整个 \(B\) token 付出预算。相同预算 \(K=Rm\) 最多选择:
$$ S\le\frac{K}{B}=\frac{Rm}{B} $$个 block。每个 block 最多贡献 \(m/2\) 个 important token,所以 captured important keys 的比例至多为 \(m/(2B)\)。
5.4 Comparison and Scope
当 \(\delta\ll m\ll B\) 时,动态边界只会损失语义片段边缘的少量 token;固定 block 则可能把大量预算用于与重要片段处于同一 block 的无关 token。
该分析依赖语义片段连续、边界预测准确等假设,并使用了固定 block 的不利对齐情况,因此主要用于说明动态语义边界的结构优势,而不是一般条件下的无条件性能保证。
理论与实验通过 Top-K overlap 相互对应:理论比较 oracle important set recall,Figure 12 则直接测量不同 sparse mask 与 Dense top-K key 的交集。DHSA overlap 更高说明其优势不只存在于合成的边界对齐构造中。
5.5 Cost Analysis
每层新增成本为:
$$ \underbrace{\mathcal{O}(L)}_{\text{boundary}} +\underbrace{\mathcal{O}(L)}_{\text{chunk repr.}} +\underbrace{\mathcal{O}(N_c^2)}_{\text{chunk similarity}} +\underbrace{\mathcal{O}(LN_b)}_{\text{sparse attention}}. $$固定 \(N_b,N_c\) 时接近线性;固定 density 时仍含 \(\rho L^2\)。与 fixed Block-Sparse 相比,渐近复杂度相近,DHSA 的额外成本来自 boundary predictor 和动态 routing,收益来自更高 recall,以及在相同 accuracy 下可以使用更低 token density。
6. Limitations
DHSA 仍存在以下限制:
- 主要优化 prefill。 实验中的 DHSA 在 decode 阶段恢复 Dense Attention,因此长输出的 KV Cache 访问和逐 token decode 成本没有被直接优化;
- 不是完全 training-free。 LLM backbone 保持冻结,但每个模型家族需要单独训练约 20 MB 的 boundary predictor;
- Routing 存在明显开销。 32K 输入下 routing cost 与 sparse attention kernel cost 接近;
- 动态 mask 不利于规则 batching。 逐样本 for-loop 适合显存受限场景,但大 batch 并行能力有限;
- 低 density 会产生信息损失。 多个弱相关片段共同决定答案时,chunk ranking 可能遗漏单独分数不高的证据;
- 实际收益依赖 kernel 和硬件。 不规则 gather、index routing 和 memory access 会使理论 FLOPs 与真实 latency 之间存在差异;
- 边界预测器需要模型适配。 算法接口可以跨模型使用,但不同 backbone family 仍需要重新训练或校准 predictor。
7. Conclusion
DHSA 是一个面向长上下文 prefill 的动态稀疏注意力框架。它保持 LLM backbone 冻结,通过动态边界检测将 token 划分为可变长语义 chunk,再使用 chunk-level similarity 为每个 query chunk 路由有限数量的 key token。
完整流程为:
$$ \text{Token Keys} \rightarrow \text{Boundary Prediction} \rightarrow \text{Chunk Representation} \rightarrow \text{Chunk Similarity} \rightarrow \text{Token Index Routing} \rightarrow \text{Sparse Causal Attention}. $$实验表明,DHSA 在 12.5% token density 下可以在多个模型家族上保持接近 Dense Attention 的 LongBench 和 RULER 性能。通过 tiled online-softmax backend,128K context 下获得最高约 10.66× kernel-level prefill speedup,并使 LLaMA-3.1-8B 4-bit 能够在单张 24GB GPU 上处理 100K context。