LongCodeZip: Compress Long Context for Code Language Models
Conference: ASE 2025
Paper: https://arxiv.org/abs/2510.00446
Github: https://github.com/YerbaPage/LongCodeZip
Authors: Yuling Shi, Yichun Qian, Hongyu Zhang, Beijun Shen, Xiaodong Gu
Abstract
代码大模型在仓库级补全、模块总结和跨文件问答中,通常需要读取远超单个函数的上下文。直接把整个仓库送入模型不仅带来更高的推理延迟、显存和 API 费用,还可能因为 lost-in-the-middle 现象让真正有用的信息淹没在长上下文中。最直接的检索增强生成(RAG)虽然能够选取与问题相似的代码,却容易漏掉变量名和表面语义都不相似、但在执行逻辑上不可缺少的依赖。
LongCodeZip 是一个 training-free、model-agnostic、plug-and-play 的长代码上下文压缩框架。它把压缩拆成两个层次:
- Coarse-grained compression:以函数或类为单位,使用指令条件下的近似互信息 AMI 排序,优先保留能帮助模型理解当前任务的代码实体;
- Fine-grained compression:在保留下来的长函数内部,根据逐行困惑度变化切分语义块,再通过自适应预算和 0/1 背包选择最有价值的代码块。
这种设计同时利用了代码的层次结构和任务相关性。论文在 Long Code Completion、Long Module Summarization 与 RepoQA 三类任务上评估 LongCodeZip,在最高 5.6× 有效压缩率下仍能维持甚至提高任务性能,并显著降低生成阶段的时间与额外显存开销。
1. Motivation
1.1 Long Code Context 的实际代价
仓库级任务所需要的信息往往分散在不同文件、类和函数中。随着上下文长度增加,会同时出现四类问题:
- 计算代价增加:标准全注意力的计算量随序列长度近似二次增长;
- 部署成本增加:更长的 KV Cache 占用更多显存,闭源 API 也按输入 token 计费;
- 有效性下降:无关代码会稀释模型注意力,长上下文并不必然优于经过筛选的上下文;
- 窗口截断:当仓库代码超过上下文窗口时,简单截断可能恰好删除关键依赖。
因此,长代码压缩的目标不是机械地减少 token,而是回答两个问题:哪些函数与当前指令真正相关?一个相关函数内部又应该保留哪些连续代码块?
1.2 Why Similarity-based RAG Is Not Enough
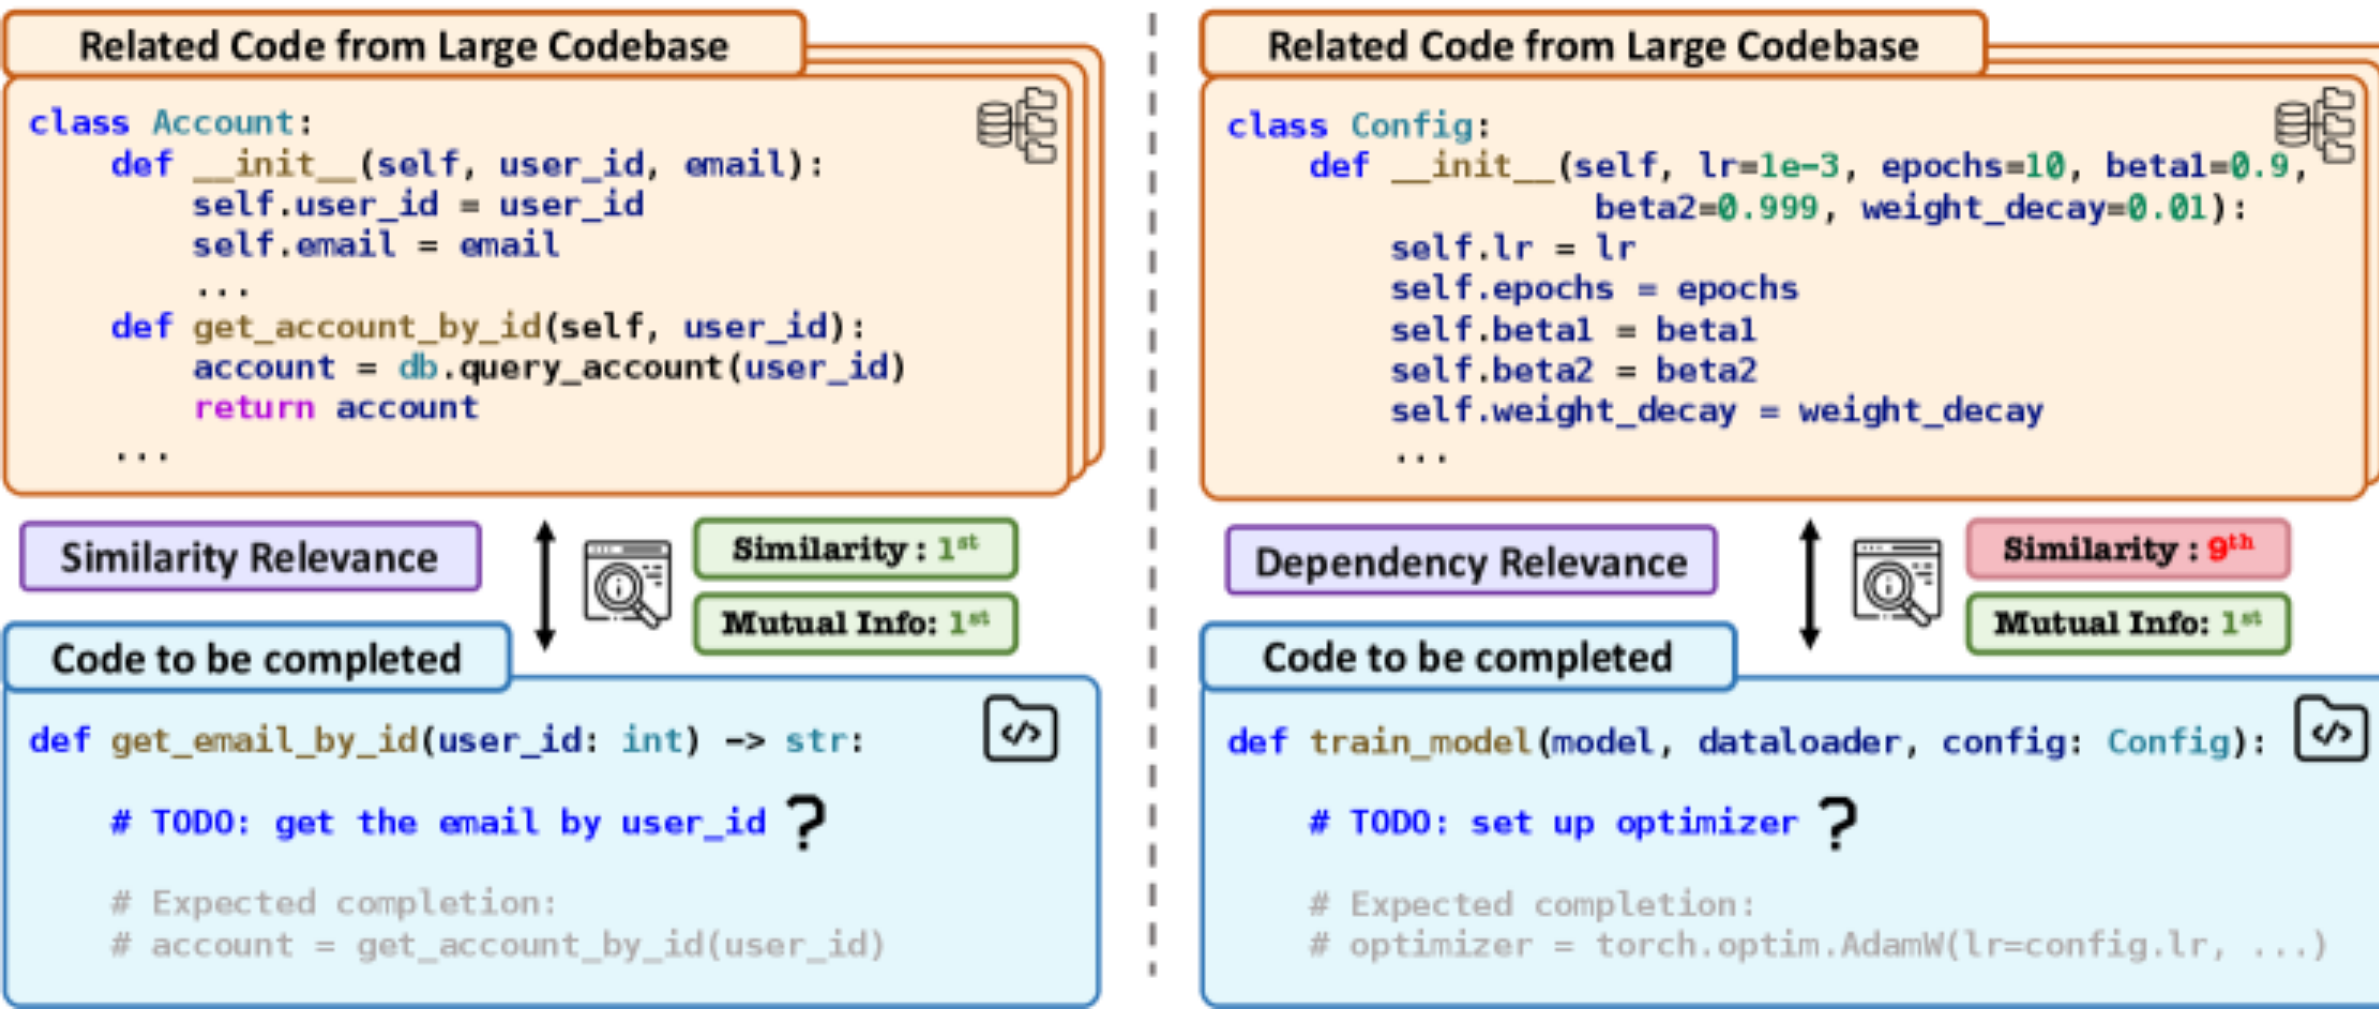
上图给出了论文的核心动机。对于 get_email_by_id 之类的局部补全,目标代码与 get_account_by_id 在函数名和词汇上高度相似,向量检索很容易找对参考函数。但在 train_model 的例子中,真正需要的是负责配置学习率、训练轮数等参数的 Config 类。它与目标函数几乎没有词汇重叠,基于相似度的检索只把它排在第 9 位;基于 AMI 的任务相关性衡量则把它排到第 1 位。
这里揭示了代码检索与普通文本检索的区别:
- 词汇相似不等于功能依赖;
- 隐式依赖可能通过数据流、配置对象、继承或调用约定建立;
- 只看 query 与代码块的嵌入距离,无法直接衡量“把这段代码交给生成模型后,它是否更容易完成任务”。
另一方面,面向自然语言的 prompt compressor 通常以 token 或短句为单位删除内容,容易破坏缩进、控制流、定义—使用关系和代码块边界。因此 LongCodeZip 选择以 函数/类—代码块—代码行三级结构组织压缩。
1.3 Main Contributions
论文的主要贡献可以概括为:
- 提出面向长代码上下文的两阶段层次化压缩框架;
- 使用指令条件下的 Approximated Mutual Information(AMI),替代纯词汇或嵌入相似度进行重要性排序;
- 提出基于逐行困惑度突变的细粒度分块、自适应函数预算和 0/1 背包选择;
- 在开源与闭源代码模型、三类长代码任务上验证方法的压缩效果、迁移性和效率。
2. Problem Formulation
设长代码上下文为
$$ c=\{c_1,c_2,\ldots,c_n\}, $$用户指令为
$$ q=\{q_1,q_2,\ldots,q_m\}. $$压缩器需要在 token 预算 \(B\) 下构造子上下文 \(c'\):
$$ c'\subseteq c,\qquad \lvert c'\rvert\le B, $$并尽可能保持下游模型在任务 \(q\) 上的生成能力。困难在于:压缩器没有真实答案,也不能为每个目标模型重新训练,因此必须从语言模型对“指令可预测性”的变化中估计代码价值。
2.1 Conditional Perplexity
给定上下文 \(c\) 后,指令 \(q\) 的条件困惑度为:
$$ \operatorname{PPL}(q\mid c)= \exp\left( -\frac{1}{N}\sum_{i=1}^{N} \log P(q_i\mid q_{\lt i},c) \right). $$不提供上下文时,指令自身的困惑度为:
$$ \operatorname{PPL}(q)= \exp\left( -\frac{1}{N}\sum_{i=1}^{N} \log P(q_i\mid q_{\lt i}) \right). $$如果一段代码包含完成指令所需要的信息,那么把它放到指令前面后,模型应该更容易预测指令中的 token,即 \(\operatorname{PPL}(q\mid c)\) 更低。
2.2 Approximated Mutual Information
LongCodeZip 将代码块 \(c\) 对任务 \(q\) 的相关性定义为:
$$ \operatorname{AMI}(c,q)= \operatorname{PPL}(q)- \operatorname{PPL}(q\mid c). $$AMI 越大,说明加入该代码后,指令的困惑度下降越明显,也就越值得保留。这个度量有三个特点:
- Instruction-aware:同一段代码面对不同任务会获得不同分数;
- 超越词面相似度:只要代码能够解释指令,即使没有共同关键词也可能获得高分;
- 不依赖下游答案:评分时只需要代码和指令,适合实际推理阶段。
需要注意,论文中的 AMI 是一种定向、任务条件化的启发式量。它用“加入代码前后的指令困惑度差”近似信息增益,并不是严格意义上对称的互信息估计。
3. Overall Framework
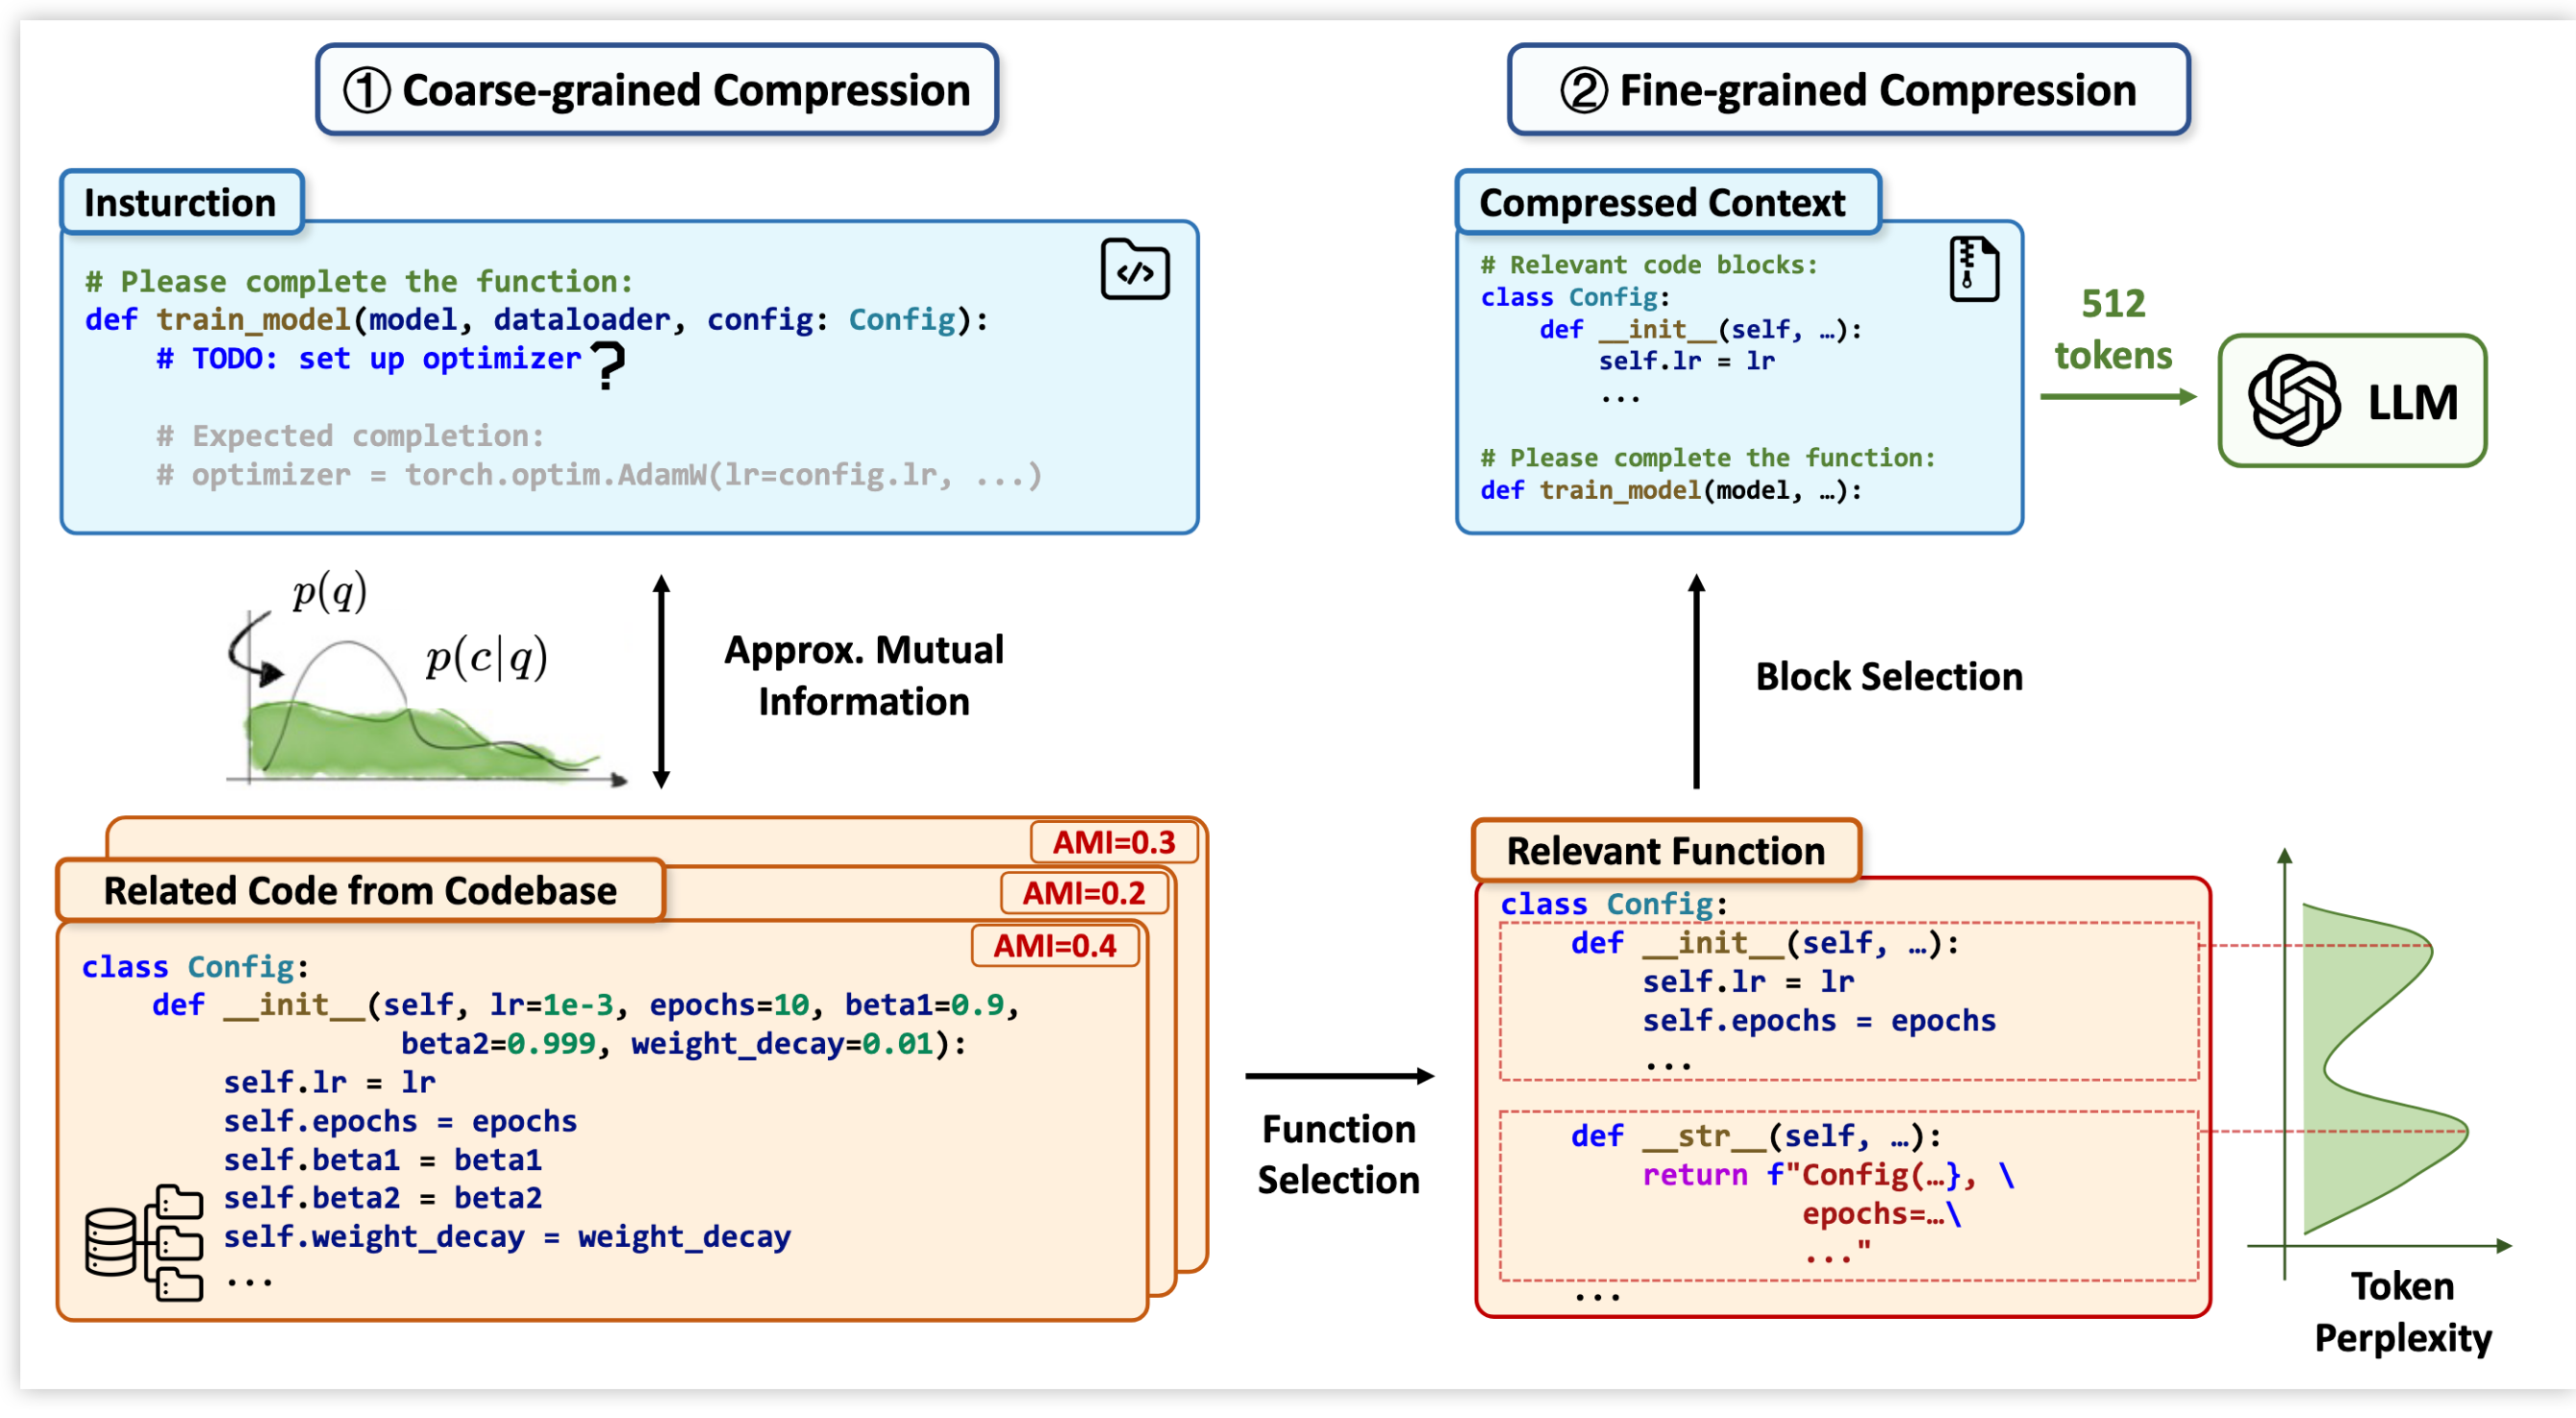
LongCodeZip 的整体流程如下:
- 使用语法解析或代码结构信息,把长上下文拆成函数、方法和类等代码实体;
- 计算每个实体相对于用户指令的 AMI;
- 按 AMI 从高到低执行函数级粗筛,未被保留的实体用占位符表示;
- 对粗筛后仍然较长的函数逐行计算困惑度,并在局部突变处切分代码块;
- 根据函数级 AMI 分配细粒度预算;
- 将块级 AMI 视为价值、token 数视为重量,用 0/1 背包选取代码块;
- 按原始顺序重组代码,得到最终压缩上下文,再交给任意目标代码模型。
两阶段设计的意义是:粗粒度阶段快速删除整个无关实体,负责主要压缩收益;细粒度阶段只处理已被判定为相关的长函数,避免把预算浪费在函数内部的样板代码、错误处理或与当前任务无关的分支上。
4. Stage I: Coarse-grained Compression
4.1 Structure-aware Entity Splitting
LongCodeZip 首先按照函数和类边界切分上下文。相比固定 token 窗口,这样做能保留:
- 完整函数签名与局部作用域;
- 类成员之间的层次关系;
- 控制流和缩进结构;
- 便于回填的原始位置。
每个实体 \(f_i\) 都计算一个 \(\operatorname{AMI}(f_i,q)\)。随后按照分数降序排列,在粗粒度预算内贪心选取实体。
4.2 Budget Coupling Between Two Stages
最终预算为 \(B\),细粒度阶段的预期保留比例为 \(R_{\mathrm{fine}}\)。为了让第二阶段压缩后恰好接近最终预算,粗粒度预算设置为:
$$ B_{\mathrm{coarse}}=\frac{B}{R_{\mathrm{fine}}}. $$例如最终只允许 2,000 token,细粒度阶段预计保留粗筛结果的 80%,那么粗粒度阶段可以先保留约 2,500 token。这样细筛有足够候选内容可比较,而不是在第一阶段过早删除潜在有用代码。
4.3 Preserving the Global Skeleton
没有入选的函数并非简单地从文本中完全消失,而是被注释或省略标记替代。这样做虽然不保留实现细节,但仍让下游模型知道:
- 原文件在这个位置存在某个实体;
- 上下文的整体顺序和层级没有被打乱;
- 入选代码之间原本可能隔着其他定义。
最终所有保留实体仍按原始顺序拼接,避免按相关性重新排序造成跨函数语义和文件结构失真。
5. Stage II: Fine-grained Compression
5.1 Perplexity-guided Block Segmentation
固定行数或固定 token 分块会把一个 if 分支、循环或异常处理从中间切断。LongCodeZip 因此把代码行作为最小原子,并观察模型逐行读取函数时的困惑度变化。
在语义连贯的代码块中,前文不断提供变量和控制流信息,后续行通常越来越容易预测,困惑度整体下降;当进入新的逻辑单元时,新变量、分支或调用会引起局部困惑度上升。论文把满足“当前行困惑度相对相邻位置形成显著局部峰值,且提升至少达到全局行困惑度标准差的 \(\alpha\) 倍”的位置视为块边界。
这种分法有两个优点:
- 不要求为不同编程语言手工定义所有语法块规则;
- 边界由代码模型感受到的语义变化决定,比等长切块更贴合实际逻辑。
对于少于 5 行的小函数,切分和筛选带来的收益有限,论文直接完整保留。
5.2 Adaptive Budget Allocation
假设小函数集合为 \(\mathcal{F}_{\mathrm{small}}\),长函数集合为 \(\mathcal{F}_{\mathrm{large}}\),函数 \(j\) 的 token 数为 \(T_j\)。先扣除必须完整保留的小函数,长函数的基础保留比例为:
$$ R_{\mathrm{base}}= \frac{ B-\sum_{j\in\mathcal{F}_{\mathrm{small}}}T_j }{ \sum_{k\in\mathcal{F}_{\mathrm{large}}}T_k }. $$如果所有长函数都使用同一比例,会让高相关函数与边缘函数获得相同待遇。LongCodeZip 将函数级 AMI 归一化为 \(\operatorname{AMI}_{\mathrm{norm},i}\in[0,1]\),再引入偏置系数 \(\beta\):
$$ R_{\mathrm{biased},i}= R_{\mathrm{base}} \left[ 1+\beta\left(2\operatorname{AMI}_{\mathrm{norm},i}-1\right) \right]. $$高 AMI 函数的保留比例被上调,低 AMI 函数则下调。各比例先截断到 \([0,1]\),再进行全局缩放以满足总预算:
$$ R_i= R_{\mathrm{biased},i} \frac{ B_{\mathrm{large}} }{ \sum_jR_{\mathrm{biased},j}T_j }. $$最终函数 \(i\) 的预算约为 \(B_i=R_iT_i\)。这一步把“重要函数多保留、次要函数少保留”从直觉转化为可控的预算分配。
5.3 Code Block Selection as 0/1 Knapsack
一个函数被切成 \(M\) 个候选块后,LongCodeZip 计算每块相对于指令的 AMI,并将其归一化为价值 \(v_j\),token 数记为重量 \(T_j\)。选择问题写成:
$$ \max_{z_1,\ldots,z_M} \sum_{j=1}^{M}z_jv_j, $$$$ \text{subject to}\qquad \sum_{j=1}^{M}z_jT_j\le B_i, \qquad z_j\in\{0,1\}. $$这正是 0/1 背包:每个完整代码块只能保留或删除,不能像 token compressor 那样从中间切碎。动态规划能够在预算内找到总 AMI 最大的块集合,而简单按 \(v_j/T_j\) 贪心并不保证最优。
框架还允许用户指定必须保留的块集合 \(\mathcal{P}\)。这些块先无条件加入,剩余预算为:
$$ B_{\mathrm{remain}}= \max\left( 0, B_i-\sum_{j\in\mathcal{P}}T_j \right), $$背包算法只在剩余候选中运行。这为保留函数签名、安全检查、接口约束或用户关注区域提供了硬保证。
6. End-to-end Algorithm
把整个方法压缩成一条执行链,可以写成:
Input: long code context c, instruction q, final budget B

1. Parse c into functions/classes F.
2. Score every entity f in F with AMI(f, q).
3. Rank entities and keep them under B_coarse = B / R_fine.
4. Preserve placeholders for removed entities and the original order.
5. For each retained function:
   a. keep it directly if it has fewer than 5 lines;
   b. otherwise, locate block boundaries from line-PPL peaks;
   c. compute block-level AMI;
   d. assign a function budget according to normalized function AMI;
   e. solve a 0/1 knapsack to select whole blocks.
6. Reassemble selected blocks in their original positions.
Output: compressed context c' with |c'| <= B.
压缩器与最终生成模型是解耦的:评分可以使用较小的开源代码模型,压缩结果则可以交给更大的开源模型或 GPT-4o、Claude 等闭源 API。
7. Experimental Setup
7.1 Benchmarks
| Task | Samples | Avg. Context Tokens | Avg. Ground-truth Tokens | Languages |
|---|---|---|---|---|
| Long Code Completion | 500 | 9,328.2 | 12.4 | Python |
| Long Module Summarization | 139 | 10,809.6 | 1,758.1 | Python |
| RepoQA | 600 | 11,524.6 | 156.0 | Python, Java, JavaScript, Rust, Go, C++ |
- Long Code Completion:从长文件中预测被隐藏的目标代码,过滤后每个样本上下文超过 5,000 token;
- Long Module Summarization:根据完整长模块生成模块级总结,原始数据来自 216 个样本、43 个仓库,实验保留上下文超过 2,000 token 的 139 个样本;
- RepoQA:根据自然语言描述在仓库上下文中定位目标函数,共覆盖 60 个仓库和 6 种语言。
7.2 Models and Baselines
开源目标模型包括:
- DeepSeek-Coder-6.7B;
- Qwen2.5-Coder-7B;
- Seed-Coder-8B。
闭源模型包括 GPT-4o 与 Claude-3.7-Sonnet。基线覆盖五类方法:
- No Compression / No Context:完整输入和完全不输入代码;
- Random Token / Random Line:随机删除 token 或代码行;
- RAG:滑动窗口检索、函数级检索,编码器为 UniXCoder-base;
- Code-specific Compression:DietCode、SlimCode;
- General Prompt Compression:LLMLingua、LongLLMLingua、LLMLingua-2;
- Advanced Code RAG:A3-CodGen、cAST、RepoGenix、RLCoder。
7.3 Metrics
- Compression Ratio:原始 token 数除以压缩后 token 数,因此数值越大表示压缩越强;
- Completion:Edit Similarity(ES)与 Exact Match(EM);
- Summarization:使用 GPT-4o-mini 比较压缩上下文总结 \(\hat{s}\) 与完整上下文总结 \(s_o\),交换候选顺序执行两次判断,以减轻位置偏差:
- RepoQA:生成函数与目标函数的 BLEU 高于 0.8 时判为正确。
7.4 Hyperparameters and Hardware
| Task | Final Budget \(B\) | \(R_{\mathrm{fine}}\) | \(\beta\) |
|---|---|---|---|
| Code Completion | 2K | 0.8 | 0.5 |
| Module Summarization | 5K | 0.3 | 0.5 |
| RepoQA | 2K | 1.0 | — |
RepoQA 设置 \(R_{\mathrm{fine}}=1.0\),即保留检索到的完整函数,只使用粗粒度选择。实验运行在 Intel Xeon Gold 6254 CPU 和 NVIDIA A100 80GB GPU 上。
8. Main Results
8.1 Long Code Completion
| Model | Method | ES | EM | Ratio |
|---|---|---|---|---|
| DeepSeek-Coder-6.7B | No Compression | 57.14 | 34.40 | 1.0× |
| DeepSeek-Coder-6.7B | LongCodeZip | 60.58 | 35.40 | 5.3× |
| Qwen2.5-Coder-7B | No Compression | 56.36 | 31.80 | 1.0× |
| Qwen2.5-Coder-7B | RAG Function | 52.79 | 26.00 | 3.1× |
| Qwen2.5-Coder-7B | LongCodeZip | 57.55 | 32.40 | 4.3× |
| Seed-Coder-8B | No Compression | 64.04 | 40.20 | 1.0× |
| Seed-Coder-8B | LongCodeZip | 63.11 | 37.40 | 5.6× |
LongCodeZip 在 DeepSeek 与 Qwen 上压缩后反而超过完整上下文,说明删除无关代码能够缓解注意力稀释。Seed-Coder 上存在小幅下降,但在 5.6× 压缩率下仍保持接近完整上下文的表现。相比函数级 RAG,LongCodeZip 在 Qwen 上同时获得更高压缩率和更高 ES/EM,表明 AMI 与函数内筛选都在发挥作用。
8.2 Long Module Summarization
| Model | No Compression | LongCodeZip | Ratio |
|---|---|---|---|
| DeepSeek-Coder-6.7B | 19.09 | 28.01 | 2.5× |
| Qwen2.5-Coder-7B | 56.00 | 56.47 | 1.7× |
| Seed-Coder-8B | 44.95 | 55.07 | 3.5× |
三个模型的 CompScore 都没有因压缩下降。尤其是 DeepSeek 与 Seed-Coder,压缩上下文的总结明显优于完整上下文。这说明模块总结不需要逐字保留所有实现细节;突出核心接口与主路径,反而更利于模型概括模块职责。
8.3 RepoQA
| Model | No Compression Avg. | LongCodeZip Avg. | Ratio |
|---|---|---|---|
| DeepSeek-Coder-6.7B | 38.3 | 75.3 | 5.3× |
| Qwen2.5-Coder-7B | 86.0 | 87.2 | 4.5× |
| Seed-Coder-8B | 69.0 | 80.7 | 5.3× |
RepoQA 的提升最明显。因为任务要求根据描述定位一个目标函数,完整仓库上下文中的干扰函数很多;AMI 粗筛能把与描述最相关、但不一定词面相似的函数集中到有限窗口中。DeepSeek 的平均正确率从 38.3 提升到 75.3,几乎翻倍。
8.4 Closed-source Models
| Task | Model | No Compression | LongCodeZip | Ratio |
|---|---|---|---|---|
| Completion ES / EM | Claude-3.7-Sonnet | 66.24 / 41.20 | 66.27 / 40.20 | 4.3× |
| Completion ES / EM | GPT-4o | 65.13 / 40.80 | 64.72 / 38.80 | 4.3× |
| Summarization | Claude-3.7-Sonnet | 60.72 | 61.47 | 1.7× |
| Summarization | GPT-4o | 58.42 | 59.04 | 1.7× |
| RepoQA | Claude-3.7-Sonnet | 89.7 | 88.9 | 5.1× |
| RepoQA | GPT-4o | 87.8 | 88.9 | 5.1× |
总体上,LongCodeZip 对闭源模型也能直接迁移。需要指出,论文正文在讨论 Claude RepoQA 时写成 90.7,但 Table V 中 LongCodeZip 的数值是 88.9;这里采用表格中的结果,并将正文数值视为可能的笔误。
8.5 Comparison with Advanced RAG
在 Seed-Coder 补全任务中,LongCodeZip 达到 63.11 ES / 37.40 EM / 5.6×,而 RepoGenix 为 60.28 / 34.70 / 3.5×。在 Claude 上,LongCodeZip 为 66.27 / 40.20 / 4.3×,RLCoder 为 62.76 / 37.90 / 4.0×。
这组结果说明,高级 RAG 即使引入 AST 或仓库结构,仍主要解决“选择哪些候选片段”;LongCodeZip 进一步在候选函数内部做任务感知压缩,因此能在更短上下文中保留更密集的有效信息。
9. Ablation Study
论文在 Qwen2.5-Coder-7B 的长代码补全任务上逐项替换或移除组件:
| Variant | ES | EM | ES Drop |
|---|---|---|---|
| Full LongCodeZip | 57.55 | 32.40 | — |
| Similarity Ranking | 49.66 | 25.20 | -7.89 |
| Random Ranking | 39.76 | 11.50 | -17.79 |
| Without Fine-grained Stage | 56.10 | 31.20 | -1.45 |
| Without Adaptive Allocation | 55.21 | 29.40 | -2.34 |
| Fixed Line Chunking | 55.98 | 31.20 | -1.57 |
| Random Line Selection | 55.07 | 29.00 | -2.48 |
可以得到四个清晰结论:
- AMI 粗粒度排序是最关键组件。改成相似度排序损失 7.89 ES,随机排序损失 17.79 ES;
- 细粒度阶段提供稳定增益。完全移除后下降 1.45 ES,说明粗筛已经很强,但函数内部仍存在冗余;
- 预算必须按任务相关性分配。统一比例压缩会浪费高价值函数的预算;
- 语义块优于随机行或固定行块。保持完整逻辑单元能减少结构破坏。
10. Transferability and Efficiency
10.1 Small Compressor, Large Target Model
论文比较了不同规模的压缩器。使用 0.5B 模型计算相关性时,平均 ES 为 60.13;使用 7B 压缩器时为 60.58,差距很小。这说明 AMI 排序不要求压缩器与目标模型同等规模,可以采用“小模型负责压缩、大模型负责生成”的部署方式。
10.2 Runtime and GPU Memory
| Method | Compression Time | Compression Memory | Generation Time | Generation Extra Memory | Ratio | ES |
|---|---|---|---|---|---|---|
| No Compression | — | — | 15.70 s | 3.48 GB | 1.0× | 56.36 |
| RAG Function | 0.53 s | 1.07 GB | 7.57 s | 1.13 GB | 3.1× | 52.79 |
| LongCodeZip | 2.58 s | 0.69 GB | 6.59 s | 0.81 GB | 4.3× | 57.55 |
LongCodeZip 将输入 token 减少约 77%,生成时间从 15.70 秒下降到 6.59 秒,生成阶段缩短约 58%。若把 2.58 秒压缩开销也算入端到端时间,总时间为 9.17 秒,仍比 15.70 秒低约 41.6%。
论文报告的显存是模型基础参数之外的额外占用,基础模型参数本身约占 28.37 GB。压缩过程比普通 RAG 慢,但换来了更高任务性能、更强压缩率,以及更低的生成阶段显存。对于按 token 收费的闭源 API,2.58 秒的本地预处理通常也比长期支付冗余输入费用更划算。
11. Compression–Performance Trade-off
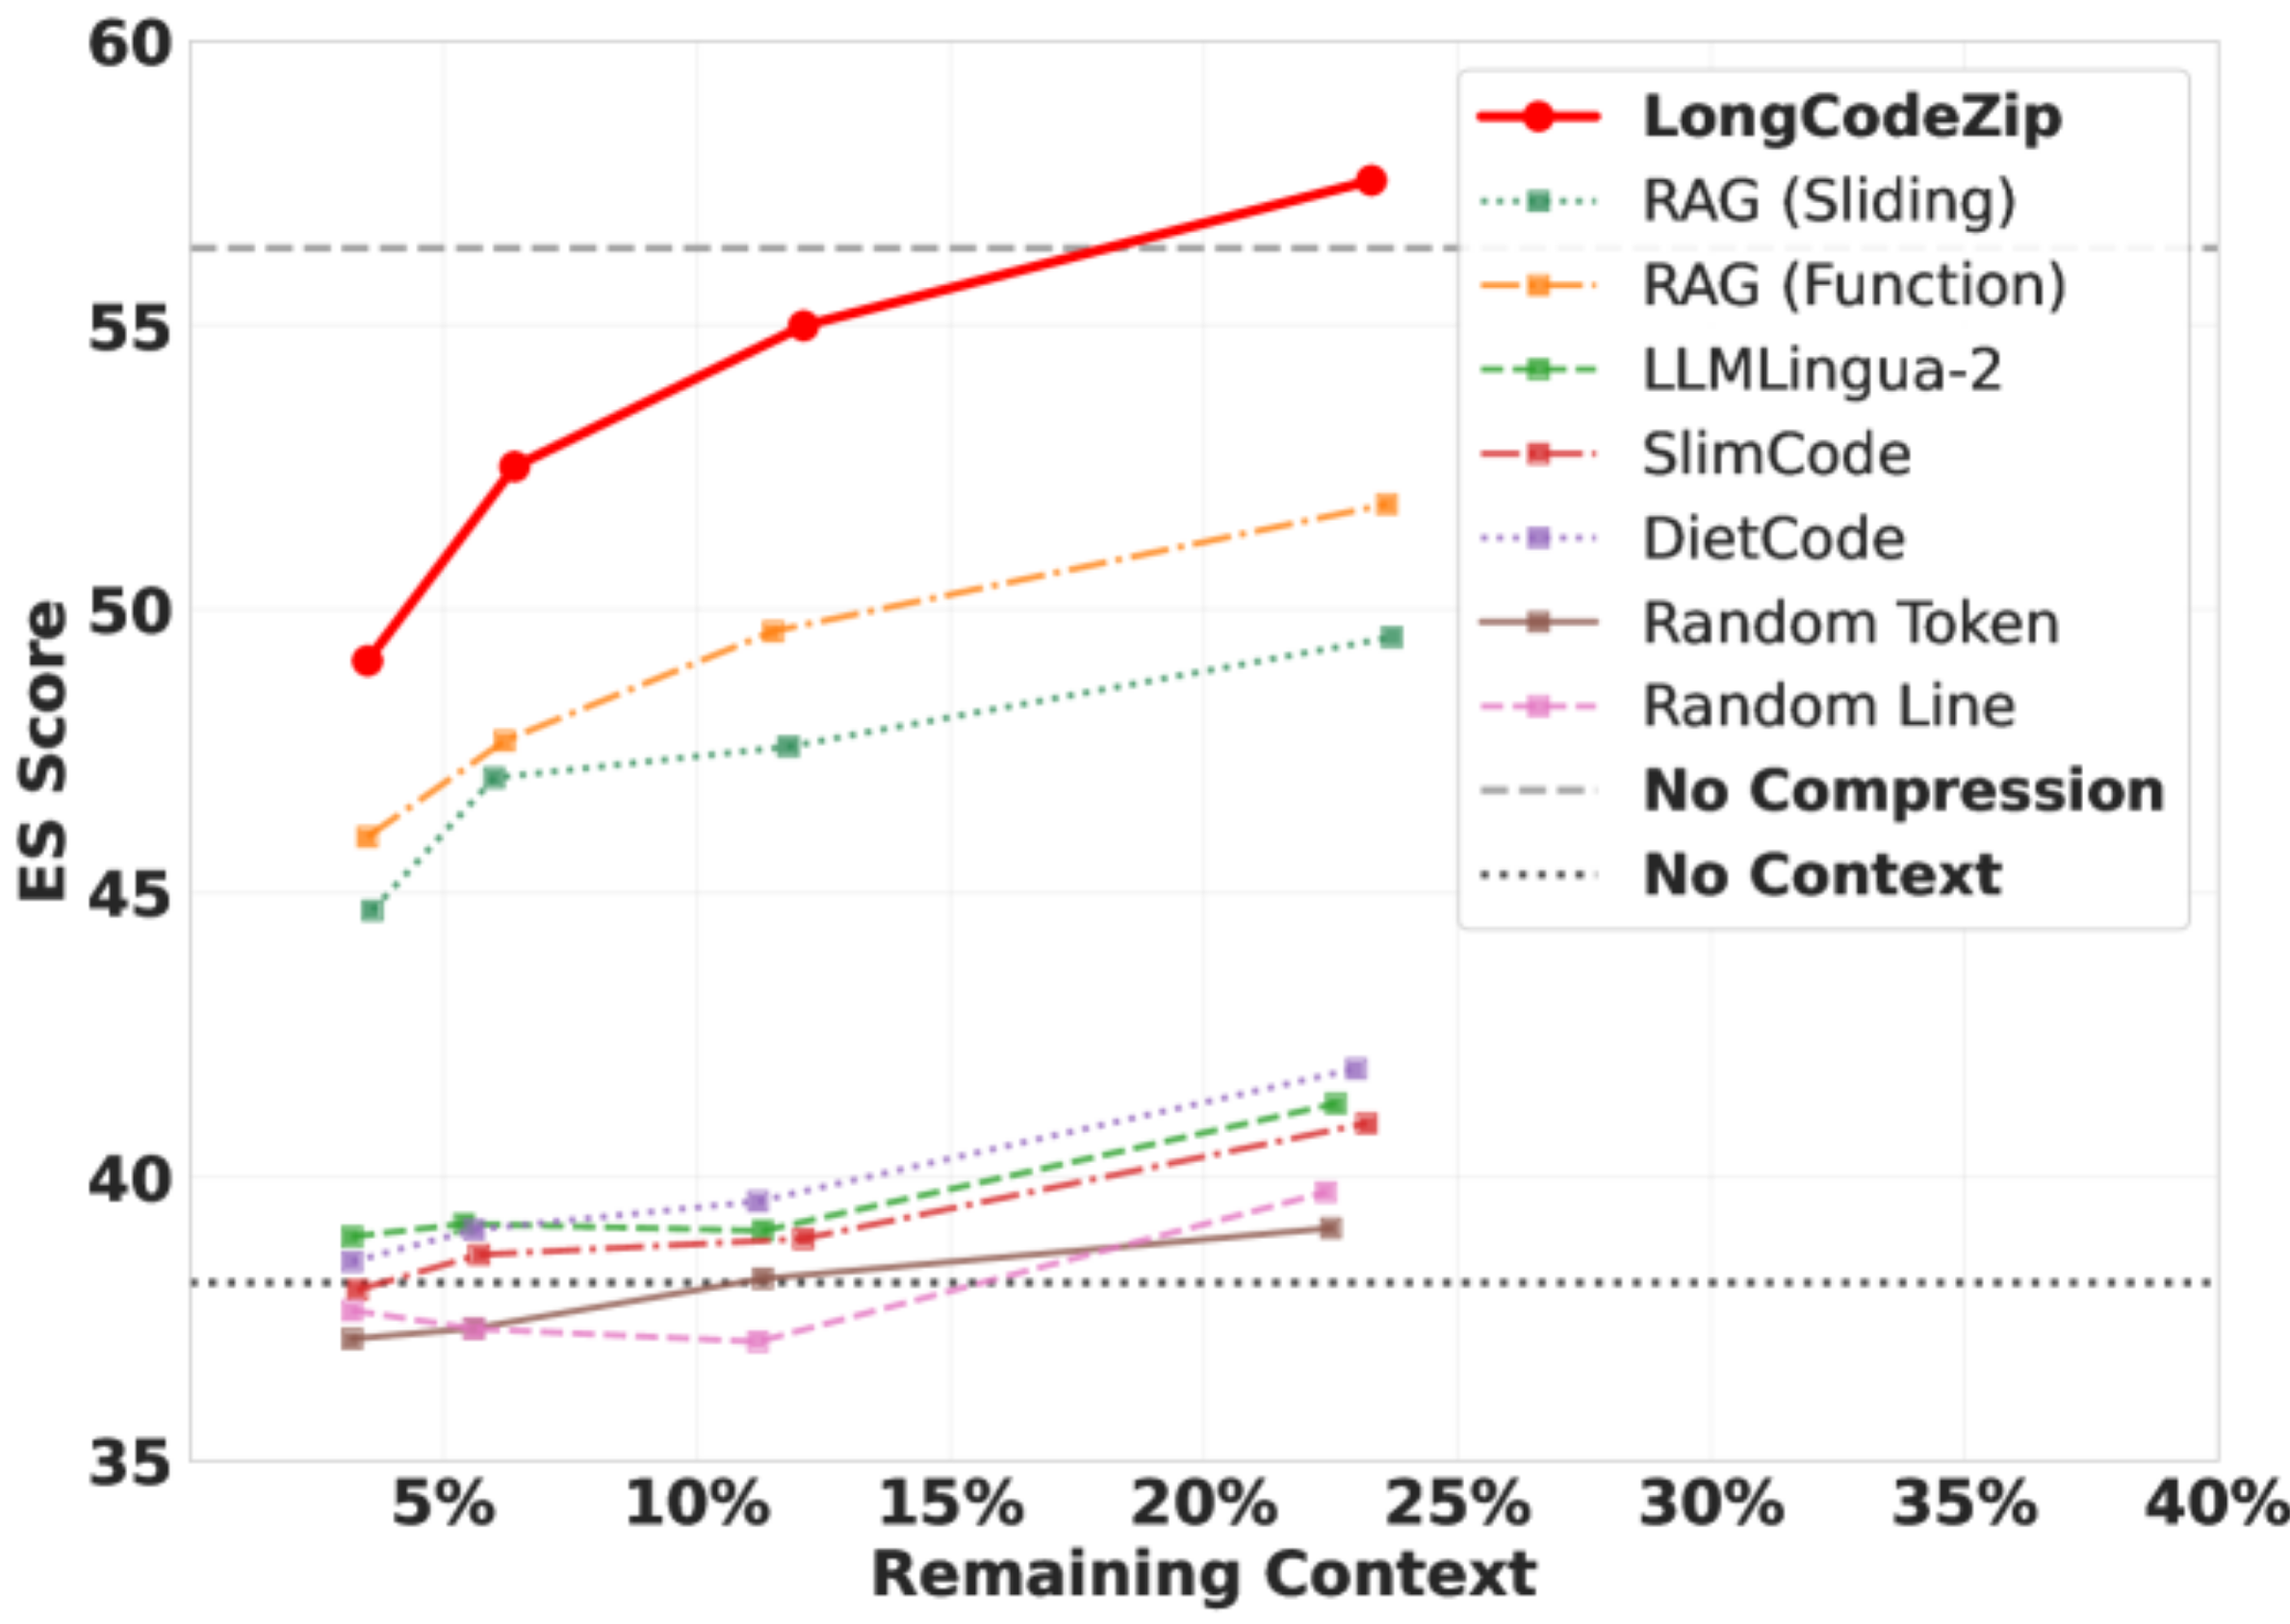
随着保留比例降低,大多数方法都会逐渐退化,但 LongCodeZip 在极端压缩区域的优势更加明显,尤其是在只保留原上下文不到 10% 时。原因是它并非均匀缩短每个函数,而是先跨函数集中预算,再在关键函数内部集中预算。
这一现象也说明,评估压缩器不能只比较某一个固定 token 预算。更公平的比较应同时观察完整的 performance–compression curve:如果一种方法只在宽松预算下有效,而预算稍紧就快速崩溃,就很难适用于真正超出上下文窗口的仓库。
12. Case Study
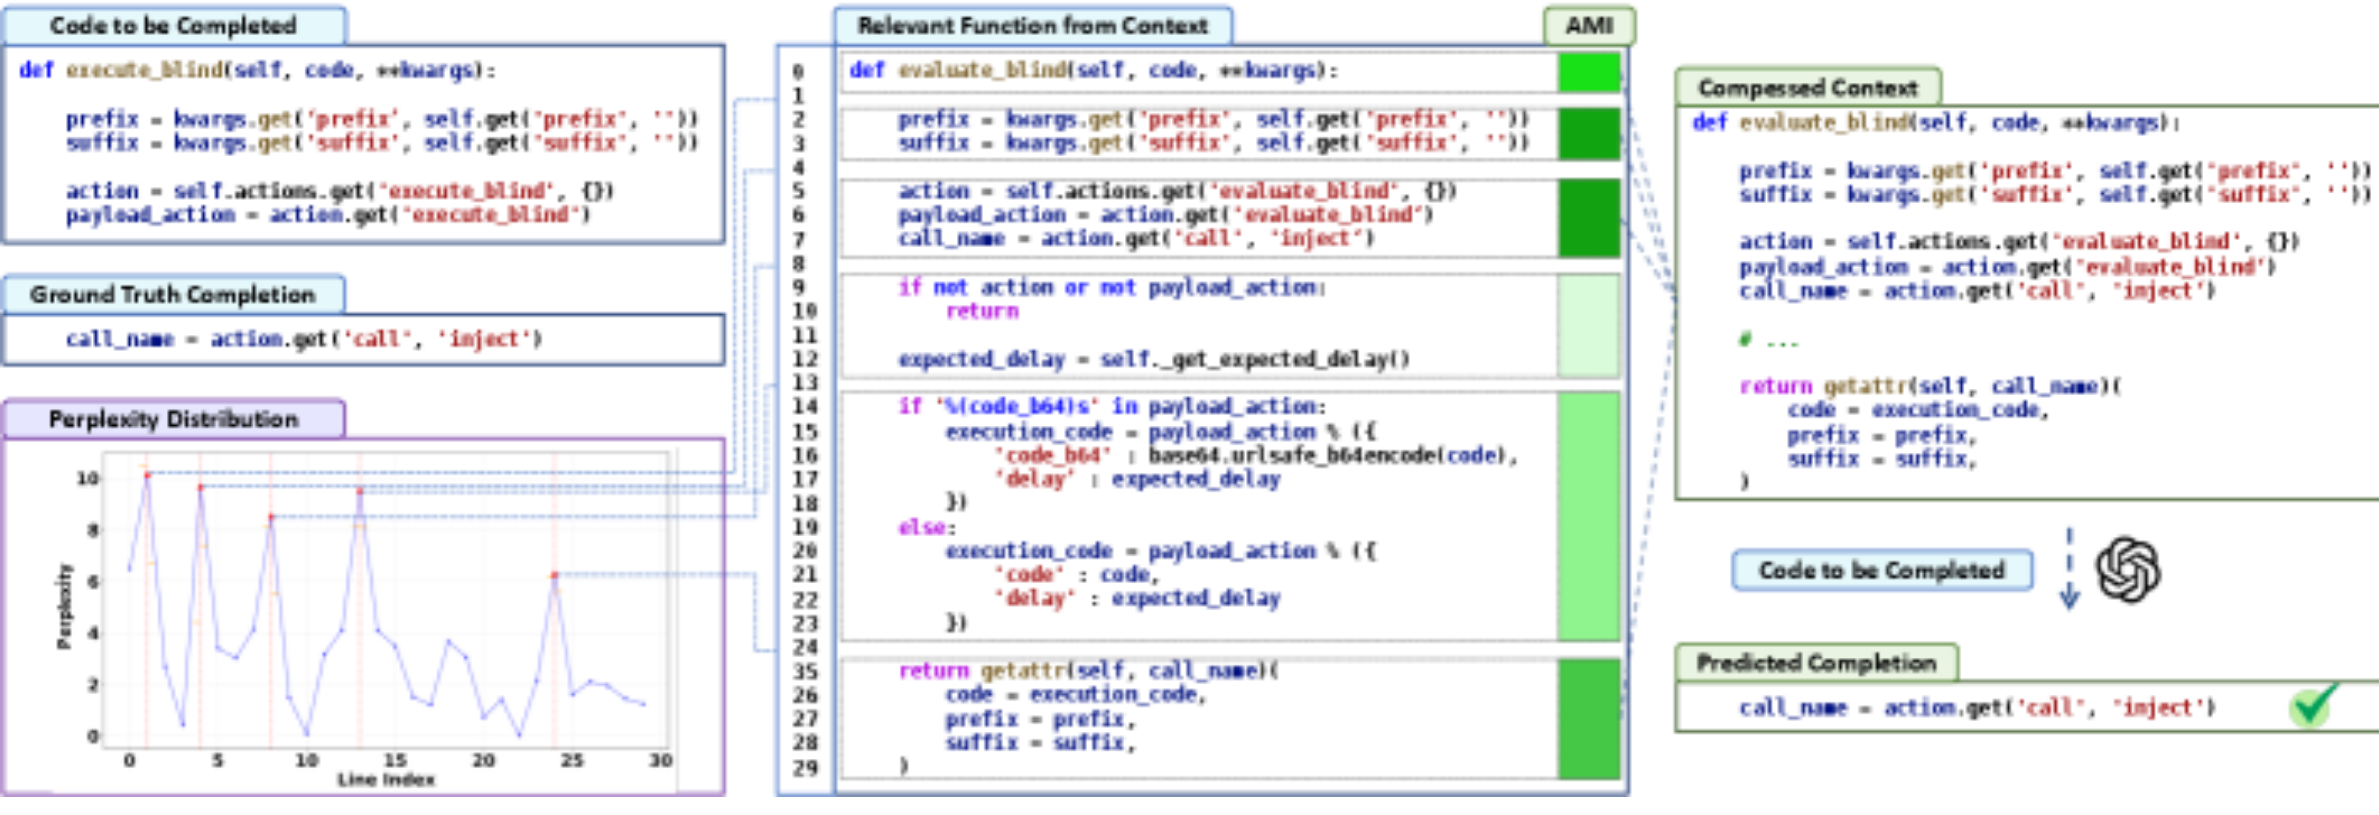
细粒度案例展示了 LongCodeZip 如何删除一个函数中的非关键行,同时保留与任务相关的初始化、核心计算和返回路径。与随机行删除相比,它尽量让保留区域对应连续的逻辑块,而不是留下语法正确但语义残缺的碎片。
案例也体现了两类评分的分工:
- 函数级 AMI 回答“这个函数是否值得进入候选集”;
- 块级 AMI 回答“在已经相关的函数里,哪部分最能解释当前指令”。
如果只做第一层,长函数会整体占用大量预算;如果只做第二层,则需要为仓库中的每个函数执行昂贵的逐行分析。层次化处理因此同时控制了压缩质量和计算成本。
13. Limitations and Threats to Validity
13.1 Failure Cases
论文总结了两类主要失败场景:
- 上下文本身不包含答案:压缩器只能筛选已有信息,无法补回仓库中缺失的依赖;
- 指令含糊或与代码难以对齐:AMI 依赖指令条件化评分,如果任务描述过于宽泛,重要性排序也会不稳定。
此外,AMI 计算需要额外的语言模型前向过程,细粒度逐行困惑度与块级背包也带来预处理开销。因此论文建议:高价闭源模型或极长上下文采用完整两阶段流程;便宜模型、延迟极敏感或预算较宽松时,可以只启用粗粒度阶段。
13.2 Evaluation Threats
- LLM-as-a-Judge 偏差:模块总结使用 GPT-4o-mini 比较结果,论文通过交换候选顺序并取组合分数降低位置偏差,但不能完全消除模型偏好;
- 任务覆盖范围:虽然包括补全、总结、问答和 6 种语言,但仍不能代表所有仓库级软件工程任务;
- 模型覆盖范围:实验模型以 6.7B–8B 开源模型及两个闭源模型为主,更大或更新架构上的效果仍需验证;
- 数据泄漏风险:论文使用训练时间较早的 DeepSeek-Coder,并选择时间更晚的基准来降低泄漏可能,但闭源模型的训练数据不可知;
- 代理相关性偏差:AMI 衡量的是代码对“预测指令”的帮助,不是对“生成正确答案”的直接贡献,两者高度相关但并不等价。
14. Practical Deployment
官方仓库提供了 LongCodeZipCompressor 接口,典型调用方式如下:
from longcodezip import LongCodeZipCompressor

compressor = LongCodeZipCompressor(
    model_name="your-compressor-model",
    device="cuda",
)

compressed_code = compressor.compress(
    code=long_code_context,
    instruction=user_instruction,
    target_token=2000,
)
在实际系统中,可以按以下方式接入:
- 在 Agent 的文件搜索、仓库索引之后执行 LongCodeZip,而不是替代所有检索;
- 对安全检查、接口定义、用户明确指定的行设置强制保留;
- 根据任务调整预算:补全需要精确局部实现,总结需要覆盖更多模块结构,RepoQA 则优先保留完整候选函数;
- 缓存函数级 AMI 或代码解析结果,避免多轮 Agent 反复处理未变化文件;
- 同时记录压缩耗时和生成耗时,不要只报告生成阶段加速;
- 在进入目标模型前执行语法解析、名称引用或最小编译检查,及时发现压缩造成的结构缺口。
15. Conclusion
LongCodeZip 的核心并不是“把代码变短”,而是把有限上下文预算分配给最能帮助当前任务的代码结构。它用 AMI 替代单纯相似度,用函数级选择解决跨实体冗余,再用困惑度分块、自适应预算和 0/1 背包解决实体内部冗余。
实验表明,这套无训练、模型无关的流程在 1.7×–5.6× 的压缩范围内能够保持或改善补全、总结与仓库问答效果。消融实验进一步说明,函数级 AMI 排序贡献最大,细粒度阶段则在严格预算下提供额外收益。对于长上下文 Coding Agent,LongCodeZip 展示了一条实用路线:先用轻量模型完成任务感知的信息筛选,再让昂贵的大模型只处理高密度、结构完整的代码证据。