SWE-Pruner: Self-Adaptive Context Pruning for Coding Agents
Status: arXiv v4, 2026-05-07
Paper: https://arxiv.org/abs/2601.16746
Github: https://github.com/Ayanami1314/swe-pruner
Abstract
Coding Agent 在解决真实软件工程任务时,需要反复读取仓库中的文件、搜索符号、运行测试并修改代码。随着交互轮数增加,大量文件内容会进入并持续保留在上下文中,其中只有少部分代码与 Agent 当前的推理目标直接相关。这种由冗余观察引起的上下文瓶颈被论文称为 Context Wall。
SWE-Pruner 是一个部署在 Coding Agent 与环境之间的轻量级上下文剪枝框架。Agent 在调用 grep、cat 等文件读取工具时,可以额外提供一个描述当前信息需求的 Goal Hint。SWE-Pruner 使用一个基于 Qwen3-Reranker-0.6B 的 neural skimmer,根据 Goal Hint 对原始代码进行相关性打分,并以代码行为单位保留与当前任务相关的内容。
与 token-level prompt compression 不同,SWE-Pruner 不会删除任意 subword token,而是执行 task-aware line-level pruning。同时,模型使用 CRF 对相邻保留决策进行结构化建模,以减少碎片化剪枝对代码语法和局部逻辑的破坏。
实验结果表明:
- 在 SWE-Bench Verified 上,SWE-Pruner 将 token 消耗降低 23.1%–38.3%,同时将成功率提升 1.2–1.4 个百分点;
- 在 SWE-QA 上,不同仓库和 backbone 下获得 8.9%–54.4% 的 token 降低;
- 在 Long Code QA 上,最高达到 14.84× 有效压缩率;
- 0.6B skimmer 在 8K 输入下的首 token 延迟约为 102 ms。
1. Introduction
现代 Coding Agent 通常遵循以下交互流程:
$$ \text{Reasoning} \rightarrow \text{Tool Call} \rightarrow \text{Observation} \rightarrow \text{Reasoning} \rightarrow\cdots $$在软件工程任务中,Observation 通常来自代码仓库,例如文件内容、目录结构、搜索结果、测试日志和异常堆栈。单次读取可能返回数百甚至数千行代码,而这些内容会在后续轮次中继续占用 prompt。
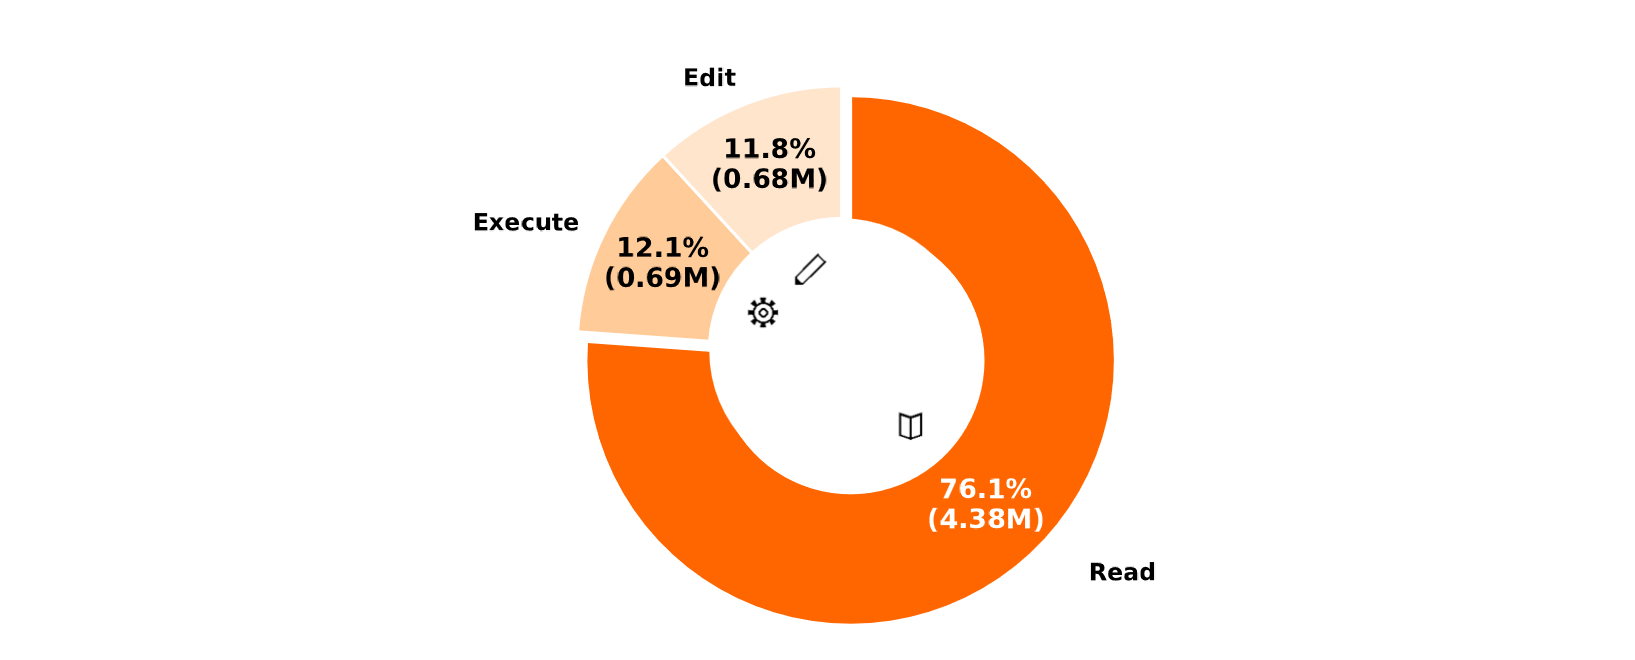
作者统计了 Claude Sonnet 4.5 + Mini-SWE-Agent 在 SWE-Bench Verified 上的 token 开销:
- Read:76.1%(4.38M);
- Execute:12.1%(0.69M);
- Edit:11.8%(0.68M)。
在 GLM-4.6 上也观察到相同趋势:Read 占 67.5%,Execute 占 14.0%,Edit 占 18.5%。因此,Coding Agent 的主要 token 成本并不来自代码修改,而是来自仓库探索和文件读取。
这一问题会在多轮交互中进一步放大:
- Agent 在任务初期需要粗粒度探索多个文件;
- 文件工具通常返回完整文件或大段代码;
- 早期读取结果会累积在后续上下文中;
- 无关代码会增加推理噪声,并可能引起重复搜索和重复读取。
现有上下文压缩方法并不完全适合 Coding Agent:
- Token-level pruning 可能删除缩进、括号或标识符的一部分,从而破坏代码语法;
- Embedding-based RAG 通常以 chunk 或函数为单位检索,可能遗漏细粒度实现;
- LLM summarization 会引入额外生成延迟,并可能丢失变量名、异常信息和精确逻辑;
- 结构化代码压缩 可以保护 AST,但通常使用固定规则,无法适应 Agent 在不同任务阶段的信息需求;
- Agent history compression 处理的是历史轨迹,而 SWE-Pruner 处理的是环境刚刚返回的代码观察,两者作用位置不同。
针对上述问题,SWE-Pruner 采用三个核心设计:
- 使用 Goal Hint 显式描述 Agent 当前的信息需求;
- 使用轻量模型执行 query-aware 相关性打分;
- 以代码行为剪枝单位,并使用 CRF 保持相邻决策的连贯性。
从上下文管理的位置看,SWE-Pruner 与 history compression 并不冲突。前者压缩的是本轮工具刚返回的环境观察,后者压缩的是已经进入轨迹的历史消息。如果把 Agent 的上下文写成:
$$ C_t=\{H_{\lt t}, O_t\}, $$其中 \(H_{\lt t}\) 是此前的交互历史,\(O_t\) 是本轮文件读取结果,那么 SWE-Pruner 作用于 \(O_t\),在冗余内容进入 \(H_{\lt t}\) 之前就完成过滤。这是它能够同时降低当前轮 prompt 和后续累积成本的原因。
论文的贡献可以进一步概括为:
- 将 Coding Agent 的文件读取建模为随推理目标变化的自适应剪枝问题,而不是使用固定压缩率;
- 设计 0.6B 的 dual-head neural skimmer,在一次前向中同时输出局部 retain/prune 决策和文档级相关性;
- 用 61K 合成样本提供细粒度监督,并覆盖九类真实 Agent 信息需求;
- 在多轮修复、仓库问答、长代码补全和长代码问答四类任务上验证效果,同时报告语法完整性、延迟、成本和行为轨迹。
2. SWE-Pruner Method
2.1 Overall Framework
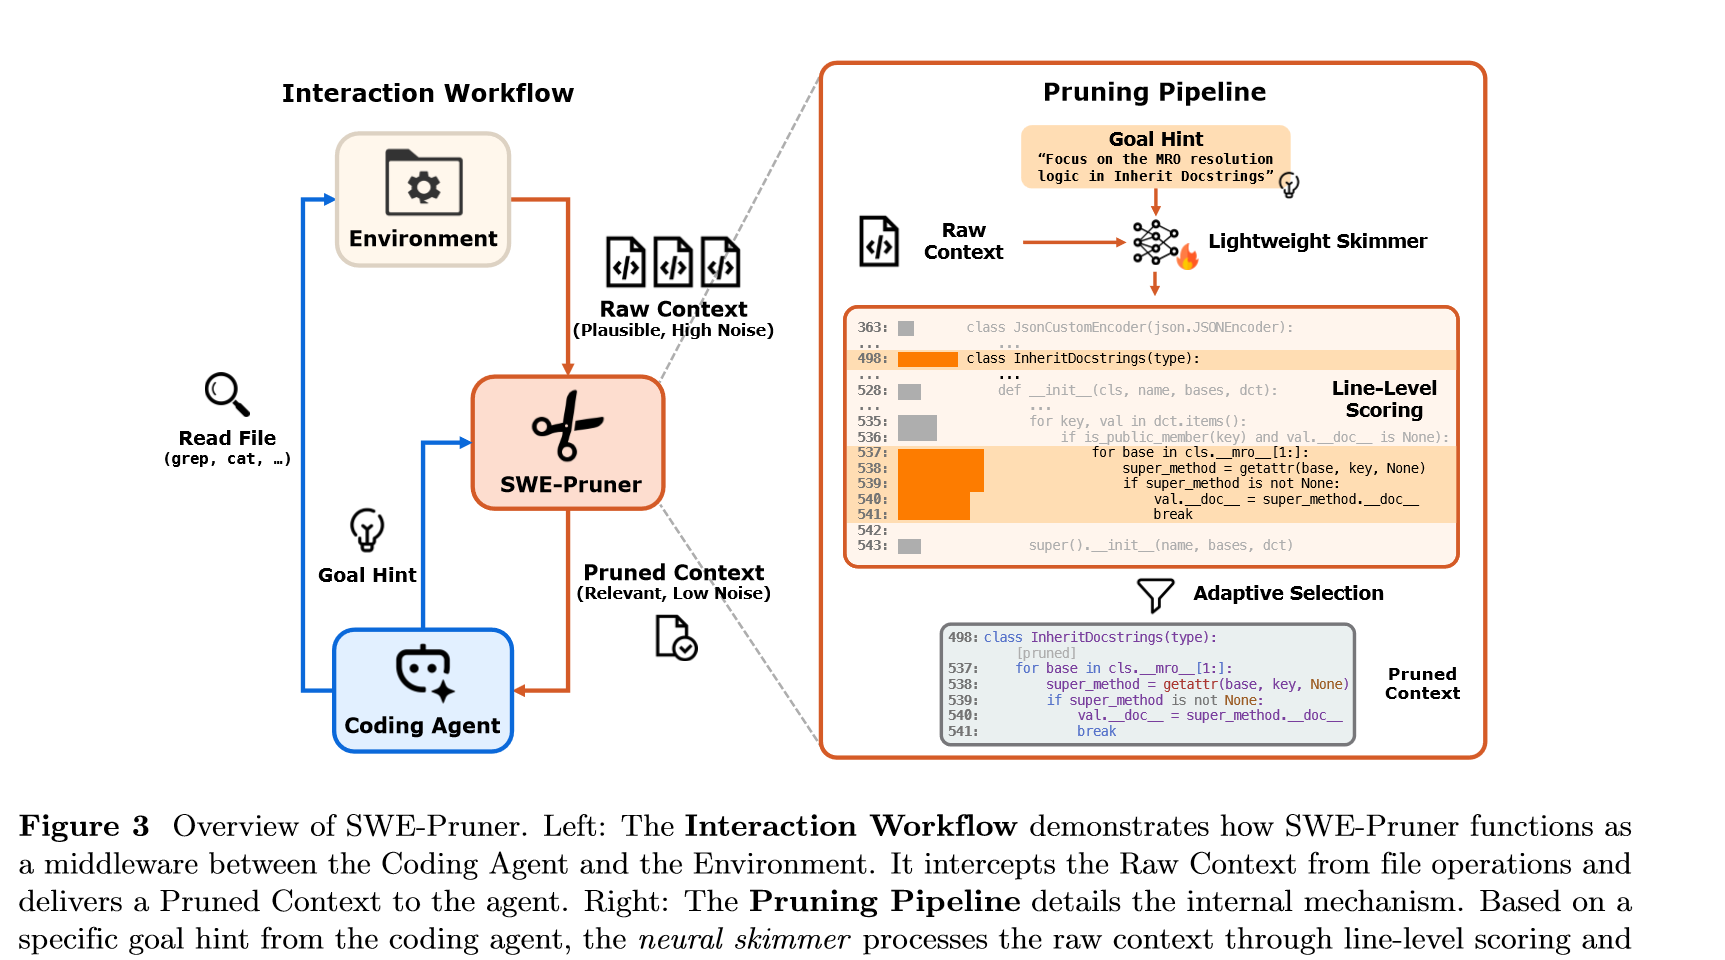
SWE-Pruner 作为 middleware 部署在 Coding Agent 与环境之间。整体流程如下:
- Coding Agent 调用
grep、cat等文件工具; - 环境返回包含大量候选代码的 Raw Context;
- Agent 同时提供描述当前信息需求的 Goal Hint;
- neural skimmer 根据 Goal Hint 对 Raw Context 进行行级打分;
- 只保留分数较高的代码行,并将 Pruned Context 返回 Agent。
SWE-Pruner 不需要改变 Agent 的主要推理流程,只需给文件工具增加一个可选参数 context_focus_question:
raw_context = grep(file_path, pattern)

if context_focus_question:
    return pruner(raw_context, context_focus_question)

return raw_context
当 context_focus_question 为空时,系统直接返回完整工具输出。这一设计保证了向后兼容性,也允许 Agent 在两种模式之间切换:
- 任务初期进行广泛探索时,不启用剪枝;
- 已经形成具体假设后,使用 Goal Hint 进行聚焦读取。
2.2 Goal Hint Generation
Goal Hint 是一个完整、自包含的自然语言问题,用于描述 Agent 当前希望从代码中获得的信息。例如:
Focus on the MRO resolution logic in InheritDocstrings.
Goal Hint 与普通关键词搜索不同。关键词只能表示局部词面信息,而 Goal Hint 可以表达当前推理阶段的语义目标,例如:
- 某个类的认证逻辑是如何实现的;
- 某个异常由哪条调用路径触发;
- 一个新参数需要在哪些函数中传播;
- 某个测试失败与哪些状态更新有关。
对于 Long Code QA 等本身已经包含问题的单轮任务,原始问题可以直接作为初始 Goal Hint。多轮 Agent 则可以随着调查过程不断更新 Goal Hint。
2.3 Lightweight Neural Skimmer
2.3.1 Token Relevance Scoring
给定代码上下文:
$$ C=\{x_1,x_2,\ldots,x_n\}, $$以及 Goal Hint \(q\),模型首先计算每个 token 的相关性:
$$ s_i=F(q,x_i\mid C;\theta). $$其中 \(F\) 使用 Qwen3-Reranker-0.6B 作为 backbone。模型能够利用完整上下文判断某个 token 是否与当前 query 相关,而不是只依赖局部关键词匹配。
2.3.2 Line-Level Aggregation
SWE-Pruner 不直接按照 token 分数删除 token,而是将分数聚合到代码行。
对于第 \(j\) 行代码 \(\ell_j\),令 \(T_j\) 表示该行包含的 token 集合,则行分数为:
$$ \bar{s}_j =\frac{1}{|T_j|} \sum_{t\in T_j}s_t. $$推理时,如果:
$$ \bar{s}_j>\tau, $$则保留该行。默认阈值为 \(\tau=0.5\)。
这种设计同时利用了 token-level 表征和 line-level 输出:
- token 表征提供细粒度语义判断;
- 行级决策避免只删除半个表达式、部分标识符或部分缩进;
- 长文件可以分成多个 chunk 并行打分。
2.3.3 CRF-Based Structured Pruning
如果每一行独立进行二分类,剪枝结果可能在 retain 和 prune 之间频繁跳变。为了保持局部结构连续性,SWE-Pruner 将剪枝建模为序列标注问题,并使用 Conditional Random Field(CRF)。
令输入序列为 \(\mathbf{x}\),保留/删除标签为 \(\mathbf{y}\),则 CRF 负对数似然为:
$$ \mathcal{L}_{\mathrm{CRF\text{-}NLL}}(\mathbf{x},\mathbf{y}) =\log Z(\mathbf{x})-\mathrm{score}(\mathbf{x},\mathbf{y}). $$其中 score 同时包括:
- 每个位置的 emission score;
- 相邻 retain/prune 标签之间的 transition score;
- 序列开头与结尾的状态分数。
展开后,标签序列的 score 为:
$$ \mathrm{score}(\mathbf{x},\mathbf{y}) =\mathrm{start}_{y_1} +\sum_{t=1}^{T}E_{t,y_t} +\sum_{t=2}^{T}T_{y_t,y_{t-1}} +\mathrm{end}_{y_T}. $$其中 \(E_t=\mathrm{MLP}(\mathbf{h}_t)\in\mathbb{R}^{2}\) 是当前位置对 retain/prune 的 emission,\(T\in\mathbb{R}^{2\times2}\) 是相邻状态的 transition matrix。配分函数:
$$ \log Z(\mathbf{x}) =\log\sum_{\mathbf{y}'\in\mathcal{Y}} \exp(\mathrm{score}(\mathbf{x},\mathbf{y}')) $$对所有可能的标签序列进行归一化。CRF 的作用不是显式解析 AST,而是让模型学到“连续保留一段相关代码”通常比在相邻行间反复切换更合理。
训练时使用按长度归一化的压缩损失:
$$ \mathcal{L}_{\mathrm{compress}} =\frac{1}{B}\sum_{i=1}^{B} \frac{ \mathcal{L}_{\mathrm{CRF\text{-}NLL}} (\mathbf{x}_i,\mathbf{y}_i) }{L_i}. $$长度归一化用于避免长代码样本主导梯度。推理阶段使用 Viterbi decoding 得到结构连贯的最优标签序列。
2.3.4 Inference Algorithm
完整推理过程可以写成以下步骤:
- 将 Goal Hint 与候选代码共同送入 neural skimmer;
- 一次前向得到每个 token 的相关性分数、CRF emission 以及文档级相关性;
- 使用 Viterbi decoding 得到结构化 retain/prune 标签序列;
- 按原始换行符建立 token 到代码行的映射;
- 对每行 token 分数取平均,得到 \(\bar{s}_j\);
- 保留 \(\bar{s}_j>\tau\) 的代码行,并保持它们在原文件中的顺序;
- 对多个检索 chunk 并行执行上述过程,最后将结果合并后返回 Agent。
用伪代码表示为:
Input: raw context X, goal hint q, threshold tau
S, Y_crf, S_doc = NeuralSkimmer(q, X)
Y = ViterbiDecode(Y_crf)

kept_lines = []
for line in split_lines(X):
    line_score = mean(S[token] for token in line)
    if line_score > tau and CRF_allows_retain(line, Y):
        kept_lines.append(line)

return join_in_original_order(kept_lines), S_doc
阈值控制保留强度,CRF 控制局部连贯性,二者承担不同职责。论文默认使用验证集上确定的 \(\tau=0.5\),而不是在每个任务上重新调整固定压缩率。
2.4 Dual-Head Architecture
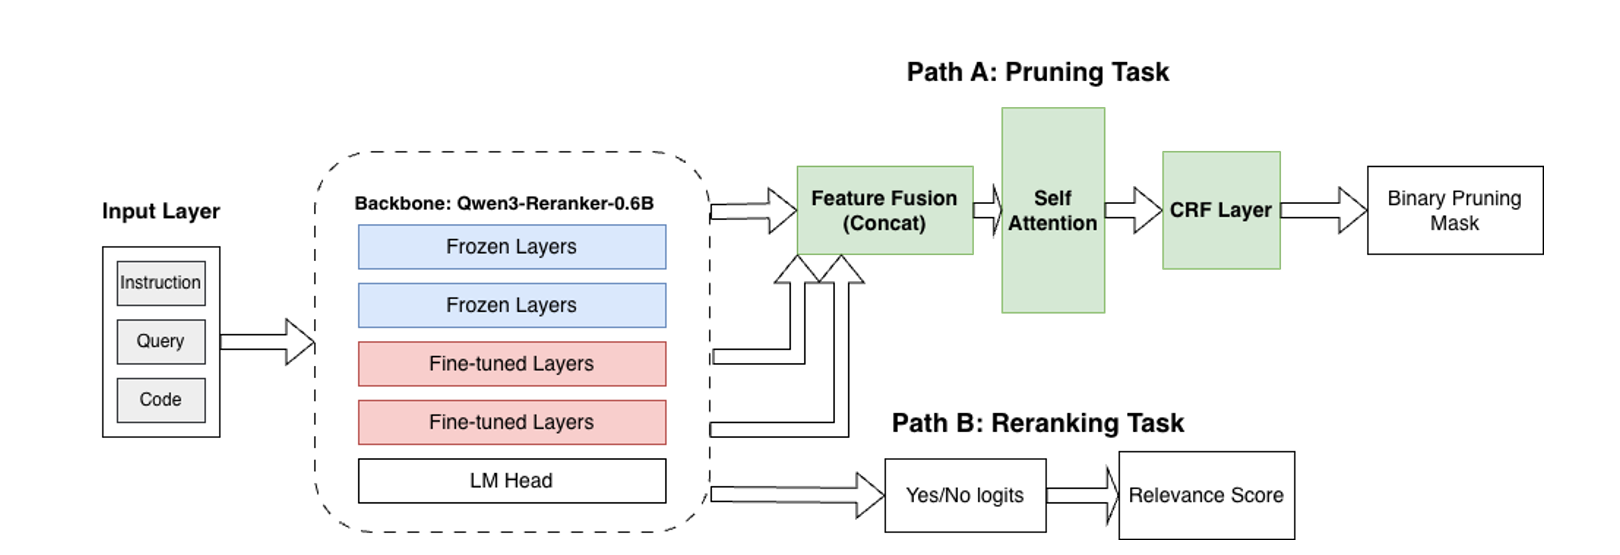
neural skimmer 在 Qwen3-Reranker-0.6B 上增加了两个任务头:
- CRF pruning head:输出 token/行级的 retain-prune mask;
- Reranking head:输出整个代码文档与 query 的相关性分数。
模型从 backbone 的第 7、14、28 层提取隐藏状态并拼接,然后依次经过:
- self-attention block;
- 8-head multi-head attention;
- hidden size 为 256 的特征融合模块。
最终的联合训练目标为:
$$ \mathcal{L}_{\mathrm{total}} =(1-\lambda)\mathcal{L}_{\mathrm{compress}} +\lambda\mathcal{L}_{\mathrm{rerank}}, $$其中 \(\lambda=0.05\)。Reranking head 使用 MSE 拟合教师模型给出的文档级相关性分数,使模型在学习局部剪枝的同时保留全局语义判断能力。
这里保留 reranking head 有两个好处。第一,它避免为了新任务完全丢弃原始 Qwen3-Reranker 的文档级能力;第二,同一次前向既能先判断候选文档整体是否相关,也能在文档内部进行行级精炼。因此 SWE-Pruner 可以作为粗粒度检索之后的二级 pruner,而不必替换现有检索系统。
2.5 Training Dataset
真实 Agent 轨迹通常没有精确的行级保留标签,因此论文使用强模型合成训练数据。
Code Source
代码来自 GitHub Code 2025。作者从 5,945 个仓库、195,370 个文件中采样 200,000 个代码片段,并覆盖:
- short、medium、long 三种长度;
- low、medium、high 三种 query-context 相关度;
- 多种编程语言和项目类型。
GitHub Code 2025 本身包含超过 150 万个仓库,数据同时覆盖超过 2 stars 的成熟项目和 2025 年新建项目。预处理会移除 binary、build artifact、配置噪声和 minified code,以避免模型把不可读内容当成剪枝规律。
Agentic Task Taxonomy
训练数据覆盖九类 Coding Agent 信息需求:
| Task Type | 目标 |
|---|---|
| code-summarize | 概括代码功能 |
| code-refactor | 改善可读性、模块性或性能 |
| find-relevant-part | 找到实现某项功能的代码 |
| code-locate | 定位 bug、功能或关键逻辑 |
| code-optimize | 查找可优化的实现路径 |
| code-explain | 解释算法或设计选择 |
| code-debug | 调试异常和边界情况 |
| feature-addition | 判断新增功能需要关联的代码 |
| code-completion | 根据已有代码补全后续实现 |
这九类任务并不是只改变 query 的措辞,而是改变“哪些行应该保留”的定义。例如,code-summarize 偏向接口、控制流和核心功能;code-debug 更关注错误分支、状态更新与异常处理;feature-addition 则需要保留调用点、数据结构和扩展接口。任务条件化使同一段代码能够对应不同的 retain mask。
Data Generation and Filtering
Qwen3-Coder-30B-A3B-Instruct 为每个代码片段生成四元组:
$$ (q,C,M,S), $$分别表示 query、代码上下文、行级保留 mask 和文档级相关性分数。
随后使用 Qwen3-Next-80B-A3B-Thinking 作为 LLM-as-a-Judge,检查推理质量、标签一致性和任务相关性。约六分之一的候选样本通过筛选,最终训练集包含 61,184 条样本。
数据生成使用 temperature 0.7、top-p 0.9,以增加 query 和任务场景的多样性。整体管线如下:
$$ \text{Code Snippet} \rightarrow \text{Task Sampling} \rightarrow \text{Teacher Query + Mask + Score} \rightarrow \text{Judge Filtering} \rightarrow \text{Training Quadruplet}. $$采样时同时平衡九类 task、三档代码长度和三档相关性。Judge 不仅检查 query 是否自然,还检查 mask 是否覆盖回答 query 所需的实现、行级标签是否自洽以及文档相关性分数是否合理。最终样本的 query 平均为 39.98 words、中位数为 24 words;平均字符数 291.69、中位数 169,既包含简短定位问题,也包含较完整的工程需求。
2.6 Training Configuration
主要训练配置如下:
- global batch size:128;
- 8 张 GPU,每卡 batch size 为 16;
- AdamW optimizer;
- learning rate:\(3\times10^{-5}\);
- weight decay:0.01;
- 训练 3 epochs;
- dropout:0.4;
- 只微调 backbone 最后两层、特征融合模块和 CRF;
- 推理阈值:\(\tau=0.5\)。
训练目标中的 reranking 权重设为 \(\lambda=0.05\)。Agent 推理使用 temperature 0,最大交互轮数为 250;适用时对三个随机种子取平均。只更新 backbone 最后两层能够控制训练和部署成本,同时让新增的 feature fusion 与 CRF 学到针对代码剪枝的结构信息。
2.7 Integration in Multi-Turn and Single-Turn Workflows
多轮任务中,Goal Hint 随 Agent 的推理状态变化。例如,前几轮可能询问“哪个模块实现 query cloning”,定位到文件后则变为“Query.clone() 如何复制 combined_queries”。同一个读取工具由此可以从宽泛探索切换为局部核查。
单轮任务中没有动态轨迹,问题本身直接作为 Goal Hint:
- Long Code Completion:待补全的代码片段作为 query,保留对下一行生成有帮助的定义和调用;
- Long Code QA:自然语言问题作为 query,保留回答所需的实现、注释和相关接口。
因此,SWE-Pruner 的核心接口始终是 \((q,C)\rightarrow C'\),区别只在于 query 来自当前 Agent 状态还是 benchmark 原始问题。
3. Experiments
3.1 Experimental Setup
论文同时评测多轮 Agent 任务和单轮长代码理解任务。
Multi-Turn Agent Tasks
- SWE-Bench Verified:500 个真实 GitHub issue,要求 Agent 生成能够通过测试的 patch;
- SWE-QA:在 Streamlink、Reflex、Conan 三个仓库上进行 repository-level question answering;
- Agent framework:Mini-SWE-Agent 和 OpenHands;
- Backbone:Claude Sonnet 4.5、GLM-4.6。
Single-Turn Tasks
- Long Code Completion:500 个 Python 样本,输入长度超过 5K token;
- Long Code QA:包含最长可达 1M token 的代码上下文;
- 下游模型:Qwen2.5-Coder-7B-Instruct,并使用 Seed-Coder-8B-Instruct 进行额外验证。
Baselines
- Full Context / No Context;
- Selective-Context;
- LLMLingua-2;
- UniXCoder RAG;
- LongCodeZip;
- LLM Summarize(多轮任务)。
这些 baseline 分别代表不同粒度:
| Category | Method | Selection Unit | Main Risk |
|---|---|---|---|
| Token pruning | Selective-Context | subword token | 按 self-information 删除 token,容易破坏语法 |
| Token pruning | LLMLingua-2 | subword token | XLM-R 分类器不包含代码结构约束 |
| Retrieval | RAG | function chunk | 粗粒度选择可能漏掉局部实现 |
| Structural compression | LongCodeZip | AST chunk / high-entropy region | 结构保留较好,但目标适应性有限 |
| Generation | LLM Summarize | file summary | 有生成延迟,且可能丢失精确标识符 |
| Task-aware pruning | SWE-Pruner | source line | 依赖 Goal Hint 与行级评分质量 |
RAG 使用 UniXCoder embedding 和 cosine similarity 做 function-level top-k 检索;LongCodeZip 结合 AST chunking 与 entropy-guided compression。单轮实验将 baseline 配置为相同的 4× / 8× compression constraint,但由于不同方法的选择单位不同,最终的有效压缩率并不完全相同。
Metrics and Evaluation Protocol
论文同时报告任务质量和效率指标:
- Long Code Completion:Edit Similarity(ES)与 Exact Match(EM);
- Long Code QA:Accuracy;
- SWE-Bench Verified:自动测试得到的 Resolve Rate;
- SWE-QA:LLM-as-a-Judge 平均分,覆盖 correctness、completeness、relevance、clarity 和 reasoning 五个维度;
- 效率:token consumption、agent rounds、API cost 与 TTFT。
压缩率定义为:
$$ \mathrm{Compression\ Ratio} =\frac{|C_{\mathrm{original}}|}{|C_{\mathrm{compressed}}|}. $$SWE-Bench Verified 包含 12 个 Python 仓库的 500 个真实 issue,patch 必须在 Docker 环境中通过目标测试且不引入 regression。SWE-QA 的三个仓库为 Streamlink、Reflex 和 Conan。Agent 侧分别接入 Mini-SWE-Agent 与 OpenHands,说明 middleware 接口不依赖某一种 agent loop。
3.2 SWE-Bench Verified
| Agent | Rounds | Solved | Success | Tokens | API Cost |
|---|---|---|---|---|---|
| Claude Sonnet 4.5 | 51.0 | 353/500 | 70.6% | 0.911M | 0.504 |
| + SWE-Pruner | 41.7 | 360/500 | 72.0% | 0.701M(-23.1%) | 0.369(-26.8%) |
| GLM-4.6 | 49.3 | 277/500 | 55.4% | 0.791M | 0.055 |
| + SWE-Pruner | 36.6 | 283/500 | 56.6% | 0.488M(-38.3%) | 0.035(-36.4%) |
SWE-Pruner 在两个 backbone 上都减少了交互轮数和 token 消耗,同时修复成功率分别提高 1.4 和 1.2 个百分点。这说明任务相关代码过滤不仅减少输入长度,也能降低重复读取和无效探索。
进一步拆解可见,Claude 的平均 rounds 从 51.0 降至 41.7,减少 18.2%;GLM 从 49.3 降至 36.6,减少 25.7%。附录对 prompt / completion token 的轨迹级统计给出:
| Backbone | Prompt Token Reduction | Completion Token Reduction | Total Token Reduction | Round Reduction |
|---|---|---|---|---|
| Claude Sonnet 4.5 | 38.7% | 40.8% | 39.2% | 18.3% |
| GLM-4.6 | 44.2% | 44.0% | 43.6% | 34.6% |
这里的轨迹级百分比来自附录 Figure 7 的完整分布分析,与主表按 instance 汇总的 23.1% / 38.3% 不是同一种统计口径。prompt 和 completion 同时下降,说明更干净的观察还会使主模型的回复更集中;效果不只来自机械缩短输入。
作者还在 50 个随机样本上比较不同上下文管理方法:
| Method | Rounds | Success | Tokens |
|---|---|---|---|
| Mini-SWE-Agent | 52.3 | 62% | 0.972M |
| + LLMLingua-2 | 42.1 | 54% | 0.856M |
| + RAG | 40.2 | 50% | 0.771M |
| + LLM Summarize | 41.3 | 56% | 0.794M |
| + LongCodeZip | 44.3 | 54% | 0.889M |
| + SWE-Pruner | 41.1 | 64% | 0.670M |
在相同实验设置下,SWE-Pruner 获得最高成功率和最低 token 消耗。Token-level 方法可能破坏代码结构,而 RAG 的粗粒度检索可能遗漏完成修复所需的局部实现。
3.3 SWE-QA
| Repo / Backbone | Score | Rounds | Tokens |
|---|---|---|---|
| Streamlink / Claude | 8.36 → 8.59 | 23.4 → 23.9 | 611.2K → 557.1K(-8.9%) |
| Streamlink / GLM | 8.56 → 8.56 | 18.2 → 25.0 | 318.2K → 145.1K(-54.4%) |
| Reflex / Claude | 8.68 → 8.85 | 33.2 → 32.4 | 1081.6K → 866.8K(-19.9%) |
| Reflex / GLM | 8.37 → 8.23 | 26.1 → 36.7 | 142.3K → 101.2K(-28.9%) |
| Conan / Claude | 8.70 → 8.84 | 23.9 → 23.5 | 654.7K → 520.7K(-20.5%) |
| Conan / GLM | 8.58 → 8.45 | 21.4 → 27.7 | 175.9K → 116.6K(-33.7%) |
Claude Sonnet 4.5 在三个仓库中的交互轮数基本保持不变,GLM-4.6 的交互轮数则增加 29%–41%。轨迹分析显示,GLM 在获得聚焦上下文后会继续探索更多文件,但由于每轮输入更短,总 token 仍显著下降。
这组结果也说明 rounds 不能单独作为效率指标。GLM 在 Streamlink 上从 18.2 增加到 25.0 rounds,但 token 从 318.2K 降到 145.1K;只看轮数会得出相反结论。更合理的评估应同时观察每轮上下文大小、总 token、最终分数和成本。
3.4 Long Code Completion and Long Code QA
Qwen2.5-Coder-7B-Instruct
完整结果如下。CR 表示实际 compression ratio,而不是目标 constraint:
| Method | LCC 4× CR | ES | EM | LCC 8× CR | ES | EM | QA 4× CR | Acc | QA 8× CR | Acc |
|---|---|---|---|---|---|---|---|---|---|---|
| Full Context | 1.00 | 64.65 | 40.5 | 1.00 | 64.65 | 40.5 | 1.00 | 54.05 | 1.00 | 54.05 |
| No Context | ∞ | 44.90 | 13.5 | ∞ | 44.90 | 13.5 | ∞ | 38.39 | ∞ | 38.39 |
| Selective-Context | 3.27 | 52.48 | 22.0 | 7.49 | 48.67 | 17.0 | 3.69 | 55.36 | 7.32 | 51.79 |
| LLMLingua-2 | 3.32 | 49.47 | 15.5 | 7.89 | 44.74 | 13.0 | 3.57 | 55.36 | 7.68 | 51.33 |
| RAG | 3.29 | 58.97 | 30.5 | 6.60 | 55.82 | 29.0 | 3.06 | 58.04 | 5.87 | 55.86 |
| LongCodeZip | 2.77 | 57.77 | 28.0 | 7.85 | 56.08 | 27.5 | 3.98 | 52.25 | 7.39 | 54.95 |
| SWE-Pruner | 5.56 | 58.63 | 31.5 | 10.92 | 57.58 | 31.0 | 13.95 | 59.46 | 14.84 | 58.71 |
两个现象最关键。第一,token-level 方法在 8× constraint 下明显退化:LLMLingua-2 的 LCC ES / EM 降至 44.74 / 13.0,接近 No Context。第二,SWE-Pruner 实际压缩率可以超过名义 constraint,因为它按相关性阈值选择整行,而不是机械凑齐 token budget。在 Long Code QA 4× 设置中,实际已达到 13.95×,仍取得最高的 59.46 accuracy。
Seed-Coder-8B-Instruct
作者进一步更换下游代码模型,验证结果是否只对 Qwen2.5-Coder 有效:
| Method | LCC 4× CR | ES | EM | LCC 8× CR | ES | EM | QA 4× CR | Acc | QA 8× CR | Acc |
|---|---|---|---|---|---|---|---|---|---|---|
| Full Context | 1.00 | 65.03 | 40.5 | 1.00 | 65.03 | 40.5 | 1.00 | 49.11 | 1.00 | 49.11 |
| No Context | ∞ | 43.85 | 14.0 | ∞ | 43.85 | 14.0 | ∞ | 37.50 | ∞ | 37.50 |
| Selective-Context | 3.27 | 53.68 | 24.5 | 7.49 | 49.89 | 17.5 | 2.71 | 51.33 | 6.69 | 46.43 |
| LLMLingua-2 | 3.95 | 48.09 | 15.0 | 7.89 | 45.53 | 13.5 | 3.70 | 43.36 | 5.46 | 39.82 |
| RAG | 3.32 | 58.21 | 31.0 | 6.78 | 56.97 | 28.5 | 3.44 | 53.98 | 6.65 | 53.57 |
| LongCodeZip | 3.96 | 56.72 | 25.5 | 6.53 | 54.91 | 23.0 | 3.29 | 51.33 | 7.49 | 50.91 |
| SWE-Pruner | 4.22 | 57.71 | 31.0 | 8.13 | 56.73 | 28.5 | 9.98 | 56.25 | 14.68 | 55.75 |
Seed-Coder 上,SWE-Pruner 在 QA 8× constraint 下达到 14.68× / 55.75,明显高于 RAG 的 6.65× / 53.57。LCC 的 ES 略低于 RAG,但 compression ratio 更高,EM 相同。这说明它的优势更准确地说是在更高压缩率下保持竞争力,而不是每个单项分数都绝对最高。
3.5 Syntactic Structure Preservation
作者使用 tree-sitter 检查剪枝后代码的 AST 正确率:
| Method | AST Correctness |
|---|---|
| Full Context | 98.5% |
| LLMLingua-2 | 0.29% |
| Selective-Context | 12.4% |
| Random Token Pruner | 49.6% |
| Function RAG | 92.3% |
| Function RAG + Random Line Pruner | 78.2% |
| Function RAG + SWE-Pruner | 87.3% |
| LongCodeZip | 89.3% |
| LongCodeZip + SWE-Pruner | 76.8% |
LLMLingua-2 和 Selective-Context 的 AST 正确率分别只有 0.29% 和 12.4%,说明任意 token 删除会严重破坏代码结构。SWE-Pruner 作为 Function RAG 后的二级剪枝,将 AST 正确率从 92.3% 降到 87.3%,但仍明显高于 token-level compression。
需要注意,line-level pruning 不等于 AST-preserving。删除完整一行仍可能移除函数头、分支条件或闭合结构,所以 Function RAG + SWE-Pruner 仍比未做二级剪枝的 92.3% 低 5 个百分点;在 LongCodeZip 之后继续剪枝时也从 89.3% 降到 76.8%。这张表证明的是“行级比 token 级更稳健”,不是“行级剪枝一定保持可解析”。
3.6 Efficiency
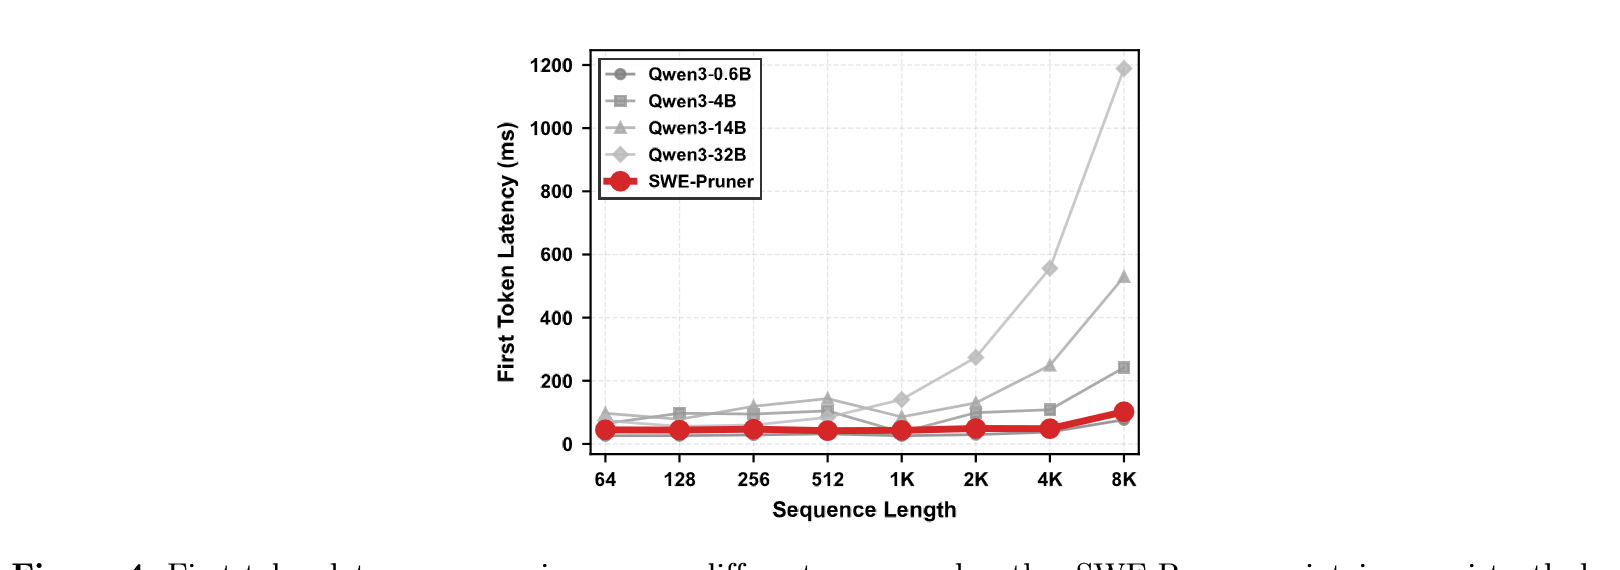
| Model | 64 | 128 | 512 | 2,048 | 8,192 |
|---|---|---|---|---|---|
| Qwen3-0.6B | 26.18 | 26.31 | 32.00 | 29.64 | 76.73 |
| Qwen3-4B | 64.75 | 97.24 | 104.93 | 99.10 | 241.97 |
| Qwen3-14B | 97.17 | 78.11 | 143.65 | 129.97 | 529.45 |
| Qwen3-32B | 73.99 | 55.46 | 84.01 | 274.22 | 1188.67 |
| SWE-Pruner | 44.70 | 43.91 | 42.05 | 49.05 | 102.00 |
SWE-Pruner 的延迟随输入长度增长较慢。8K 输入时,附录 Table 6 报告的 TTFT 为 102.00 ms,而 Qwen3-32B 为 1188.67 ms。由于剪枝减少了后续主模型的 prefill、decode 和 API token 成本,这部分前置开销可以在多轮交互中被摊薄。
8K 输入下,SWE-Pruner 相比 Qwen3-14B 快约 5.2×,相比 Qwen3-32B 快约 11.7×。论文还指出真实闭源 API 一次往返通常远高于这几十毫秒的本地剪枝开销。更重要的是,多轮 Agent 中节省会累积:剪枝减少本轮 observation,较短 observation 又会进入后续每一轮 prompt,因此收益不是一次性的。
3.7 Case Studies on SWE-Bench
Case 1: From Resource Exhaustion to Success
任务 django__django-10554 要求修复 Query.clone() 对 combined_queries 缺少 deep copy 的问题。
| Setting | Steps | Read | Search | Exec | Edit | Tokens | Outcome |
|---|---|---|---|---|---|---|---|
| Baseline | 164 | 59 | 39 | 1 | 25 | 7,001,934 | Resource limit exhausted |
| SWE-Pruner | 56 | 20 | 10 | 0 | 11 | 1,170,160 | Solved |
Baseline 的最大 prompt 达到 87,790 tokens,并采用 breadth-first 探索:先全仓搜索 union,再对多个文件反复执行分段 sed -n。这些旁支内容不断累积,最终在 164 steps 后耗尽资源。
SWE-Pruner Agent 直接进入 django/db/models/sql/query.py,用带行号的读取定位 if self.combinator: 分支,在 56 steps 内完成修改。总 token 减少 83.3%,peak prompt 降到 38,226。这个案例展示的不是同一条成功轨迹变便宜,而是上下文控制将一次资源受限失败变成成功。
Case 2: Lower Peak Context with the Same Outcome
任务 django__django-11740 要求在 migration autodetector 的 AlterField 中加入 foreign-key dependency tracking。两种 Agent 都成功:
| Setting | Steps | Read | Search | Exec | Edit | Tokens |
|---|---|---|---|---|---|---|
| Baseline | 42 | 12 | 8 | 1 | 18 | 857,371 |
| SWE-Pruner | 48 | 14 | 8 | 0 | 13 | 806,220 |
SWE-Pruner 多用了 6 steps,但 token 减少 6.0%,最大 prompt 缩短 30.2%。Baseline 多次分段读取 autodetector.py,还创建临时 Python 脚本验证理解;SWE-Pruner 一次读取带行号的完整文件后直接修改 _get_dependencies_for_foreign_key 相关位置。
两个案例对应两类收益:
- Capacity benefit:避免 context overflow,使原本失败的任务完成;
- Structural efficiency benefit:结果不变,但降低总 token 与 peak context。
它们也再次说明 steps 与 token 不能等价:第二个案例 rounds 更多,却仍然使用更少上下文。
4. Limitations
论文列出了以下限制:
- 当前实现和主要 Agent 实验集中在 Python 仓库,跨语言和复杂构建系统仍需要进一步验证;
- 训练数据由教师模型合成,可能继承教师模型的标注偏差;
- Goal Hint 的质量会影响剪枝结果,过窄或错误的 Goal Hint 可能删除关键代码;
- 行级剪枝能够提高结构完整性,但无法完全避免删除语法依赖或跨行上下文;
- neural skimmer 仍会引入额外延迟,未来可以通过蒸馏或 early exit 进一步优化;
- 数据泄漏通过选择较新的仓库进行缓解,但仍需要持续在新发布项目上评测。
5. Conclusion
SWE-Pruner 是一个面向 Coding Agent 文件观察的轻量级上下文剪枝框架。它通过 Goal Hint 描述 Agent 当前的信息需求,再使用 0.6B neural skimmer 对代码进行 query-aware line-level pruning。
完整流程可以概括为:
$$ \text{Goal Hint} \rightarrow \text{Token Relevance Scoring} \rightarrow \text{Line-Level Aggregation} \rightarrow \text{CRF Structured Selection} \rightarrow \text{Pruned Context}. $$实验结果表明,SWE-Pruner 能够在 SWE-Bench Verified 上减少 23.1%–38.3% 的 token 和 26.8%–36.4% 的 API 成本,同时维持或提升任务成功率。在单轮长代码理解任务中,line-level 和 query-aware 设计也获得了比 token-level compression、RAG 和结构化压缩更高的有效压缩率与任务性能。