SWE-Pruner Pro: The Coder LLM Already Knows What to Prune
Status: arXiv v1, 2026-07-20
Paper: https://arxiv.org/abs/2607.18213
Github: https://github.com/Ayanami1314/swe-pruner-pro
Authors: Yuhang Wang, Yuling Shi, Shaoqiu Zhang, Jialiang Liang, Shilin He, Siyu Ye, Yuting Chen, Kai Cai, Xiaodong Gu
Abstract
Coding Agent 在真实仓库中解决问题时,会不断调用 cat、grep、ls、python 等工具。工具输出不仅可能一次包含数百行内容,还会作为历史消息在后续轮次中被重复送入模型。真正决定修复方案的通常只是其中一小部分代码、错误信息或文件路径,其余内容却持续占用输入 token、显存和推理时间。
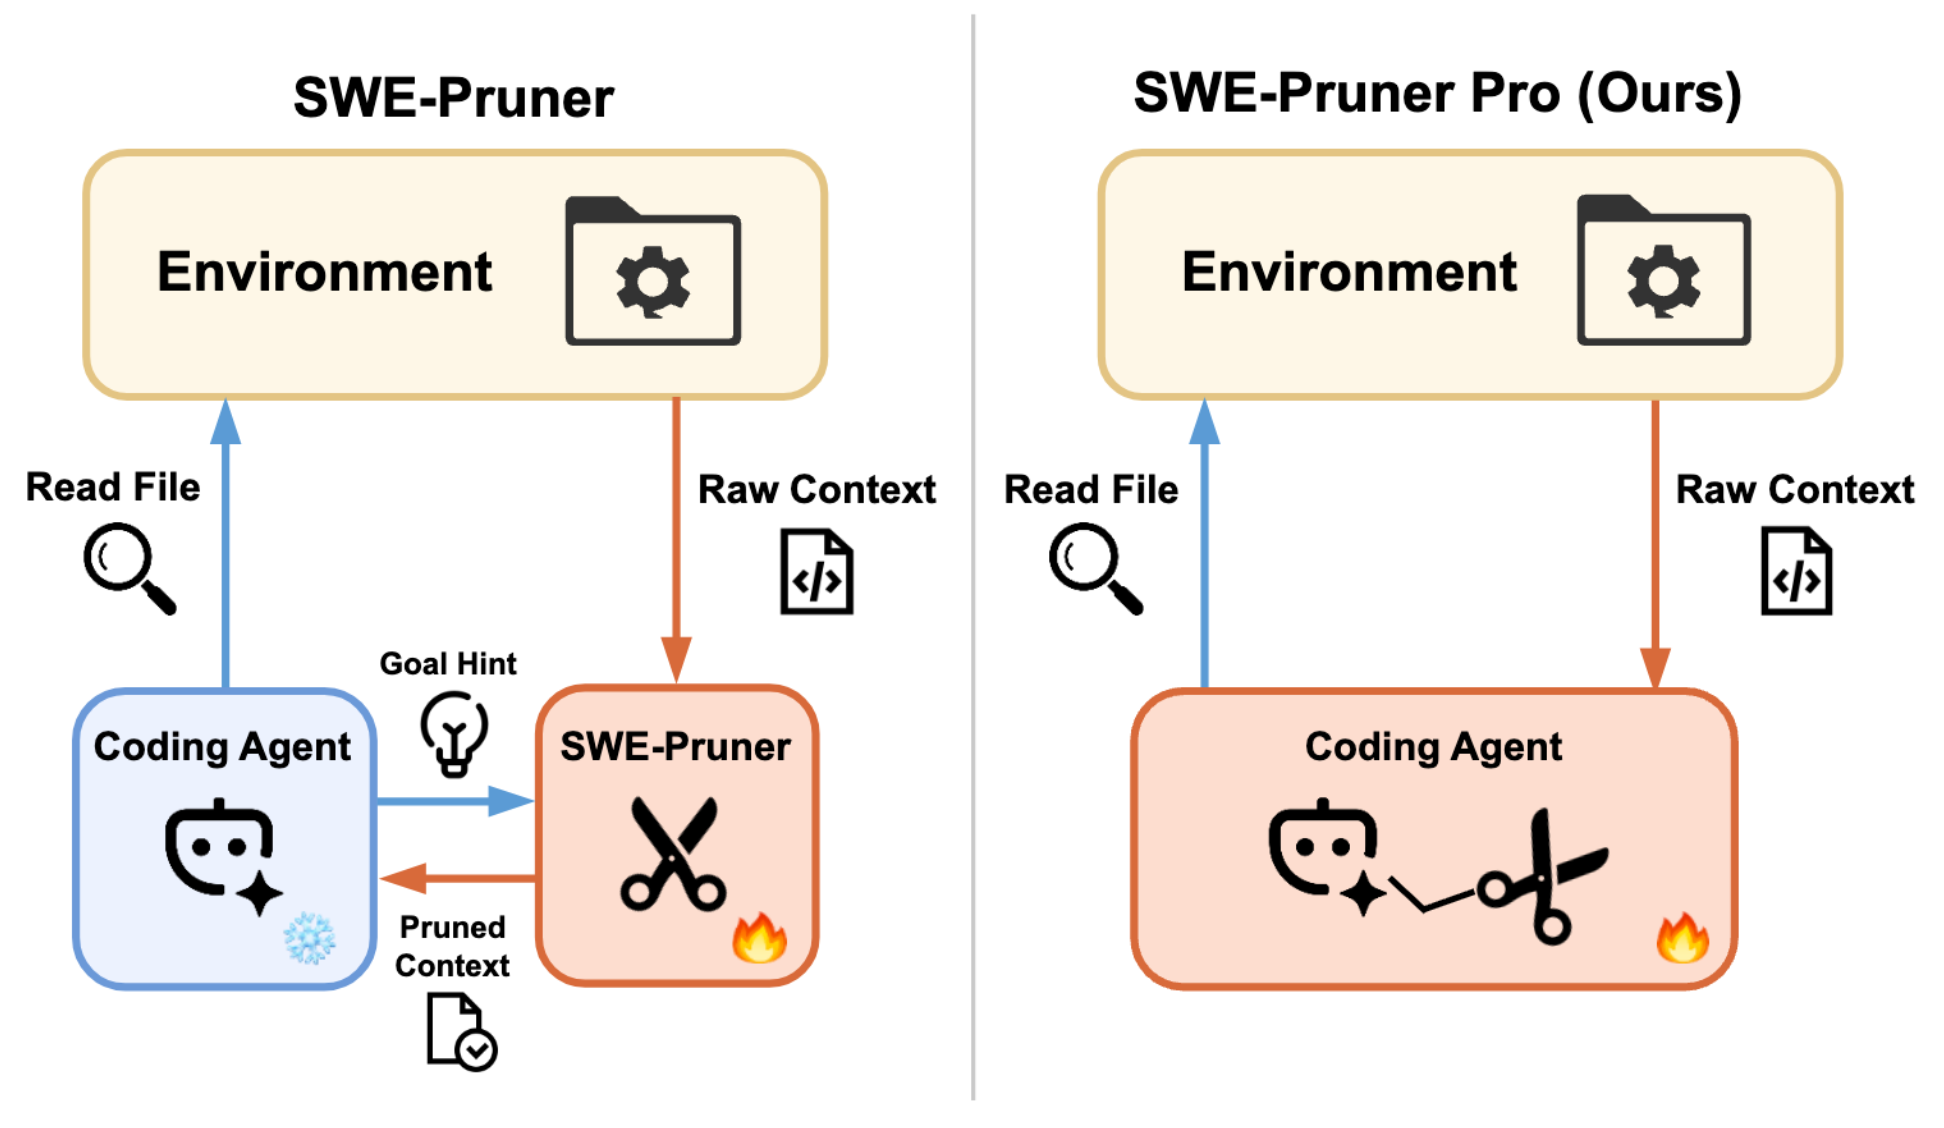
以往的上下文剪枝大致有两条路线:通用压缩方法根据困惑度、语法结构或检索相似度选择内容;SWE-Pruner 一类任务感知方法则额外部署一个评分模型,并要求 Agent 每轮写出描述当前信息需求的 Goal Hint。它们有一个共同点:都在 Agent 外部重新构造“哪些内容重要”这一信号。
SWE-Pruner Pro 的核心观察是:Agent 在阅读工具输出并准备下一步行动时,其最后一层隐藏状态已经编码了每行内容与当前任务的相关性。 因此,系统无需再调用独立模型,只需在冻结的 Agent backbone 上挂接一个小型分类头,将已有隐藏状态转换为逐 token 的保留概率,再通过行内多数投票得到 keep/prune 决策。一个由工具输出行数索引的长度感知嵌入,使短输出更保守、长输出更积极地压缩。
论文在 Qwen3-Coder-Next 与 MiMo-V2-Flash 两个开放权重 backbone、四个多轮 benchmark 上进行评测。SWE-Pruner Pro 在所有六个只读任务设置中都降低了总 token,最高节省 39.4%;在 MiMo-V2-Flash 的 SWE-Bench Verified 上,Resolve Rate 提高 3.8 个百分点。部署方面,把约 18M 参数的 head 放入 SGLang 推理引擎后,16 条轨迹回放中的聚合剪枝开销约为生成时间的 15.0%。
需要先把结论的边界说清楚:SWE-Pruner Pro 并非在所有模型、所有任务上都同时提高质量和效率。Qwen3-Coder-Next 的 SWE-Bench Verified 上,它虽然减少 13.5% 输入 token,但少解决 6 个问题;而剪枝改变了 Agent 的后续行为,API 调用次数也可能增加。它的主要贡献是给出一种新的上下文管理范式:不再额外询问 Agent 什么重要,而是读取 Agent 已经形成的相关性表征。
1. Problem Setup
1.1 Coding Agent 为什么会积累长上下文
一个典型的仓库级 Agent 循环可以写成:
$$ \text{Reasoning} \rightarrow \text{Tool Call} \rightarrow \text{Tool Response} \rightarrow \text{Reasoning} \rightarrow \cdots $$假设第 \(t\) 轮之前的历史为 \(H_{t-1}\),Agent 发出的工具调用为 \(c_t\),环境返回的原始结果为 \(r_t\),那么模型下一次生成所看到的输入近似为:
$$ C_t=[H_{t-1},c_t,r_t]. $$问题不只是 \(r_t\) 很长,而是它会被加入 \(H_t\),于是此后的每轮请求都要再次携带这段输出。若一条早期 cat 命令返回 500 行代码,它的成本会在剩余轨迹中反复出现。论文引用的先前统计显示,在 SWE-Bench Verified 上,Mini-SWE-Agent 的文件读取命令占 Claude Sonnet 4.5 轨迹 token 的 70% 以上。
这里需要区分两种 token:
- Prompt/Input token:历史、工具调用和工具输出,进入模型的上下文;
- Completion/Output token:模型生成的推理、命令或最终答案。
工具输出剪枝主要直接减少前者,但它还会改变 Agent 之后看到的信息,因此可能间接改变输出长度、调用次数和探索路径。这也是后文不能只用“单次压缩率”评价方法的原因。
1.2 这篇论文中的几个基础概念
Prefill 是模型对输入 prompt 做一次前向计算、建立注意力 KV Cache 的阶段;Decode 是随后逐 token 生成的阶段。长工具输出会提高 prefill 成本,也会让后续 decode 的每一步面对更长的上下文。
KV Cache 保存注意力层中已有 token 的 Key 和 Value,使模型不必在每次生成新 token 时重算整个前缀。但 KV Cache 通常不保存最后一层的完整 hidden state;这一区别会直接影响 SWE-Pruner Pro 的工程实现。
Hidden state \(\mathbf h_i\in\mathbb R^d\) 是模型读到第 \(i\) 个 token 后形成的内部向量。它不是一个可直接阅读的“重要性分数”,但包含语义、位置、任务意图和上下文交互后的信息。论文要验证的问题正是:是否能从这些向量中解码出 keep/prune 决策。
行级剪枝 表示模型可以删除整行,却不删除一行中的部分 subword token。它比任意 token 删除更适合代码和终端输出,因为至少不会留下半个标识符或半条命令;但它并不等价于 AST 级重写,也不能严格保证删除后的代码在语法上可执行。这里的目标是为 Agent 留下一份可导航、可推理的 skeleton view,而不是生成一个能够独立运行的新源文件。
1.3 先前方法缺在哪里
通用压缩器通常采用固定代理指标:
- LLMLingua2、Selective Context 一类方法以 token 信息量或上下文冗余为依据;
- RAG 根据 query 与窗口或 chunk 的相似度选择内容;
- LongCodeZip 利用代码结构和困惑度排序函数、代码块。
这些方法可以判断一段内容一般而言是否“信息丰富”,却未必知道 Agent 此刻正在验证哪条假设。某个普通赋值语句在一个任务中可能完全无关,在另一个任务中却恰好是错误根因。
原始 SWE-Pruner 加入了任务感知能力,但需要两个额外条件:一个独立 code classifier,以及 Agent 每轮显式生成的 Goal Hint。这样做既有模型调用和部署成本,也要求 Agent 准确表达自己的当前关注点。
SWE-Pruner Pro 的问题意识可以浓缩为一句话:既然 Agent 已经读过 \(r_t\) 并将基于它决定下一步,为什么还要让另一个模型重新判断一次相关性?
2. Key Evidence: Relevance Is Already in the Backbone
直接挂一个 head 之前,作者先做了 probing study,验证隐藏状态中确实存在可解码的剪枝信号。
2.1 Probe 的构造过程
作者从公开的 SWE-Bench 风格轨迹和终端任务轨迹中抽取约 625 条 trajectory、2,260 个工具响应、155K 行文本,并让 Claude Sonnet 4.6 为每行标注 keep 或 prune。数据按 trajectory 做 90/10 划分,避免同一轨迹的相邻步骤同时出现在训练集和测试集。
对第 \(\ell\) 行包含的 token 集合 \(T_\ell\),先对 Qwen3-Coder-Next 最后一层隐藏状态做 mean pooling:
$$ \bar{\mathbf h}_{\ell}= \frac{1}{\lvert T_\ell\rvert} \sum_{i\in T_\ell}\mathbf h_i. $$随后冻结 backbone,只训练一个 logistic regression:
$$ P(y_\ell=1\mid \bar{\mathbf h}_{\ell})= \sigma(\mathbf w^\top\bar{\mathbf h}_{\ell}+b). $$这里 \(y_\ell=1\) 表示保留该行。这个实验的目的不是获得最终系统,而是做一个 existence proof:若如此简单的线性分类器都明显优于多数类基线,说明相关性判断已经存在于 backbone 的表示中。
2.2 Probe 结果如何理解
线性 probe 在未见轨迹上达到:
- AUC = 0.83:随机抽取一个保留行与一个删除行,模型有约 83% 的概率让前者得分更高;
- best F1 = 0.63;
- 数据中的正类比例约为 30%。若粗暴地把所有行都预测为 keep,F1 上界为
因此 0.63 并非仅来自类别分布。
LDA 投影中 kept 与 pruned 两类的均值明显分离,但中间区域仍有大量重叠。这说明两个事实同时成立:
- Agent 的隐藏状态确实包含相关性信号;
- 单一线性超平面还不足以完成高质量剪枝,尤其无法处理工具输出长度不同造成的风险不对称。
这两个观察分别导向后面的非线性 FFN head 与 length-aware embedding。
3. Overall Pipeline
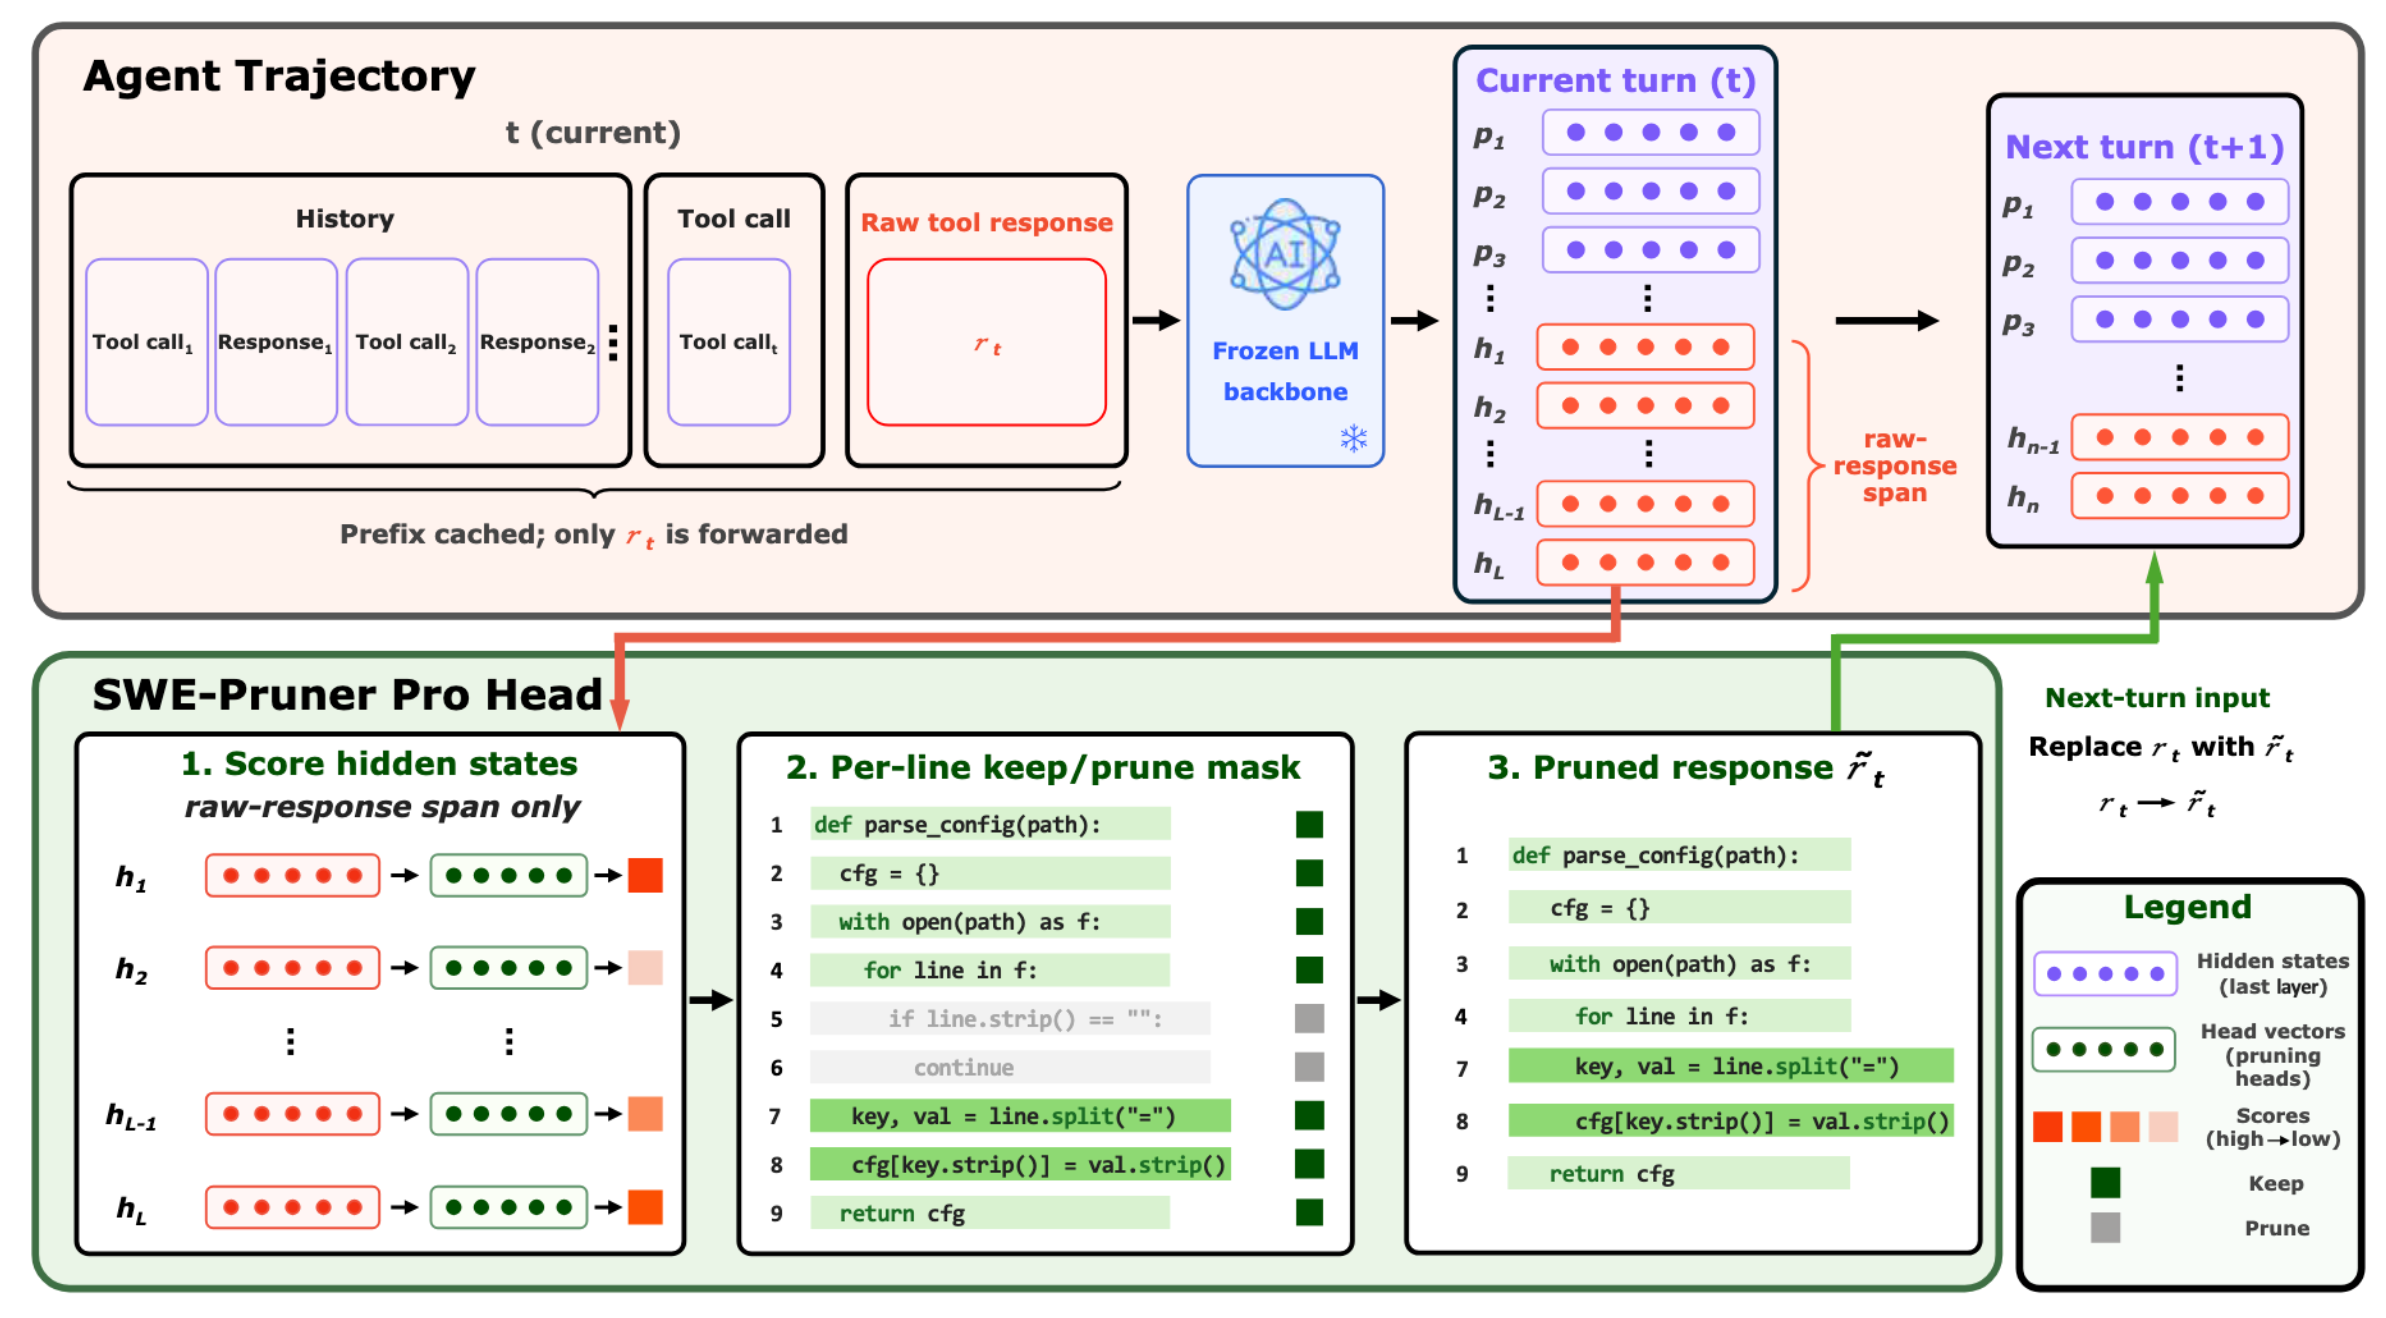
SWE-Pruner Pro 最关键、也最容易误解的地方是它的执行时序。
3.1 第 \(t\) 轮发生了什么
当环境返回 \(r_t\) 后,模型准备生成下一步行动。它对下面的序列执行 prefill:
$$ [H_{t-1},c_t,r_t]. $$其中前缀 \([H_{t-1},c_t]\) 已经存在于 KV Cache,因此正常情况下只需 forward 新到达的 \(r_t\)。这个过程产生工具响应 span 上的最后一层隐藏状态:
$$ \{\mathbf h_1,\mathbf h_2,\ldots,\mathbf h_L\}, \qquad L=\lvert r_t\rvert_{\mathrm{token}}. $$剪枝 head 直接读取这些本来就会产生的向量,为每个 token 输出 keep 概率,并聚合成逐行决策,得到 \(\tilde r_t\)。
3.2 为什么剪枝从下一轮才生效
第 \(t\) 轮的 Agent 必须先读完原始 \(r_t\),隐藏状态才存在。因此它当前生成下一步行动时仍能看到完整输出,不会出现“还没读就先删”的因果矛盾。真正写入下一轮历史的是:
$$ H_t=[H_{t-1},c_t,\tilde r_t,\text{next action}_t]. $$也就是说,SWE-Pruner Pro 是一种 turn-boundary substitution:本轮完整阅读,轮次之间压缩,后续只保留 skeleton。
因为缓存中原来对应的是 \(r_t\),而下一轮历史改成了 \(\tilde r_t\),系统需要对较短的 \(\tilde r_t\) 重新 forward 一次以建立一致的 KV Cache。这是新增的 backbone 工作。标注数据的平均 keep rate 约 32%,所以这次重算通常远短于重算原始响应,而之后的每轮都能受益于更短历史。
3.3 一个具体例子
假设工具返回:
def parse_config(path):
    cfg = {}
    with open(path) as f:
        for line in f:
            if line.strip() == "":
                continue
            key, val = line.split("=")
            cfg[key.strip()] = val.strip()
    return cfg
若 Agent 接下来关心配置项如何拆分,head 可能删除空行处理两行,保留函数签名、控制流骨架、split 和赋值:
1 | def parse_config(path):
2 |     cfg = {}
3 |     with open(path) as f:
4 |         for line in f:
7 |             key, val = line.split("=")
8 |             cfg[key.strip()] = val.strip()
9 |     return cfg
这份输出不保证仍可直接执行,但保留行号、结构边界和任务相关语句,足以让 Agent 在下一轮继续定位代码。
4. The Pruning Head
4.1 Length-Aware Embedding
令工具输出共有 \(N\) 行,backbone 隐藏维度为 \(d\)。系统学习一个长度嵌入 \(\mathbf e(N)\in\mathbb R^d\),并把它广播加到所有响应 token 上:
$$ \tilde{\mathbf h}_i= \mathbf h_i+\mathbf e(N). $$论文实现没有为每个可能的 \(N\) 单独建立向量,而是使用 8 个对数尺度的区间:
| Bucket | 工具输出行数 |
|---|---|
| 1 | 0–2 |
| 2 | 3–5 |
| 3 | 6–10 |
| 4 | 11–20 |
| 5 | 21–50 |
| 6 | 51–100 |
| 7 | 101–200 |
| 8 | > 200 |
嵌入表初始化为全零。因此训练刚开始时,模型等价于不感知长度的普通 FFN;之后才逐渐学习各长度区间需要多保守。
长度为什么如此重要?错误删除 3 行对 5 行响应可能是灾难性的,但对 300 行响应往往影响很小。换言之,keep/prune 的损失不是只由单行内容决定,还与整份输出的长度有关。消融实验也显示,长度嵌入几乎不改变总体 F1,却能提高 skeleton 的可用性评分,说明它主要改变的是 错误落在哪里,而不是简单增加正确行数。
4.2 Per-Token FFN
增强后的隐藏状态进入逐 token 分类器:
LayerNorm(d)
  → Linear(d, d) → GELU → Dropout(0.4)
  → Linear(d, d) → GELU → Dropout(0.4)
  → Linear(d, 1)
数学上写为:
$$ z_i=f_\theta(\tilde{\mathbf h}_i), \qquad p_i=\sigma(z_i). $$其中 \(p_i\) 是第 \(i\) 个 token 的保留概率。主要参数来自两个 \(d\times d\) 的线性层,所以 head 大小近似随 \(2d^2\) 增长,需要针对不同 hidden size 重新调整。论文的 MiMo in-engine 配置报告约 18M 参数;相比数百亿或数千亿参数的 MoE backbone,它仍然很小。
4.3 从 Token 概率到行级决策
默认阈值为 \(\tau=0.5\)。系统先把每个 token 二值化,再对一行中的 token 做多数投票:
$$ \hat y_\ell= \mathbb I\left[ \frac{1}{\lvert T_\ell\rvert} \sum_{i\in T_\ell} \mathbb I[p_i>\tau] \gt \frac{1}{2} \right]. $$若 \(\hat y_\ell=1\) 就保留第 \(\ell\) 行,否则删除。多数投票与“先平均概率再过阈值”并不完全等价:前者关心有多少 token 越过决策边界,而不是少量极高分 token 能否拉高整行均值。
训练时,逐行标注会展开为逐 token 标签;推理时再聚合回行级。这样既能直接利用每个 token 的隐藏状态,又保持输出的行粒度。官方实现还会填回两个保留行之间仅隔一行的 single-line gap,减少孤立代码碎片;这是实用后处理,不改变论文的主要学习目标。
5. Training Corpus and Annotation
5.1 数据不是独立代码片段,而是真实 Agent 步骤
最终训练集包含 6,252 条去重 trajectory、22,609 个样本。一个样本不是单个文件,而是一次完整的:
$$ (\text{history},\text{tool call},\text{tool response},\text{next turn}). $$各数据源如下:
| 数据源 | Trajectories | Samples | 占比 |
|---|---|---|---|
| few-sh/terminal-wrench-trajectories | 3,349 | 6,848 | 30.3% |
| TIGER-Lab/SWE-Next-SFT-Trajectories | 899 | 6,632 | 29.3% |
| ByteDance-Seed/Multi-SWE-bench_trajs | 872 | 3,760 | 16.6% |
| zai-org/CC-Bench-trajectories | 280 | 3,074 | 13.6% |
| AweAI-Team/Scale-SWE-Distilled | 852 | 2,295 | 10.2% |
| Total | 6,252 | 22,609 | 100% |
其中四类主要是代码修改轨迹,terminal-wrench 则包含数据库、机器学习、密码学、调度等多样化 CLI/终端任务。这样做是为了让 head 不只会处理 Python 源码,也能看到目录列表、命令输出、日志和自然语言记录。
5.2 解析、过滤与多样性采样
不同来源先被统一为 OpenAI tool-calling 消息格式。系统为每个 tool message 提取一个四元组,历史窗口只保留完整的 assistant/tool 配对;如果空间不够,就丢掉整个旧配对,而不是从中间截断 tool_calls。
轻量预过滤会去掉:少于两行有效内容的响应、代码行比例异常低的响应,以及纯 stack trace 输出。随后,系统根据语言、仓库、响应长度 bucket 和对数 step 距离构造 facility-location 目标,从较大的候选池中贪心选出 50K 个多样样本。这个次模选择过程具有标准的 \((1-1/e)\) 近似保证,目的是避免标注预算被少量仓库或相似连续步骤占满。
5.3 Claude 如何定义“该保留的行”
Claude Sonnet 4.6 会看到完整 history、触发工具调用、带外层行号的工具响应,以及 Agent 接下来做什么。它被要求保留:
- Agent 下一步直接使用、编辑或推理的行;
- 函数、类、条件分支、循环等结构边界;
- 与当前目标有关的 import、变量、类型定义;
- traceback、错误、断言、测试 PASS/FAIL;
- 文件路径、分节标题和帮助定位的输出标记。
应删除的内容包括空行、许可证、无关函数体、重复列表和无关样板。这里使用 next_turn 是一种带后见信息的监督:标注器知道 Agent 随后真正使用了什么;推理时 head 不会看到 future turn,而是学习从当前隐藏状态预测这种未来用途。
约一半候选响应没有任何值得保留的内容,会被自然淘汰。对于无法可靠指出具体删除行、但整体结构将被后续复用的响应,标注器给出 skeleton 置信状态,并把所有 token 标为 keep。这类“不要剪”样本约占最终语料的 17%,用于阻止 head 无条件追求高压缩率。
标注后还会人工移除数百个明显错误样本,例如混淆 cat -n 内部行号与标注器外层行号、非平凡响应却产生空 keep set,以及损坏的 instance_id。
5.4 数据分布意味着什么
最终响应平均 76 行、中位数 56 行;10/90/99 分位分别为 25/143/294 行,最大 465 行。Claude 标注的 keep ratio 均值为 0.32、中位数为 0.23。
语言构成中,Python 占 39.5%,Bash 主导任务占 13.6%,混合 CLI 占 30.3%;C、C++、Java、JavaScript、TypeScript、Go 合计约 17%。因此论文虽不是纯 Python 数据,但 Python 与 CLI/shell 风格内容合计约 83%,对更多语言生态的泛化仍需额外验证。
6. Per-Sample Balanced Focal Loss
6.1 为什么普通 BCE 不够
训练语料的平均 keep rate 约为 30%,但不同响应之间的比例差异很大:
- 若 100 行中只保留 3 行,这 3 行通常是最不可替代的信息;
- 若 100 行中保留 90 行,剩下 10 行则是非常明确、可以安全删除的负样本。
普通 BCE 或 corpus-level focal loss 看到的是全局 30% 正类比例,容易把模型训练成接近固定压缩率的分类器,反而淹没每个样本内部最有价值的少数类。
6.2 Token-Level Focal Term
对标签 \(y_i\in\{0,1\}\),定义模型分配给正确类别的概率:
$$ p_{t,i}= \begin{cases} p_i, & y_i=1,\\ 1-p_i, & y_i=0. \end{cases} $$逐 token focal loss 为:
$$ \mathcal L_i^{\mathrm{tok}}= (1-p_{t,i})^\gamma \operatorname{BCE}(p_i,y_i), \qquad \gamma=2. $$当一个 token 已被高置信度正确分类时,\((1-p_{t,i})^\gamma\) 会让它的权重迅速变小;模型于是把更多梯度用于模糊、困难的边界样本。
6.3 在每个响应内部平衡两类
对样本 \(s\) 中的 token 分别按 keep 和 prune 归一化:
$$ \mathcal L_s^{\mathrm{keep}}= \frac{ \sum_i y_i\mathcal L_i^{\mathrm{tok}} }{ \sum_i y_i }, $$$$ \mathcal L_s^{\mathrm{prune}}= \frac{ \sum_i(1-y_i)\mathcal L_i^{\mathrm{tok}} }{ \sum_i(1-y_i) }. $$再让两类拥有相同总权重:
$$ \mathcal L_s= \frac{1}{2}\mathcal L_s^{\mathrm{keep}} +\frac{1}{2}\mathcal L_s^{\mathrm{prune}}. $$最后对一个 batch 的 \(S\) 个样本平均:
$$ \mathcal L= \frac{1}{S} \sum_{s=1}^{S}\mathcal L_s. $$若一个样本只有一种类别,则仅保留存在的分支,并把它的权重设为 1。这样,skeleton 全保留样本仍可正常训练,不会出现除零或人为构造负类。
6.4 训练配置
Backbone 全程冻结。作者先为每个 dataset × backbone 组合一次性提取最后一层 hidden states,并保存为 memory-mapped feature files,此后只读取缓存训练 head。主要配置为:
| 项目 | 设置 |
|---|---|
| Epochs | 10 |
| Optimizer | AdamW |
| \(\beta_1,\beta_2\) | 0.9, 0.999 |
| Peak learning rate | \(3\times10^{-5}\) |
| Warmup | 前 5% updates 线性 warmup |
| Schedule | cosine decay 到 \(1.5\times10^{-5}\) |
| Weight decay | 0 |
| Gradient clipping | max norm 1.0 |
| Dropout | 0.4 |
| Random seed | 42 |
在单个 8×H200 节点上,22,609 个样本的 10 epoch 训练约需 15 分钟。这里的训练效率来自缓存特征,不代表完整 backbone 的在线推理成本只有这个量级。
7. Experiments
7.1 Benchmarks
| Benchmark | 规模 | 任务 | 指标 |
|---|---|---|---|
| SWE-Bench Verified | 500 | 根据真实 GitHub issue 修改仓库并生成 patch | Resolve Rate |
| SWE-QA | 144 | 多轮仓库问答 | GPT-5.4-mini,1–10 分 |
| SWE-QA-Pro | 260 | 带可执行环境的仓库级问答 | GPT-5.4-mini,1–10 分 |
| Oolong | 280 | 长上下文计数与聚合,重构为多轮工具任务 | exact-match accuracy |
SWE-Bench Verified 使用 Mini-SWE-Agent;其余三个 benchmark 使用最小化 bash-only agent。所有轨迹最多 250 轮,超出则终止。
Oolong 原本是单轮长上下文 benchmark,每个样本包含 10K–65K token 的合成长文本和一个计数式问题。作者将长文本放入 Docker 中的只读 data.txt,只给 Agent bash 工具,让它通过多次搜索和聚合自行找到答案。这样可以测试剪枝器是否只适用于代码,还是也能处理自然语言工具输出。
7.2 Agent Backbones
- MiMo-V2-Flash:309B MoE,每 token 激活 15B 参数,混合 sliding-window/global attention,256K context;
- Qwen3-Coder-Next:80B MoE,每 token 激活 3B 参数,为执行反馈与 Agent 场景优化,256K context。
每个 backbone 都需要自己的 pruning head,因为 hidden size 与内部表征空间不同。两者通过修补后的 SGLang 服务。
7.3 Baselines
- No Pruning:完整保留工具输出;
- LLMLingua2:通用 token 压缩;
- Selective Context:基于自信息选择上下文;
- RAG:滑动窗口切块,由
bge-reranker-v2-m3重排; - Self-Prune:使用同一个 Agent backbone 和行级标注 prompt,针对每个工具响应重新生成剪枝结果;
- LongCodeZip:只使用其 function-level coarse compression;
- SWE-Pruner:独立 task-specific pruner + 显式 Goal Hint。
所有方法在相同 backbone 下共享 decoding 参数、Agent harness 和硬件,只替换剪枝模块。
8. Main Results
8.1 Read-Only Multi-Turn Tasks
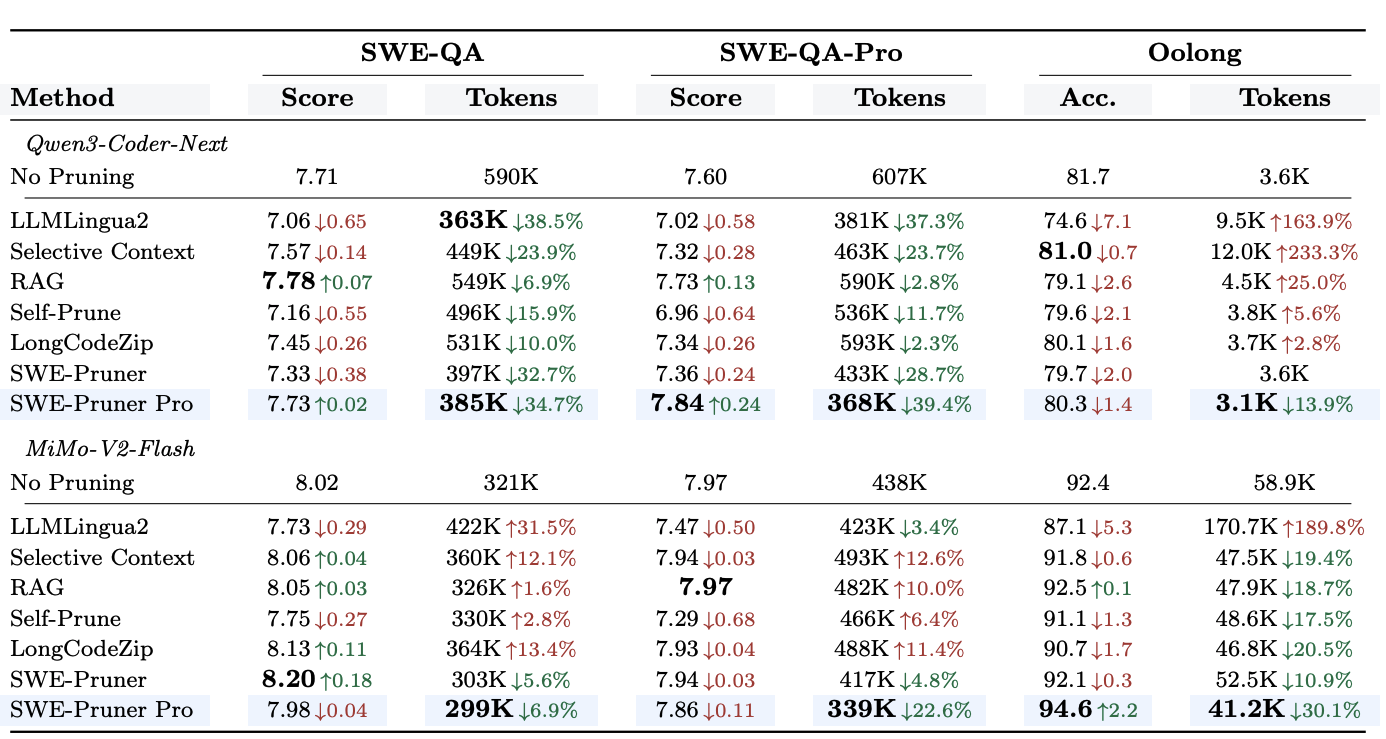
先只抽取 SWE-Pruner Pro 与不剪枝基线,便于看清核心趋势:
| Backbone | Benchmark | No Pruning Quality | Pro Quality | No Pruning Tokens | Pro Tokens | Token Change |
|---|---|---|---|---|---|---|
| Qwen3-Coder-Next | SWE-QA | 7.71 | 7.73 | 590K | 385K | −34.7% |
| Qwen3-Coder-Next | SWE-QA-Pro | 7.60 | 7.84 | 607K | 368K | −39.4% |
| Qwen3-Coder-Next | Oolong | 81.7 | 80.3 | 3.6K | 3.1K | −13.9% |
| MiMo-V2-Flash | SWE-QA | 8.02 | 7.98 | 321K | 299K | −6.9% |
| MiMo-V2-Flash | SWE-QA-Pro | 7.97 | 7.86 | 438K | 339K | −22.6% |
| MiMo-V2-Flash | Oolong | 92.4 | 94.6 | 58.9K | 41.2K | −30.1% |
SWE-Pruner Pro 是唯一在六个单元格中都降低总 prompt + completion token 的剪枝器。最大降幅来自 Qwen3-Coder-Next 的 SWE-QA-Pro:质量从 7.60 升至 7.84,token 减少 39.4%。MiMo 的 Oolong 则同时减少 30.1% token、准确率提高 2.2 个百分点。
完整结果也显示为何必须评价 end-to-end token,而不是只测被剪文本长度。例如 LLMLingua2 在 Qwen 的 Oolong 上令 token 增加 163.9%,在 MiMo 上增加 189.8%;Selective Context 在 Qwen Oolong 上增加 233.3%。剪枝内容可能让 Agent 迷失、重复搜索或产生更多回答,因此局部压缩并不自动等于全轨迹节省。
8.2 SWE-Bench Verified
| Backbone | Method | Resolved | Input Tokens / Trajectory | API Calls / Trajectory |
|---|---|---|---|---|
| MiMo-V2-Flash | No Pruning | 326/500 | 2,971K | 94.8 |
| LongCodeZip | 344/500 (+3.6 pp) | 3,166K (+6.6%) | 99.8 | |
| RAG | 338/500 (+2.4 pp) | 3,391K (+14.1%) | 102.4 | |
| SWE-Pruner | 347/500 (+4.2 pp) | 3,414K (+14.9%) | 103.8 | |
| SWE-Pruner Pro | 345/500 (+3.8 pp) | 3,190K (+7.4%) | 111.8 | |
| Qwen3-Coder-Next | No Pruning | 341/500 | 5,307K | 131.9 |
| LongCodeZip | 288/500 (−10.6 pp) | 4,718K (−11.1%) | 124.7 | |
| RAG | 330/500 (−2.2 pp) | 4,805K (−9.5%) | 126.0 | |
| SWE-Pruner | 320/500 (−4.2 pp) | 4,881K (−8.0%) | 127.1 | |
| SWE-Pruner Pro | 335/500 (−1.2 pp) | 4,590K (−13.5%) | 139.8 |
SWE-Bench 的结果明显依赖 backbone:
- MiMo 上所有剪枝器都提高 Resolve Rate,却也增加输入 token。SWE-Pruner Pro 多解决 19 个问题,即 +3.8 个百分点;其 +7.4% 输入增长大约只有 SWE-Pruner +14.9% 的一半;
- Qwen 上所有剪枝器都降低 Resolve Rate。SWE-Pruner Pro 少解决 6 个问题,但质量损失最小,同时输入 token 降幅最大。
为什么剪掉历史后 API calls 反而会增加?因为这里不是把一条固定轨迹离线缩短,而是让 Agent 在不同历史上重新行动。更紧凑的上下文可能帮助模型继续探索,也可能让它为了找回被删细节而多执行几条命令。因此输入 token 和 API calls 是两个独立效率轴,论文没有把它们强行合成一个分数。
8.3 如何理解“剪枝后质量提高”
剪枝不是给模型增加了新知识,质量提升通常来自两类间接作用:
- 删除早期无关输出,降低 long-context distraction,让当前证据更突出;
- 改变搜索轨迹,使 Agent 执行更多或不同的验证步骤。
但这种变化不是单调收益,也不意味着被删内容一定无用。不同 backbone 的相反趋势说明剪枝策略与模型的探索习惯、工具使用能力和表示空间存在耦合。
9. Ablation Study
作者在同一份 Qwen3-Coder-Next 22K 特征集上训练不同 head,并在 100 个 held-out 样本上同时报告逐行 F1 和 GPT-5.4-mini 的 skeleton 可用性评分。
| Design Axis | Variant | Line F1 | Judge |
|---|---|---|---|
| Loss | BCE | 0.475 | 5.95 |
| Corpus-level Focal | 0.593 | 6.37 | |
| Dice | 0.591 | 5.30 | |
| Tversky | 0.591 | 3.03 | |
| Per-sample balanced focal | 0.635 | 7.08 | |
| Length | Without length embedding | 0.636 | 6.86 |
| With length embedding | 0.635 | 7.08 |
9.1 Loss 消融说明了什么
Per-sample balanced focal 相比 BCE 提高 0.16 F1 和 1.13 judge score,证明类别失衡主要存在于 每个样本内部,而不是只需用一个全局正负权重解决。
Dice 和 Tversky 的 F1 接近普通 Focal,但 judge 显著更低。这说明逐行集合匹配无法完全衡量输出是否能被 Agent 使用。论文附录给出的案例中,BCE 保留了函数参数列表,却删掉解释 reduction semantics 的 docstring 和函数体开头;其逐行 F1 反而较高,但剩余 skeleton 不足以支持正确调用。F1 衡量“是否命中标注行”,judge 更接近衡量“保留下来的结构是否足以继续工作”。
9.2 长度嵌入为什么 F1 几乎没变
加入长度嵌入后 F1 从 0.636 轻微变为 0.635,但 judge 从 6.86 升至 7.08。它没有让错误总数明显减少,而是让错误更多落到长响应中——在那里误删一行的损害更小——同时让短响应保持保守。这正是 length-conditioned risk 的预期作用。
10. Qualitative Behavior
附录展示了 cat、grep、ls 和测试 traceback 四类工具输出。共同模式包括:
- 读取代码时,head 会保留 import、函数签名、调用入口和异常处理,删除许可证与空白;
- 搜索结果中,优先保留与下一步编辑位置有关的文件和符号;
- 目录列表中,真实文件通常被保留,重复的
.、..、total与空分隔行多被删除; - traceback 中,保留
Traceback头、外层调用点、公共入口、真正出错的表达式和最终TypeError,中间低价值 frame 可能被剪掉。
模型的逐行分数通常集中在约 0.4–0.7,而不是饱和在 0 或 1。这说明 head 更像在产生细粒度相对排序,再由 length-aware embedding 调整整份响应的工作点。阈值 0.5 并非在所有响应上对应同一种固定压缩率。
这种行为也揭示了风险:相邻分数可能很接近,一行是否保留会受 tokenization、多数投票和长度 bucket 共同影响。对关键安全检查、精确数值或只出现一次的变量赋值,错误删除仍可能改变最终结果。
11. System Integration and Latency
11.1 隐藏状态复用为何不只是“加一层 MLP”
理论上,head 读取正常 prefill 已经产生的 hidden states,新增计算只有一个很小的 FFN。但生产推理引擎通常围绕 token、KV Cache 和 logits 设计,不会默认把每个 token 的最后一层向量返回给外部服务。作者在 SGLang 0.5.10.post1 的隐藏状态路径上修复了三个问题:
- Batch alignment:混合 batch 中只有部分请求要求 hidden states,返回列表会与 request IDs 错位;
- Chunked prefill accumulation:长 prompt 分块 prefill 时,原实现只保留最后一块的 hidden states;
- Prefix-cache coverage:Radix Cache 复用前缀 KV 后,被跳过的 token 不会重新产生 hidden states,返回 span 可能静默截断。
修补后,48 个不同长度的样本全部与 Transformers reference 形状一致;逐 token cosine similarity 的中位数为 0.997、均值为 0.983。
11.2 Off-Engine Payload
若把 hidden states 发送到独立 pruner process,一个 16K-token、hidden size 2048 的 fp32 张量本体约 128 MiB。若序列化为 JSON 浮点列表,会膨胀至 1–3 GB。论文比较如下:
| 序列化方式 | 单请求 payload |
|---|---|
| fp32 nested JSON list | 1–3 GB text |
| fp32 binary envelope | 170 MiB |
| fp16 binary envelope | 85 MiB |
作者使用 base64 binary envelope,并在服务端转为 fp16,端到端 payload 相比默认路径约降低 20 倍。但即便如此,跨进程搬运 \([T,H]\) 张量仍然昂贵。
11.3 In-Engine Head
更高效的方案是把 head 直接放入 SGLang scheduler 的 GPU 上,让引擎内部将 \([T,H]\) hidden states 转成 \([T]\) logits,只把分数返回。这样消除了跨进程的大张量传输。
在 16 条 MiMo-V2-Flash 轨迹回放上:
- Off-engine 聚合开销为生成时间的 19.3%;
- In-engine 降至 15.0%;
- 每条轨迹的比例中位数为 14.7%,p95 为 34.8%。
剩余开销包括 head forward,以及为了取得目标 span hidden states 而不能完全复用 prefix cache 的 prefill。论文将剪枝调用与紧随其后的生成步骤比较;这不是完整生产服务的绝对延迟保证。更长的 reasoning/decode 会放大分母,使相对剪枝开销下降;反过来,极短生成或频繁工具调用场景中,相对开销会更明显。
In-engine 与 off-engine 也存在工程取舍:前者更快,但修改推理引擎 schema,并把部署绑定到特定 head 架构;后者把 pruner 当成独立服务,通用性更好,却要承担张量传输成本。
12. SWE-Pruner vs. SWE-Pruner Pro
| 维度 | SWE-Pruner | SWE-Pruner Pro |
|---|---|---|
| 剪枝信号来源 | 独立 neural skimmer | Agent 自身最后一层 hidden states |
| 任务意图 | 每轮显式 Goal Hint | 隐含在当前 Agent 表征中 |
| 额外大模型前向 | 需要独立 scorer | 不对原始 \(r_t\) 额外跑 backbone |
| 决策粒度 | 行级、结构化分类 | token 评分后行内多数投票 |
| 训练对象 | 独立小模型 | 每个 backbone 对应一个轻量 head |
| 对主 Agent 的依赖 | 相对解耦 | 强耦合,需要 hidden-state access |
| 部署难点 | 多一个模型和 Goal Hint 协议 | 修改 serving engine、处理 hidden states |
“Pro”并不是简单地把原方法换成更大的模型,而是把 pruning 从 Agent 外部搬到内部。它取消了显式 Goal Hint 和独立 scorer,却换来了对开放权重、内部表示和推理引擎的更强依赖。
13. Limitations and Applicability
13.1 论文明确给出的限制
- 只能用于可访问隐藏状态的模型。 当前实验全部是开放权重模型,闭源 API 通常不返回最后一层 hidden states;
- 每个 backbone 都要重新训练 head。 不同模型的 hidden size 和表示空间不同,不能假设一个 checkpoint 直接迁移;
- 代码 benchmark 偏 Python。 Python 与 CLI/shell 风格数据约占训练集 83%,更多语言仍需验证;
- 激进阈值可能损伤任务质量。 论文建议在安全关键部署中逐 backbone 验证,不能把 benchmark 平均结果当作可靠性保证。
13.2 从方法设计还能看到的边界
- 标注来自 Claude Sonnet 4.6,并使用 next turn 作为监督依据,因此 head 学到的是标注器定义、且与训练轨迹行为一致的“有用性”;若部署 Agent 的策略明显不同,标签分布可能漂移;
- 行级剪枝保护局部文本完整性,但不保证 AST、缩进块和跨行表达式完整;
- 8 个长度 bucket 只提供粗粒度全局校准,不能显式区分“300 行重复日志”和“300 行每行都重要的配置”;
- 固定默认阈值 0.5 不一定适合所有风险等级;保守阈值、关键工具白名单和允许重新读取原始输出是实际系统中值得加入的保护机制;
- 论文结果表明剪枝会改变 Agent 的探索行为,所以离线 F1、局部压缩率和固定轨迹 replay 都不能替代完整的交互式评测。
13.3 更适合与不适合的场景
SWE-Pruner Pro 更适合:开放权重 Agent、大量多行 cat/grep/ls/test 输出、长轨迹、高重复上下文,以及允许 Agent 重新读取文件的可恢复环境。
它不太适合:仅提供闭源 API 的模型、单轮短上下文任务、工具输出本来就很短、每行都不可恢复的安全关键记录,以及不能修改 serving engine 的托管部署。
14. End-to-End Algorithm
把整套方法压缩成可执行逻辑如下:
Input:
  history H_(t-1)
  tool call c_t
  raw tool response r_t with N lines
  frozen agent backbone
  pruning head f_theta
  threshold tau = 0.5

1. Prefill [H_(t-1), c_t, r_t]
   - reuse the cached prefix [H_(t-1), c_t]
   - collect last-layer hidden states only for r_t

2. Map N into one of 8 logarithmic line-count buckets
3. Add the corresponding length embedding to every response-token state
4. Run the FFN head and obtain per-token keep probabilities
5. Threshold every token at tau
6. Keep a line when more than half of its tokens vote keep
7. Preserve the kept lines and their original ordering/line numbers
8. Let the current generation attend to the full r_t
9. Replace r_t with the pruned response r_t_tilde in next-turn history
10. Re-forward the shorter r_t_tilde to rebuild a consistent KV cache
从计算路径看,SWE-Pruner Pro 节省的是一个独立 scorer 的前向与 Goal Hint 生成;从信息路径看,它把“当前任务需要什么”的判断从显式自然语言 query,改成了 Agent hidden states 中的隐式状态。
15. Conclusion
SWE-Pruner Pro 最重要的贡献不是某个新的压缩率,而是重新定位了 pruning signal:工具输出已经被 Agent 读过一次,Agent 的内部表示也已经根据历史、工具调用与当前响应形成了相关性判断;上下文管理系统可以学习读取这个判断,而不必在外围再搭一个模型重新推断。
论文用线性 probe 证明信号可解码,再用非线性 FFN、长度感知嵌入和 per-sample balanced focal loss把它变成实际的行级剪枝器。实验说明该方法在多轮只读任务上能稳定降低端到端 token,并在部分设置中提升质量;同时,SWE-Bench 上的 backbone 差异、API calls 增加和 15% 左右的系统开销也说明它并不是“免费压缩”。
因此,这篇工作的完整结论应当是:Coding Agent 确实已经知道哪些工具输出更重要,但把这种隐式知识可靠地转化为长期上下文管理,仍需要按模型训练、系统级隐藏状态支持,以及端到端交互评测。