VLASH: Real-Time VLAs via Future-State-Aware Asynchronous Inference
Status: Preprint, arXiv v2 (2026-07-26)
Paper: https://arxiv.org/abs/2512.01031
GitHub: https://github.com/mit-han-lab/vlash
一句话总结: VLASH 不再让 VLA 根据“开始推理时已经过期的机器人状态”规划动作,而是利用上一段已经确定的动作,把机器人状态前推到新动作真正开始执行的时刻;再用时间偏移数据增强教会模型理解这一未来状态,从而在不增加推理步骤的前提下实现稳定的异步控制。
My Thoughts
这篇工作的关键并不是让 VLA 的一次 forward 更快,而是重新安排 推理与物理执行的时间关系。
同步控制将模型延迟直接暴露为机器人停顿;朴素异步控制虽然把推理藏在动作执行之后,却让模型对着过去的状态预测未来要执行的动作。VLASH 的洞察是:未来环境画面确实未知,但在推理期间将要执行的动作已经由上一 action chunk 确定,因此未来的本体状态(proprioceptive state)是可以近似推演的。
我认为这篇论文最值得把握的有三点:
- 异步不是简单地开两个线程。 如果不处理 prediction-execution misalignment,吞吐和响应变快并不等于闭环控制更好。
- VLASH 只预测可预测的未来。 它不构建完整 world model,只前推由已知动作决定的机器人自身状态,因此部署开销非常小。
- 反应速度与任务完成速度是两个指标。 异步执行主要把最大反应延迟从 \(D+2L\) 降到 \(2L\);动作量化才进一步缩短物理动作序列,使任务完成时间获得约 \(1.5\text{--}2.0\times\) 加速。
1. Motivation:VLA 为什么看起来总是“慢半拍”?
Vision-Language-Action Model(VLA)根据视觉观测、语言指令和机器人状态生成低层动作。为了避免每个控制周期都运行一次大模型,现代 VLA 通常采用 action chunking:一次推理生成一段未来动作,然后连续执行其中若干步。
设时刻 \(t\) 的环境观测为 \(o_t\),机器人状态为 \(s_t\),VLA policy 为
$$ \pi_\theta(A_t\mid o_t,s_t), $$一次生成长度为 \(H\) 的动作块
$$ A_t=[a_t,a_{t+1},\ldots,a_{t+H-1}], $$其中 \(H\) 是 prediction horizon。实际部署时通常只执行前 \(K\le H\) 步,再根据新观测重新推理;\(K\) 称为 execution horizon。
1.1 同步推理:准确,但会停顿
同步流程严格串行:
获取观测 → VLA 推理 → 执行 K 步动作 → 再获取观测 → 下一次推理
如果一次推理耗时为 \(L\),机器人在推理期间没有新动作可执行,就会出现明显的 stop-and-go:动作块之间停顿,机械臂运动不连续;更严重的是,机器人执行旧动作块时也不会持续感知环境,因此很难及时响应突然移动的物体。
1.2 朴素异步推理:不停顿,但时间对不上
异步流程让两件事并行:机器人继续执行上一动作块,VLA 同时生成下一动作块。这样模型推理可以被物理执行时间隐藏,但引入了论文真正要解决的问题——预测区间与执行区间错位。
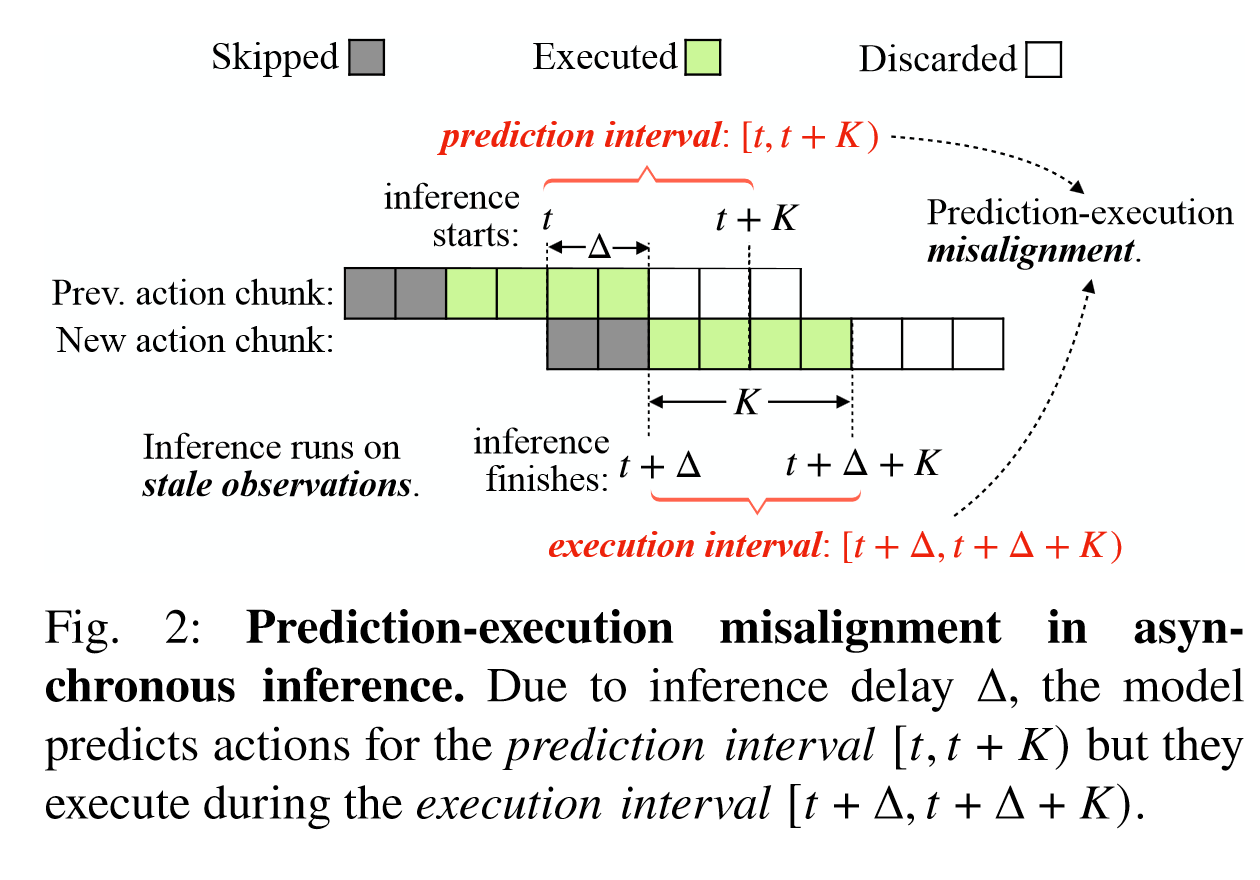
模型在 \(t\) 时刻开始推理,希望前 \(K\) 个动作作用于
$$ I_t^{\mathrm{pred}}=[t,t+K). $$若推理延迟相当于 \(\Delta\) 个控制步,新动作真正开始执行的区间却是
$$ I_t^{\mathrm{exec}}=[t+\Delta,t+\Delta+K). $$也就是说,模型根据 \((o_t,s_t)\) 生成的动作本来未必错误,但这些动作到 \(t+\Delta\) 才被采用。此时机器人已经继续执行了上一动作块,状态从 \(s_t\) 变成 \(s_{t+\Delta}\);环境也可能发生变化。将面向旧状态的动作硬切换到新状态上,会产生轨迹跳变、振荡和控制精度下降。
异步推理的核心矛盾不是“动作算得慢”,而是“动作针对的时间段”和“动作实际生效的时间段”不同。
2. VLASH 的核心:Future-State Awareness
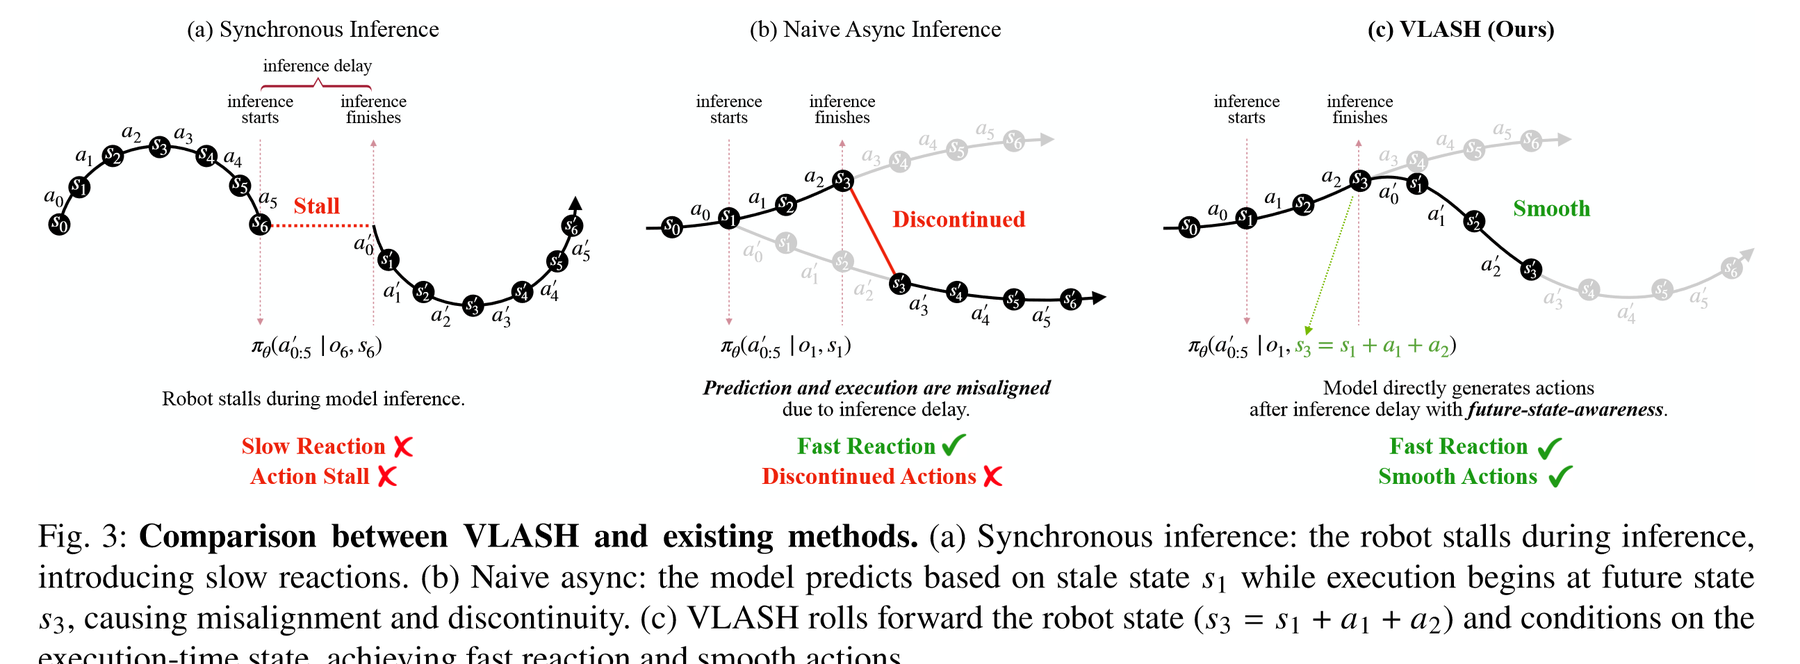
图 3 对比了三种执行方式:
- Synchronous Inference: 新动作与状态对齐,但推理时机器人停顿,反应慢。
- Naive Async: 机器人持续运动、反应更快,但新动作仍根据旧状态 \(s_1\) 预测,在未来状态 \(s_3\) 执行时发生不连续。
- VLASH: 在推理开始时就把状态从 \(s_1\) 前推到 \(s_3\),让模型直接为执行时刻规划动作,因此兼顾连续运动与快速反应。
2.1 理想输入与现实中可获得的输入
严格来说,要在 \(t+\Delta\) 开始执行一段动作,理想 policy 应当使用
$$ \pi_\theta(A_{t+\Delta}\mid o_{t+\Delta},s_{t+\Delta}). $$但是推理开始于 \(t\),未来观测 \(o_{t+\Delta}\) 尚未发生,无法直接获得。VLASH 不尝试预测完整未来环境,而是注意到:推理期间机器人仍在执行上一动作块,且这段即将执行的动作已经确定。因此,可以用当前状态和这些 committed actions 估计执行时状态。
对于 delta action,状态前推可写为
$$ \hat{s}_{t+\Delta} =s_t+\sum_{i=0}^{\Delta-1}a_{t+i}. $$对于 absolute action,不需要累加,待执行序列的最后一个绝对目标可以直接作为未来状态估计。于是 VLASH 实际使用
$$ \pi_\theta(A_{t+\Delta}\mid o_t,\hat{s}_{t+\Delta}). $$视觉仍然是稍旧的 \(o_t\),但机器人的自身状态已经与新动作的执行起点对齐。论文将其类比为人类存在反应延迟时的行为:视觉信息可能略有滞后,但我们会根据身体正在进行的动作预判动作真正生效时的姿态。
2.2 为什么这个估计几乎没有运行时开销?
VLASH 的状态前推只使用上一动作块中已经生成、即将执行的动作,不需要:
- 再运行一个 world model;
- 对新动作做额外 denoising / inpainting;
- 增加 correction head;
- 修改 VLA 的标准推理循环。
因此它的额外计算基本只是动作累加或读取最后一个绝对动作。与 RTC 在推理时冻结一部分动作并重新 inpaint 余下动作相比,VLASH 不会因为修正动作而扩大模型延迟 \(L\)。
3. 只在推理时换成未来状态为什么不够?
论文发现,现有 VLA 虽然同时接收图像与 robot state,但实践中往往更依赖视觉信息,没有充分利用本体状态。如果训练时模型只见过 \((o_t,s_t)\rightarrow A_t\),部署时突然将状态换成 \(s_{t+\Delta}\),模型未必理解这个输入代表“同一幅旧画面下,机器人已经运动到未来位置”。
因此,VLASH 不是纯 inference-time trick,而是在下游 fine-tuning 阶段加入 temporal-offset augmentation。
3.1 状态与动作一起偏移
给定演示轨迹 \(\{(o_t,s_t,a_t)\}\),从范围
$$ \delta\in\{0,1,\ldots,\Delta_{\max}\} $$中采样一个时间偏移,并构造
$$ (o_t,s_{t+\delta}) \longrightarrow A_{t+\delta} =[a_{t+\delta},\ldots,a_{t+\delta+H-1}]. $$这里有两个缺一不可的操作:
- State 与 target action 同时向后偏移。 模型学习从未来状态开始应该继续执行什么动作。
- Observation 保持为 \(o_t\)。 同一幅图像会对应多个不同状态和不同正确动作,迫使模型不能只记视觉模式,而必须读取 robot state。
训练多个 \(\delta\) 而不是固定一个延迟,是因为相同 VLA 可能部署在不同 GPU、不同推理优化和不同控制频率下,对应的 \(\Delta\) 不同。部署时选择能够覆盖实测推理延迟的最小 offset,使模型在同步模式(\(\delta=0\))和多种异步延迟下都能工作。
3.2 Shared Observation:一次编码,多组 offset
朴素实现会把每个 \((o_t,s_{t+\delta},A_{t+\delta})\) 当成独立样本,反复编码完全相同的图像。视觉 token 恰恰是 VLA 输入中最昂贵的部分,因此论文提出 shared-observation fine-tuning。
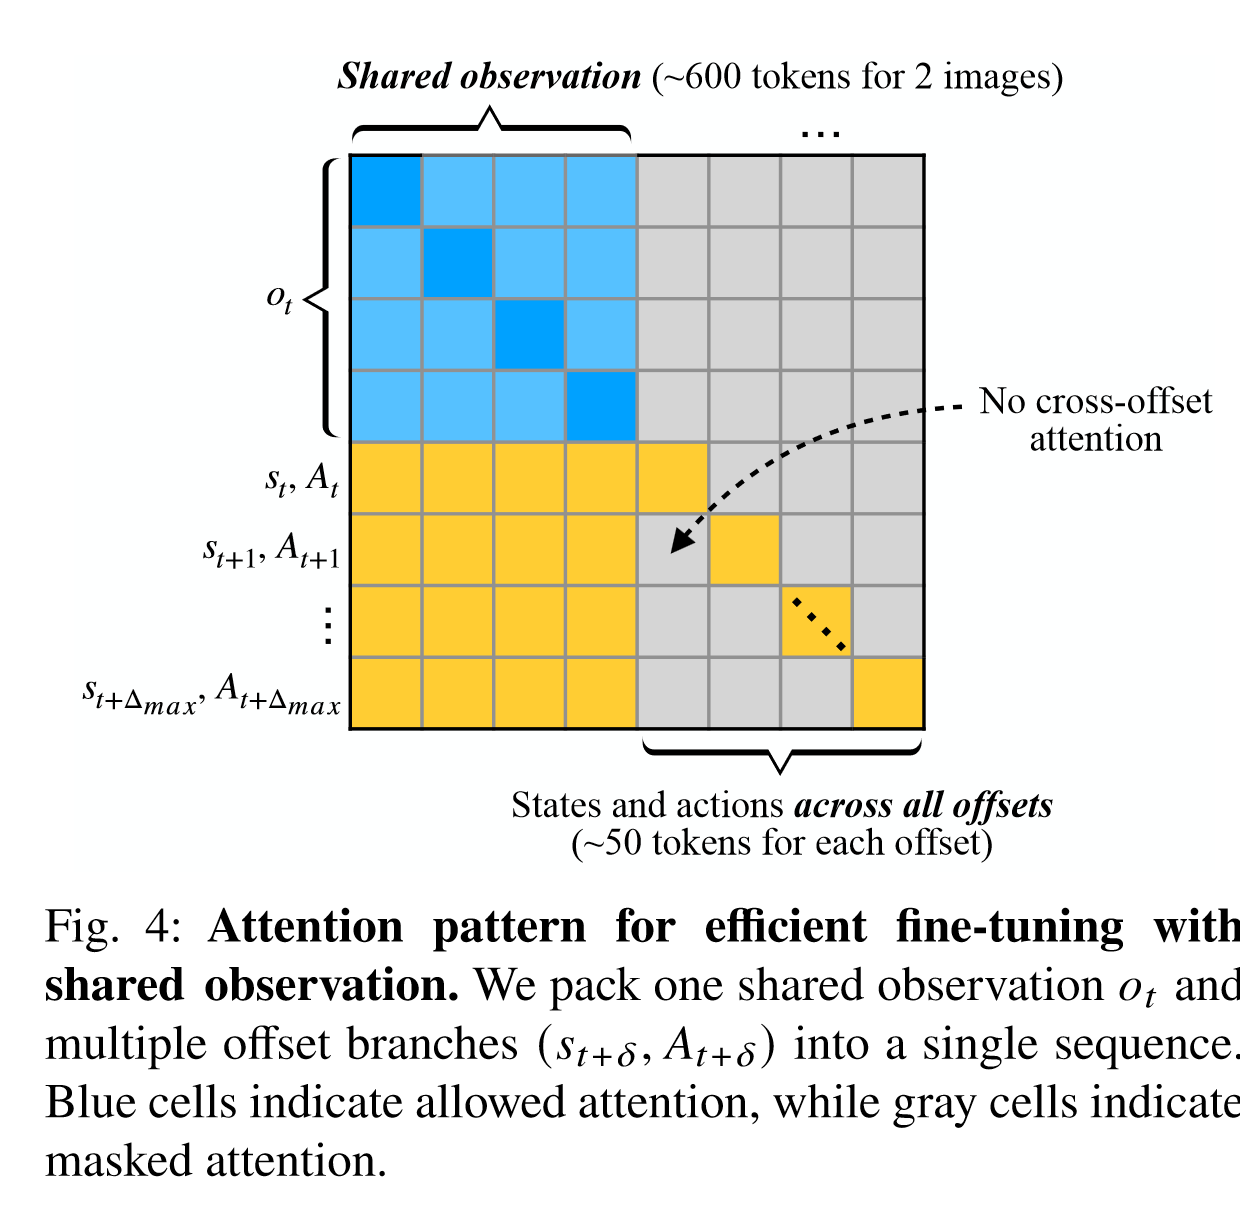
作者将一个共享 observation 和全部 offset branch 打包为一个序列:
$$ [o_t,(s_t,A_t),(s_{t+1},A_{t+1}),\ldots, (s_{t+\Delta_{\max}},A_{t+\Delta_{\max}})]. $$再使用 block-sparse attention mask:
- observation token 之间可以相互 attention;
- 每个 offset branch 可以 attention 到共享 observation 和本 branch 内的 token;
- 不同 offset branch 之间禁止相互 attention,防止未来分支泄漏信息;
- 所有 branch 的 state-action positional encoding 从同一位置开始,使每个分支在模型看来都等价于一条独立训练样本。
以 \(\pi_{0.5}\) 为例,一组双视角图像和语言约有 600 个 observation token,一个 state-action branch 约有 50 个 token。打包 \(N_\delta=5\) 个 offset 时,总长度仅从约 650 增至 850(约增加 31%),却相当于同时训练 5 条 offset trajectory,并且视觉只编码一次。
需要注意:这不是“训练完全免费”。offset augmentation 仍可能需要更多 step 才收敛;shared observation 解决的是每一步中的重复视觉计算。
4. 完整异步执行流程
VLASH 的一次在线控制循环可以概括为:
1. 在时刻 t 采集当前观测 o_t 和当前机器人状态 s_t
2. 机器人继续执行上一 action chunk 中已提交的动作
3. 根据实测推理延迟 Δ,取出推理期间预计会执行的动作前缀
4. 用该动作前缀把 s_t 前推为执行时状态 ŝ_{t+Δ}
5. VLA 根据 (o_t, ŝ_{t+Δ}) 在后台生成下一 action chunk
6. 推理完成后切换到新 chunk;与此同时立即开始下一轮感知与推理
这个流程有两个关键前提:
- 旧 chunk 在推理期间不会消失。 它既维持机器人连续运动,也提供状态前推所需的已知动作。
- 推理持续 back-to-back 运行。 新环境变化可以在下一次推理开始时被看到,而不用等整段旧 chunk 执行结束。
与相关方案的差异
| 方法 | 推理期间是否停顿 | 是否处理时间错位 | 额外推理开销 | 架构改动 | 需要训练适配 |
|---|---|---|---|---|---|
| Sync | 是 | 天然对齐 | 无 | 无 | 否 |
| Naive Async | 否 | 否 | 无 | 无 | 否 |
| RTC | 否 | 冻结确定动作并 inpaint 其余动作 | 有 | 通常无 | 否 |
| A2C2 | 否 | 用额外 correction head 修正 | 有 | 有 | 是 |
| VLASH | 否 | 用已提交动作前推执行时状态 | 近似无 | 方法本身不要求 | 是 |
论文还讨论了一个实现细节:\(\pi_{0.5}\) 原始设计把数值状态转为文本 token,这会破坏数值的连续结构。VLASH 本身可以不改架构直接工作,但真实机器人实验额外使用了轻量 state projection,将连续状态映射为 embedding;附录认为这是可选增强,用于进一步改善平滑性,而不是 future-state awareness 的必要组成。
5. Action Quantization:加速的是物理执行,不是模型计算
异步控制把 VLA 推理隐藏在动作执行背后之后,新的瓶颈变成了:机器人执行完整细粒度动作序列仍然需要较长时间。为此论文采用 action quantization。
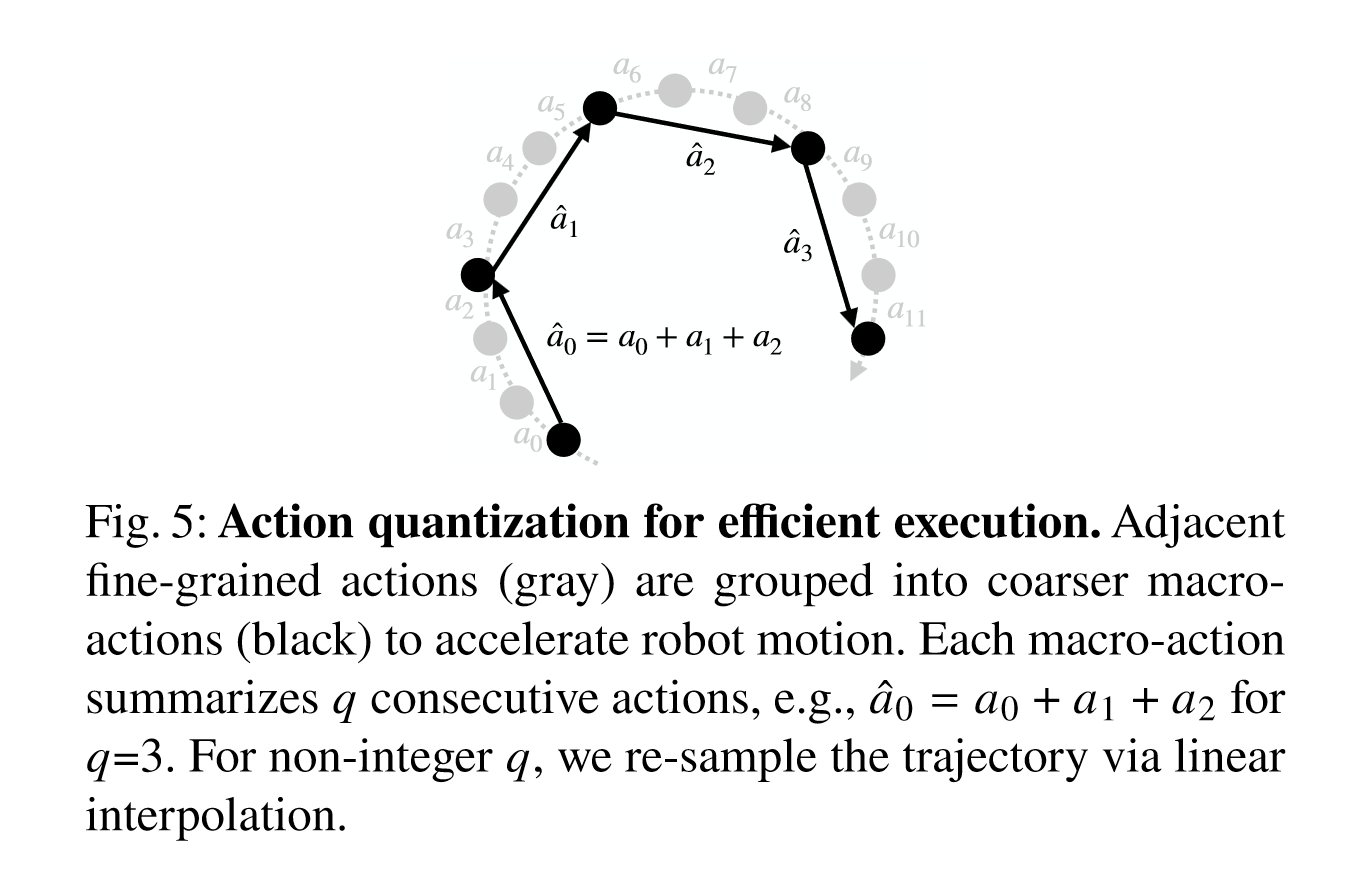
这里的 quantization 不是权重 INT8/INT4 量化,而是把连续 \(q\) 个细粒度动作合并为一个 macro-action。对 delta action,若 \(q=3\),则
$$ \hat{a}_0=a_0+a_1+a_2. $$机器人用一步从 \(a_0\) 的起点移动到 \(a_2\) 的终点,从而缩短动作序列。非整数 \(q\) 则通过线性插值将原轨迹重采样为更短序列。
这提供了一个直接的 speed-accuracy trade-off:
- \(q\) 越大,物理运动越快,任务完成时间越短;
- 动作越粗,精细操作、碰撞规避和闭环修正能力越容易下降;
- 因此 \(q\) 必须按任务精度要求选择,堆叠通常比简单 pick-and-place 更保守。
实验中,能够保持精度的 \(q\in[1.5,2]\) 带来约 \(1.5\text{--}2.0\times\) 的任务完成加速。这个数字与后文最高 \(11.8\times\) 的 reaction latency speedup 不是同一个概念。
6. Experiments
论文从五个角度回答问题:
- VLASH 能否在模拟动态任务中抵抗更大的 inference delay?
- 它能否跨 \(\pi_{0.5}\)、SmolVLA、GR00T N1.6 泛化?
- 在真实机械臂的一般操作任务中,异步与动作量化是否损害成功率?
- 它是否真的能降低反应延迟,并完成同步 VLA 无法完成的动态任务?
- shared-observation fine-tuning 能节省多少训练计算?
6.1 Kinetix:延迟越大,future state 越重要
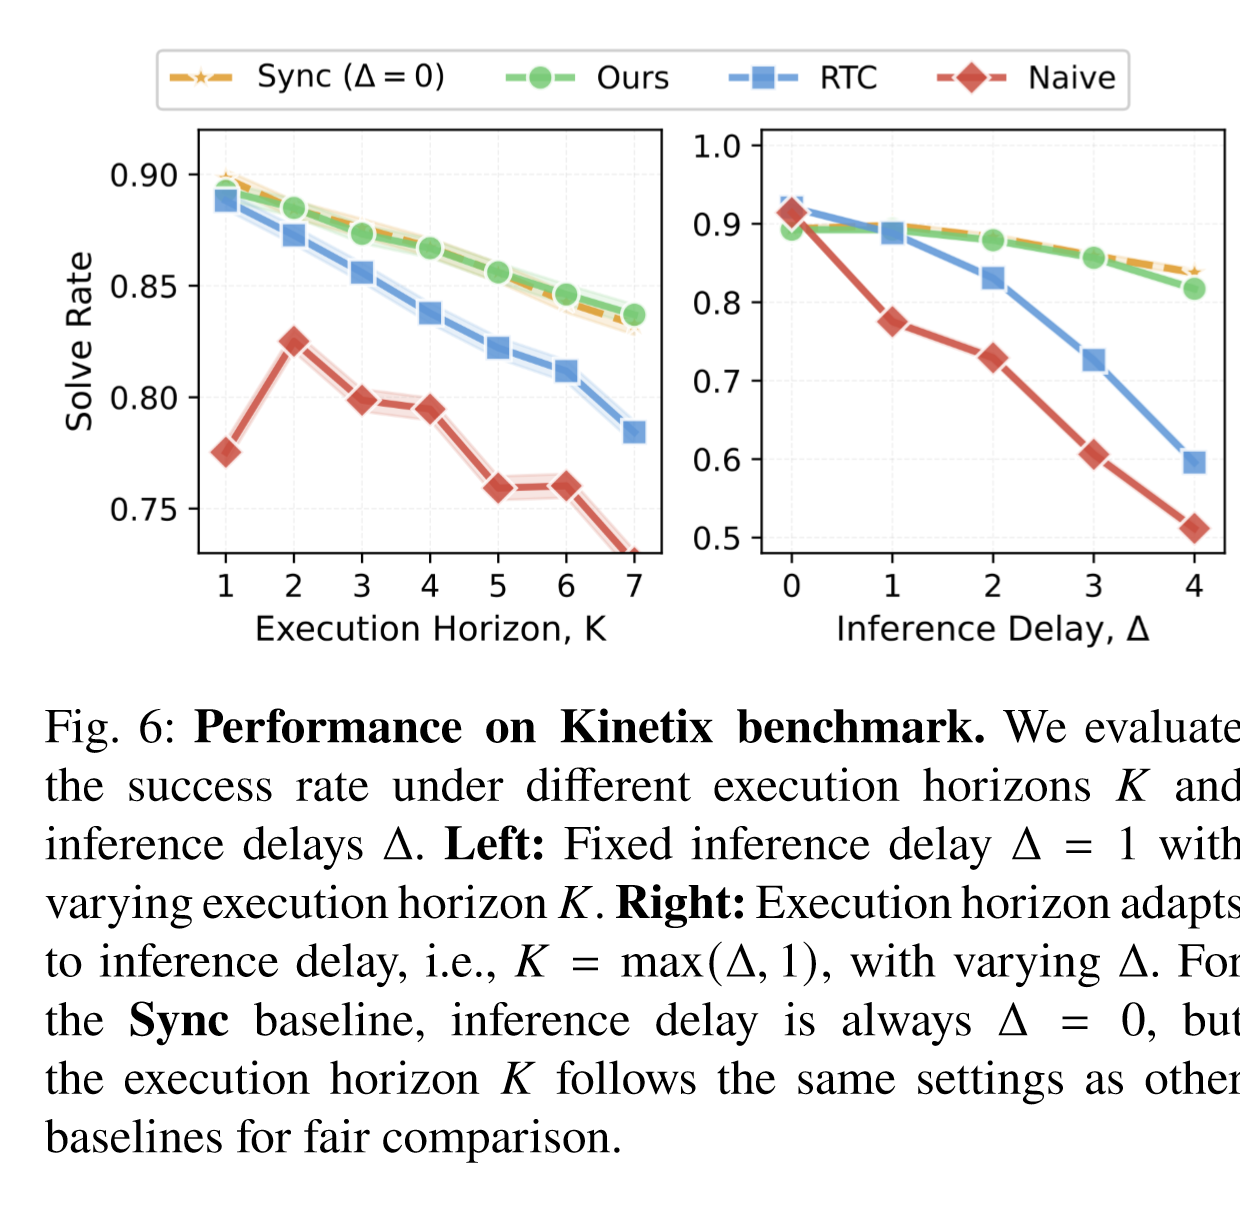
Kinetix 是包含投掷、接取、平衡等快速动态控制的模拟 benchmark。实验训练 prediction horizon \(H=8\) 的 4-layer MLP-Mixer action-chunking policy,在 12 个任务上每个数据点运行 1,024 次 rollout,模拟 \(0\text{--}4\) 个控制步的推理延迟。
主要结果:
- 固定 \(\Delta=1\)、逐渐增大 execution horizon \(K\) 时,VLASH 始终紧跟同步上界;Naive Async 和 RTC 随 \(K\) 增大下降更明显。
- 令 \(K=\max(\Delta,1)\) 并增大延迟时,Naive Async 很快崩溃,RTC 也明显退化,而 VLASH 保持更稳定。
- 在 \(\Delta=4\) 时,VLASH 成功率为 81.7%,Naive Async 仅为 51.2%,绝对提升 30.5 个百分点。
Kinetix 中的状态前推通过 simulator 执行生成动作实现,而且前推噪声与真实执行噪声独立,因此 \(\hat{s}_{t+\Delta}\) 仍是近似值。结果说明 VLASH 并不要求未来状态完全精确。
6.2 LIBERO:在通用操作任务上保持原始能力
LIBERO 包含 Spatial、Object、Goal、Long 四个子 benchmark,每个包含 10 个任务。论文在 \(\pi_{0.5}\) 和 SmolVLA 上分别 fine-tune 30K steps,batch size 为 32,并设置 \(K=5\)。
| Model | Mode / Delay | Spatial | Object | Goal | Long | Avg. SR |
|---|---|---|---|---|---|---|
| \(\pi_{0.5}\) | Sync / 0 | 97.3 | 99.6 | 96.7 | 93.5 | 96.8 |
| \(\pi_{0.5}\) | VLASH / 1 | 98.8 | 99.2 | 96.7 | 94.4 | 97.2 |
| \(\pi_{0.5}\) | VLASH / 2 | 97.5 | 99.2 | 97.3 | 94.6 | 97.1 |
| \(\pi_{0.5}\) | VLASH / 3 | 94.4 | 98.8 | 93.3 | 91.9 | 94.6 |
| SmolVLA | Sync / 0 | 81.3 | 92.9 | 85.8 | 55.8 | 79.0 |
| SmolVLA | VLASH / 1 | 80.0 | 92.9 | 82.3 | 53.1 | 77.1 |
| SmolVLA | VLASH / 2 | 78.5 | 92.1 | 86.9 | 55.0 | 78.1 |
| SmolVLA | VLASH / 3 | 79.8 | 94.2 | 87.5 | 54.8 | 79.1 |
LIBERO 的环境变化较慢,simulation 中同步执行也不会产生真实机械臂那样的停顿抖动,因此 Sync 是一个很强的上界。即便如此,VLASH 在多个延迟配置下仍接近或略高于同步结果,说明 offset fine-tuning 没有破坏模型原本的一般操作能力。但 \(\pi_{0.5}\) 在 delay 3 时从 96.8 降到 94.6,也表明更旧的视觉输入仍会带来代价。
6.3 真实机器人:准确性与动作量化鲁棒性
论文将 \(\pi_{0.5}\) 和 GR00T N1.6 部署到两种平台:双 7-DoF 的 Galaxea R1 Lite,以及 6-DoF 的 LeRobot SO-101。真实世界任务包括:
- Pick & Place: 抓取随机起点的方块并放入固定盒子;
- Stacking: 将橙色方块堆到蓝色方块上;
- Sorting: 按颜色把两个方块放入左右盒子。
实验在 RTX 5090 笔记本上运行,设置 \(K=24\)、控制频率 30 Hz、推理延迟 2 steps。每个方法、每个任务执行 20 个 rollout,每次最多允许 3 次尝试。
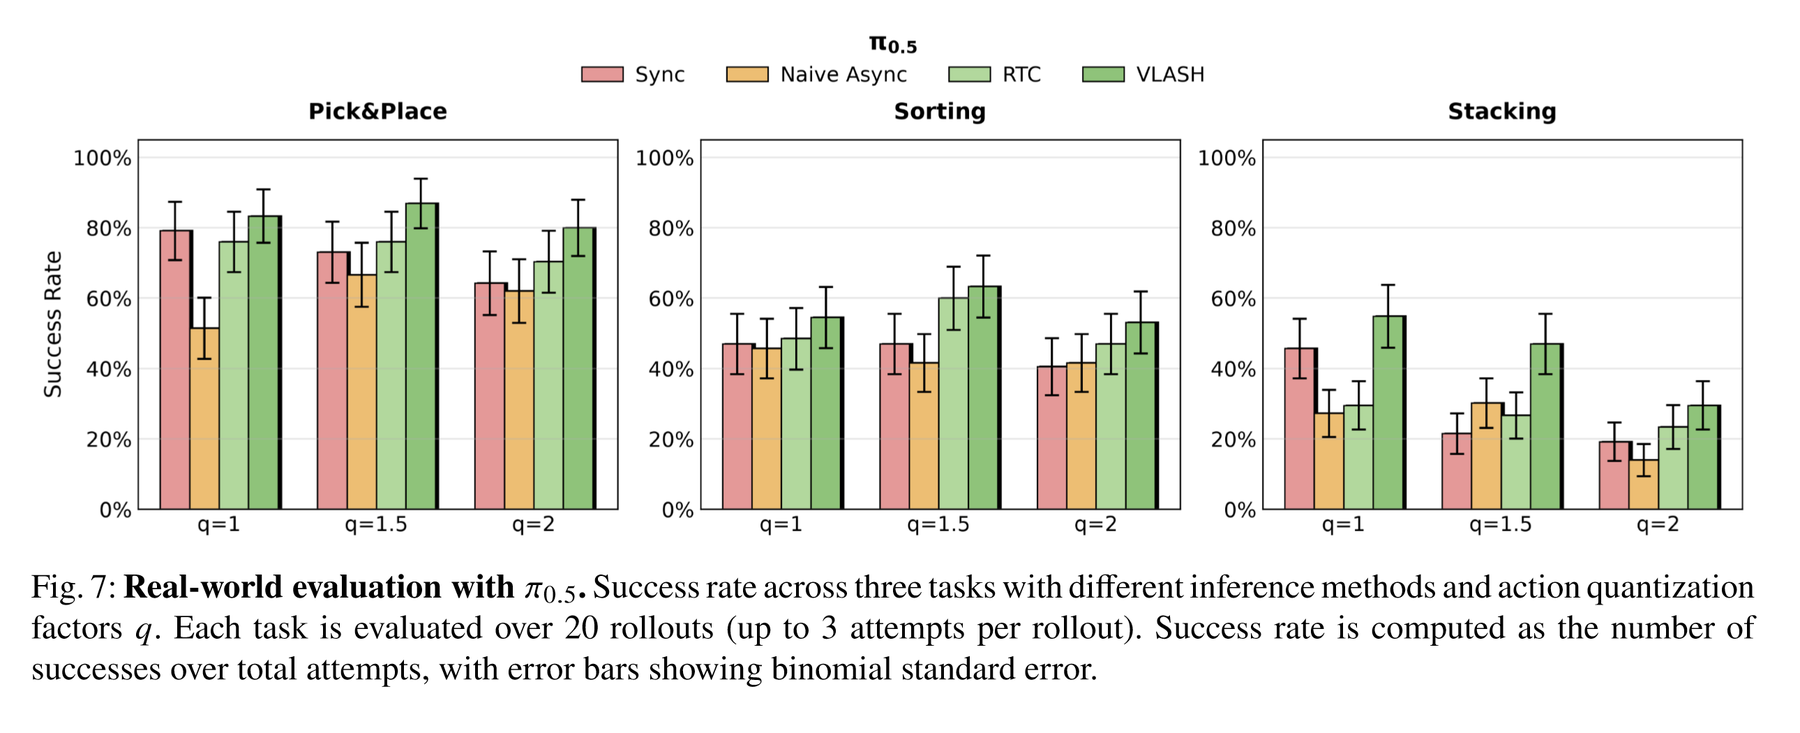
对 \(\pi_{0.5}\),VLASH 在所有任务和量化因子上都取得最高成功率。尤其是:
- Pick & Place 和 Sorting 中,VLASH 在 \(q=2\) 时仍匹配或超过 Sync 在 \(q=1\) 的成功率,相当于在不损失准确率的情况下获得约 \(2\times\) 完成加速;
- 精度要求更高的 Stacking 中,\(q=1.5\) 是更合理的平衡点;
- RTC 的 inference-time inpainting 增大了推理延迟,使其面对更陈旧的状态,因此在多个设置中不如 VLASH。
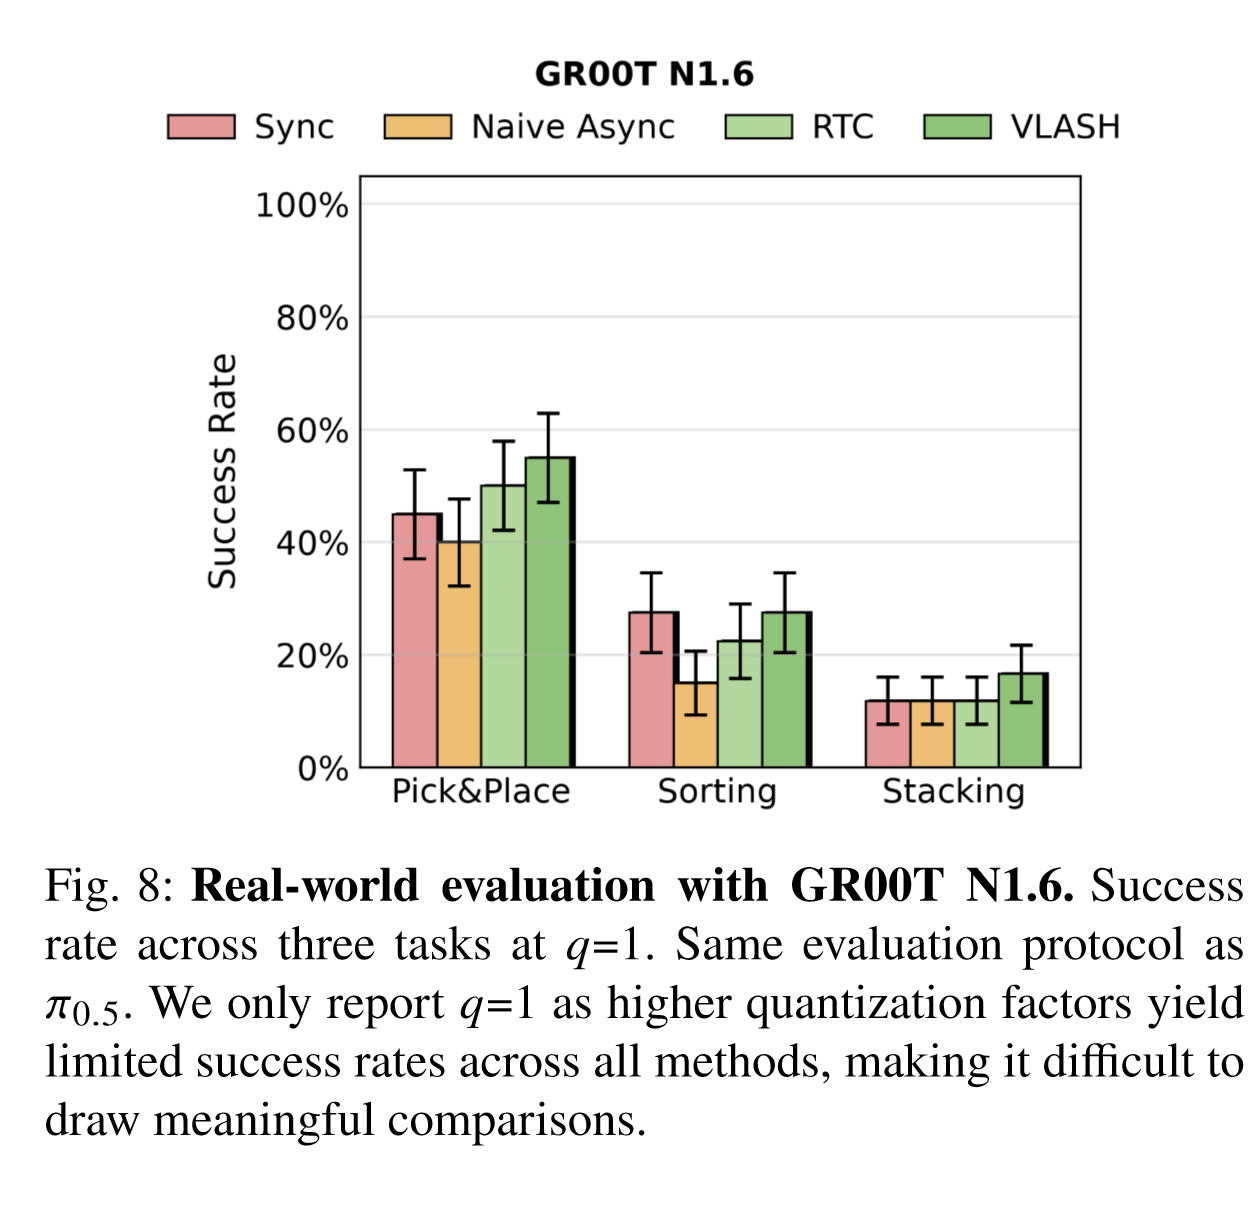
GR00T N1.6 在 \(q=1\) 上呈现相同趋势:VLASH 在三项任务中都优于 Sync、Naive Async 和 RTC。更大的 \(q\) 对所有方法成功率都较低,所以论文没有用这些设置做强行比较。
6.4 Reaction latency:为什么是 \(D+2L\) 对 \(2L\)?
论文将最大反应延迟定义为:环境发生变化后,第一条受该变化影响的动作真正开始执行之前的最坏等待时间。
设一次 inference latency 为 \(L\),一个 action chunk 的执行时间为 \(D\):
-
Sync: 最坏情况下,变化刚好发生在一次观测之后。系统要完成当前推理 \(L\)、执行整段旧 chunk \(D\),再完成下一次推理 \(L\),所以
$$ T_{\mathrm{react}}^{\mathrm{sync}}=D+2L. $$ -
Async: 推理 back-to-back 运行。系统在下一次推理开始时看到变化,并在该次推理完成后切换动作,最坏为
$$ T_{\mathrm{react}}^{\mathrm{async}}=2L. $$
在 \(\pi_{0.5}\)、单图输入、\(K=25\)、50 Hz 控制下,\(D=500\) ms:
| GPU | VLASH / Sync 的 \(L\) | Sync 最大反应延迟 | VLASH 最大反应延迟 | Speedup |
|---|---|---|---|---|
| H100 | 23.2 ms | 546.4 ms | 46.4 ms | 11.8× |
| RTX 5090 | 29.4 ms | 558.8 ms | 58.8 ms | 9.5× |
| RTX 4090 | 32.3 ms | 564.6 ms | 64.6 ms | 8.7× |
RTC 在三张 GPU 上的 inference latency 分别是 48.4、49.6、54.2 ms,约为 VLASH 的 \(1.7\text{--}2.1\times\),说明运行时修补动作会直接侵蚀异步带来的低延迟收益。
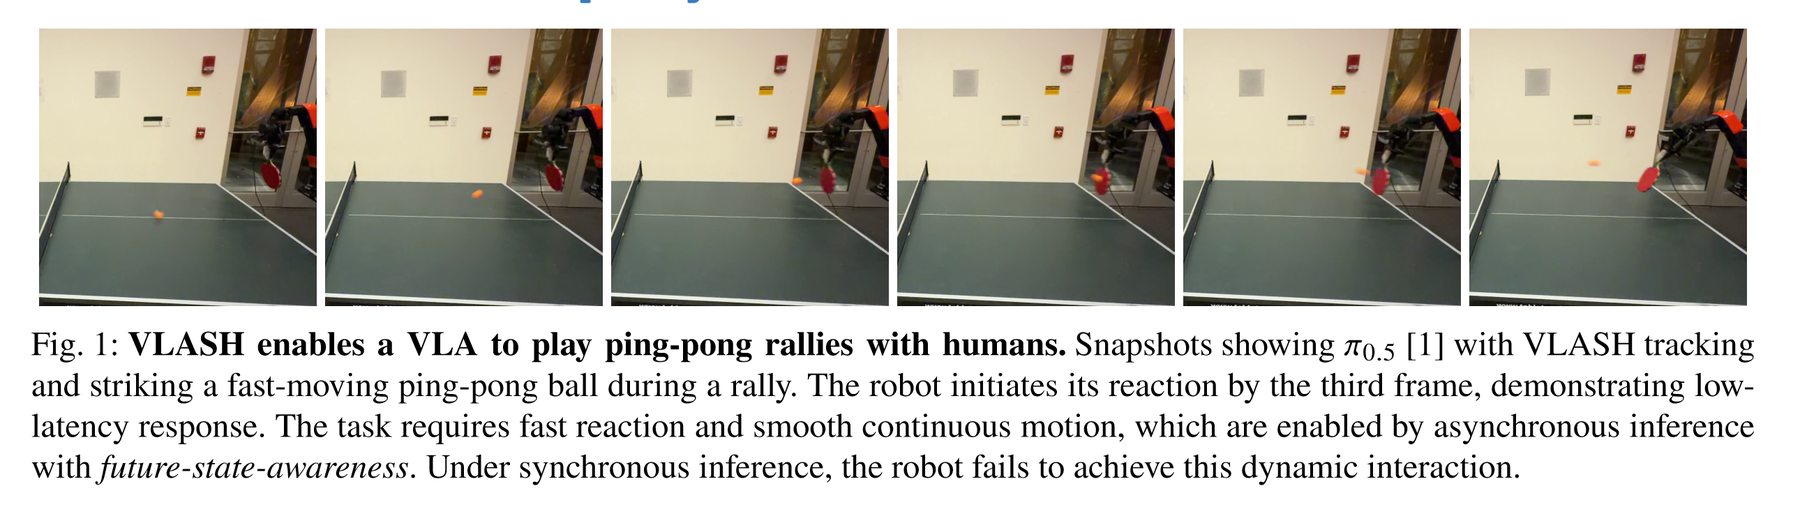
6.5 Ping-Pong 与 Whack-a-Mole:同步控制做不到的任务
两项动态任务都使用 \(\pi_{0.5}\)、RTX 5090 和 \(q=2\):
| Method | Ping-Pong Hit Rate | Whack-a-Mole Avg. Score |
|---|---|---|
| Sync | 0/20(0%) | 3.2 |
| Naive Async | 0/20(0%) | 8.6 |
| RTC | 0/20(0%) | 11.0 |
| VLASH | 11/20(55%) | 28.8 |
这里能看出三个层次:Sync 因反应慢而几乎无法参与动态交互;Naive Async 和 RTC 虽能更频繁感知,但动作错位或额外延迟使控制仍不够准;VLASH 同时具备连续推理、状态对齐和较快物理运动,才真正把 VLA 带入快速交互任务。
6.6 Fine-tuning Efficiency
shared-observation 实验在 4×H100 上用 DDP 训练 \(\pi_{0.5}\)。VLASH 取 \(\Delta_{\max}=3\),每 GPU physical batch 为 4;四个 offset 使 effective batch 为每 GPU 16、全局 64。标准训练则直接使用每 GPU 16 的 physical batch,保证 effective batch 一致。
| Method | Time / Step | 10K | 20K | 30K |
|---|---|---|---|---|
| Original | 420.99 ms | 94.1 | 97.1 | 96.8 |
| VLASH | 129.29 ms | 87.1 | 94.4 | 96.6 |
VLASH 每个 forward-backward step 快 3.26×。它在早期收敛更慢,但 30K 时达到 96.6,接近标准训练的 96.8;而且这里两者都在同步模式下评测,再次说明 offset augmentation 最终不会明显伤害原始同步性能。
7. Limitations 与值得注意的边界
7.1 只对齐了 robot state,没有预测未来环境
VLASH 使用的是 \((o_t,\hat{s}_{t+\Delta})\),而非真正的 \((o_{t+\Delta},s_{t+\Delta})\)。当人、球或障碍物在推理期间快速移动时,视觉依旧陈旧。连续 back-to-back inference 缩短了这种陈旧持续的时间,但没有从根本上预测未来世界。论文也将 world model 视为未来可以结合的方向。
7.2 状态前推依赖动作能够按计划执行
简单累加 delta action 隐含假设:机器人在 \(\Delta\) 内基本按照已提交动作运动。真实系统中的关节滞后、接触、碰撞、控制器饱和或紧急中断都会造成
$$ \hat{s}_{t+\Delta}\ne s_{t+\Delta}. $$Kinetix 的独立噪声实验说明方法对一定误差具有鲁棒性,但更复杂动力学下仍可能需要轻量 dynamics model 或在线状态校正。
7.3 对训练延迟范围的泛化不是无限的
模型只在 \([0,\Delta_{\max}]\) 的 offset 上训练。部署延迟若明显超出范围,或者 \(L\) 抖动很大,视觉陈旧与状态估计误差都会扩大。LIBERO 中 \(\pi_{0.5}\) 在 delay 3 上的轻微下降已经体现了这个趋势。
7.4 Action quantization 不是无损加速
动作量化跳过了中间控制点。对自由空间中的大幅移动,它通常有效;对插入、堆叠、接触丰富或安全敏感的任务,过大的 \(q\) 会降低精度。论文使用 task-dependent \(q\),不能把 \(2\times\) 直接视为所有任务的固定收益。
7.5 “无架构改动、无额外开销”需要准确理解
- future-state-aware inference 本身不要求新增网络模块,状态前推的运行时开销近似可忽略;
- 但模型仍需要 offset fine-tuning,不能把一个未经适配的 VLA 直接换成未来状态就期待稳定工作;
- shared-observation attention 是训练优化,实现时需要支持相应 attention mask;
- \(\pi_{0.5}\) 的真实机器人设置使用了可选 state projection 来改善数值状态建模。
7.6 真实世界评测规模仍有限
一般操作任务每个设置为 20 个 rollout,乒乓球为 20 次发球,打地鼠为 5 轮。结果足以证明方法可以解锁动态任务,但对于长期可靠性、安全性、跨平台延迟抖动和复杂人机交互,仍需要更大规模评估。
8. Conclusion
VLASH 解决的是 VLA 实时部署中一个容易被忽视、却非常根本的问题:异步推理只有在动作与执行时状态对齐时,才会真正转化为稳定的闭环控制能力。
整套方法可以压缩为四步:
- 用 action chunking 让机器人在 VLA 推理时继续执行旧动作;
- 用旧 chunk 中已经提交的动作,将 robot state 前推到新 chunk 的执行起点;
- 用 temporal-offset augmentation 教会 VLA 根据“旧视觉 + 未来本体状态”生成对齐动作;
- 用 shared observation 降低训练重复计算,并按任务需要使用 action quantization 加快物理运动。
最终,VLASH 在不增加推理阶段修正网络或额外生成步骤的情况下,获得了最高 11.8× 的最大反应延迟改善;在 Kinetix 的 4-step delay 下相对 Naive Async 提升 30.5 个成功率百分点;结合动作量化,在真实操作任务上取得约 1.5–2.0× 完成加速,并让 \(\pi_{0.5}\) 实现了同步控制无法完成的乒乓球和打地鼠任务。
更高层的启发是:
对具身模型而言,实时性不只是每秒能跑多少次 forward;它还取决于模型看到的状态、模型规划的时间区间,以及动作真正生效的时刻是否一致。